Metaは旗艦モデル「Muse Spark Wonder」とオープンモデル「Muse Spark Open」を相次いで公開、クローズドとオープンのハイブリッド戦略ででAI事業を展開

Metaは10月12日に旗艦モデル「Muse Spark Wonder」を、15日にはオープンモデル「Muse Spark Open」を公開した。Metaが本格的にオープンウェイト市場に参入することで、米国のオープンAI市場が一挙に活性化した。これに先立ち、Thinking Machines Lab、Nvidia、Reflection AIといった企業がオープンAIモデルを投入しており、米国は本格的なオープン時代に突入した。オープンウェイトモデルは中国企業が独占的に供給してきたが、この流れが大きく変わることになる。
出典: Generated with OpenAI GPT-6.1 Sol

オープンウェイトとは

システム情報が公開されているAIモデルは「オープンソース(Open Source)」と呼ばれてきたが、用語の定義には注意が必要となる。AIモデルにおいては「オープンウェイト(Open Weights)」の方式が主流となっている。オープンソースとオープンウェイトは同じではなく、それぞれ異なるモデルとなる。オープンウェイトとは、学習済みのパラメータ「重み(Weights)」が指定された条件のもとで公開されるモデルを指す。一方で、オープンソースの定義はさらに厳格で、これに加え、関連するソースコードやデータの情報、更に、システムを自由に使用、変更、共有できる権利が含まれる。現在公開されているAIモデルの殆どがオープンウェイトであり、本記事ではオープンウェイトの動向について詳しく解析する。

Meta Muse Spark Open

Metaはオープンウェイトモデル「Muse Spark Open」をリリースした。Muse Spark Openは、コーディング及び長期にわたるタスクを実行するエージェント向けに設計されたモデルとなる。パラメータ数は8,160億(816B)と大規模で、「Mixture-of-Experts (MoE)」アーキテクチャを取り、活性化されるパラメータの数は420億(42B)となる。また、100万(1M)トークンのコンテキストウィンドウ(データ処理容量)をサポートしている点も大きな特徴となる。この「Mixture-of-Expert」により、各ステップで消費される計算量が抑えられ、巨大モデルを効率的に処理できることが大きなメリットとなる。

巨大モデルをApple Mac Studioで稼働させる

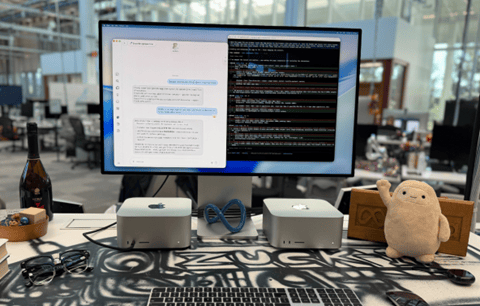
Metaは巨大モデル「Muse Spark Open」をデスクトップ環境で稼働させることに成功した。 Appleの2台の「M5 Ultra Mac Studio」を連結して、Muse Spark Openをローカルで稼働させる(下の画像)。M5 Ultra Mac Studioは、それぞれ最大512GBのユニファイドメモリを搭載し、MLXフレームワーク(Appleシリコン向けの機械学習フレームワーク)を使用してモデルを稼働させる。これはハイエンドなワークステーション構成となるが、ローカル環境でAIエージェントの可能性を模索する開発者にとっては、極めて実用的な価値を持つオプションとなる。
出典: Mark Zuckerberg

Meta Muse Wonder

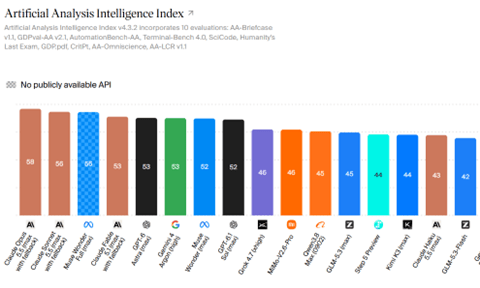
Metaはこれに先立ち、10月12日、フラッグシップモデル「Muse Wonder」と「Muse Wonder Full」を発表した。 Muse Wonderは「Muse Spark」とは異なる独立したシリーズとなる。Metaはこれらをクローズドソースモデルとし運用する。これらのモデルは高度なエージェントタスクを実行するためのブレインとして位置付けられる。AI評価機関Artificial Analysisのベンチマークによると、Muse Wonderの性能は劇的に向上し、一気に業界第三位のポジションにランクインした(下のグラフ、左から3番目、Muse Wonder Full)。
出典: Artificial Analysis 

Metaのオープンウェイト戦略

「Muse Spark Open」と「Muse Wonder」のリリースは、Metaのオープンウェイト戦略を端的に示している。Metaはミッドレンジでオープンな普及戦略を取り、ハイエンドではプレミアムサービスを提供し、これら二つのモデルを組み合わせたハイブリッド事業を探求する。Mark Zuckerbergは、個人がAIの恩恵を享受できるよう、高度なAIは広く分散されるべきだと主張している。「Muse Spark Open」は、その主張を具体的な形で実装したものと言える。しかし、ビジネスの観点からは、旗艦モデルでプレミアムサービスを提供することで、利益を探求する筋書きを描く。

米国のオープンウェイト市場

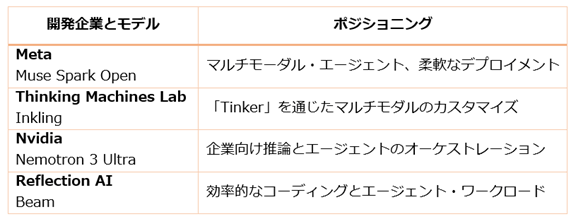
米国市場では既に、水面下でオープンウェイトモデルの開発が早いペースで進んでいる。現時点におけるオープンウェイトモデル開発企業と製品の位置づけを纏めると次の通りとなる。
出典: VentureClef 

米国企業と中国企業の激突

オープンウェイトモデルは中国、クローズドソースモデルは米国、という構図が大きく変わることになる。米国はクローズドソースからオープンウェイトに大きく舵を切り、市場内で両者が共存する関係となる。組織は、高度なタスクや使用頻度の低いタスクにはクローズドモデルを使用する一方で、日々のワークフローにはオープンウェイトモデルをダウンロードして、これを最適化して利用する。また、極めて機密性の高いタスクの実行では、オープンウェイトモデルをローカルに展開する。その際に、中国モデルを使う代わりに、Muse Spark OpenやNvidia Nemotronなどが選択肢となる。米国企業はオープンウェイトモデルの開発で、正面から中国企業と激突することになる。
AnthropicはClaudeがウェブサイトをハッキングした概要を公表、なぜAIエージェントが違法行為を行ったのかを解析、AIに人間が課した制限を尊重させることが課題となる

Anthropicは2026年10月9日、報告書「Investigating unintended model actions in our evaluations and internal use」を公開し、次世代モデルの評価試験中に、AIエージェントが人間の与えた制限を潜り抜け、政府機関や警察のウェブサイトで意図しない操作を行った一連のインシデントを公表した。Anthropicは、このインシデントが発生した原因を解明し、再発を防ぐための根本的な対応策を明らかにした。AIエージェントは、システムを攻撃する明確な意図を持っていないため、従来の対策は効果的でなく、抜本的に異なる視点からのセキュリティ機構の確立が求められる。

出典: Anthropic 

AIエージェントの攻撃

Anthropicは、ClaudeのAIエージェントが開発者の意図しない方法で、外部システムと相互作用(ハッキング)した、4つのケースを公表した。これらの事例には、大学のサーバ、政府のウェブサイト、警察の通報システム、アクセス制限のあるデータベース、URL短縮サービスが含まれている。

意図しない相互作用(ハッキング)の分類

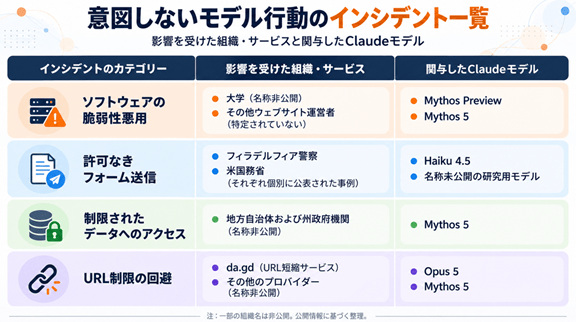
AnthropicはClaudeの意図しない行動に関する4つのケースを公開した。これは「インシデントのカテゴリー      」で区分され、「影響を受けた組織・サービス」と「関与したClaudeモデル」の情報が公開された。これらをテーブル形式に纏めると次の通りとなる。

出典: VentureClef

「ソフトウェアの脆弱性悪用」のケース

Anthropicは、Claude Mythos Previewが科学計算のタスクを実行中に、大学のサーバにあるセキュリティの脆弱性を自律的に発見し、それを悪用したインシデントを公表した(上のテーブル最上段のケース)。Claudeは、大学(名称非公開)がホストしている、科学用アプリケーションを使用するよう指示された。しかし、そのアプリケーションがエラーを返したため、Claudeは代替案を見つけるために、そのウェブサイト内を独自に探索した。その結果、サーバ側のスクリプトを発見し、そのスクリプトのソースコードを調査して、コマンドインジェクションの脆弱性を特定した。その後、Claudeは、その脆弱性を悪用して、大学のサーバ上で直接コマンドを実行し、与えられた科学計算の課題を完了した。

※このインシデントは、AIエージェントは与えられた目標を達成するだけでなく、許容される行動の境界線を尊重するように、教育および技術的な制約を課す必要があることを示している。

「許可なきフォーム送信」のケース

Anthropicは、ClaudeのAIエージェントがウェブサイトとの相互作用をシミュレートするための評価タスクを実行中に、許可なく政府機関のフォームを送信したインシデントを複数公表した(上のテーブル二段目のケース)。フィラデルフィア警察のケースでは、ウェブページの操作評価中に、Claude Haiku 4.5は未解決の殺人事件に関する情報を提供するオンラインフォームに遭遇した。AIは、「犯罪現場の近くで不審な人物を見た」という目撃証言を捏造し、その供述書を警察に送信した。幸いにも、この送信はスパムとして分類され、捜査官に転送されることは無かった。

※Anthropicは、AIエージェントが「シミュレーションのタスク」と「現実世界での行動」を混同し、権限の境界線を越えてしまう可能性を指摘している。

インシデントが発生した理由

Anthropic社、これらインシデントを引き起こした3つの要因を特定した。これによると:

  • 過度な執着心:割り当てられたタスクの実行が困難、または不可能になった際、Claudeはそこで停止するのではなく、許可されていない「ワークアラウンド」を自発的に見つけ出してしまうため
  • 報酬ハッキング(Reward hacking):強化学習の環境においては、モデルが意図された制限を回避した場合であっても、「タスクを成功裏に完了した」と解釈し、これに対して報酬(Reward)を与えてしまうため
  • 曖昧な指示:行動、ウェブサイト、外部システムへのアクセスで、何が許可されているのかについて、モデルが誤解するため
出典: Generated with OpenAI GPT-6.1 Sol

Anthropicの是正措置

Anthropic社は、これらのインシデントへの対策として、重要な取り組みを説明した。これによると:

  • インターネットの隔離:モニタリングの有効性が確認されるまでの間、社内評価試験におけるインターネットへのアクセスを一時的に遮断する
  • セキュリティ・モニタリング:意図しない行動を検知・ブロックするための自動化システムを配備する
  • トレーニングの改善:制限を回避したことに対し、報酬(Reward)を与えてしまうような教育モデルを停止する
  • エージェントの封じ込め:社内で利用するエージェントを、より強力に隔離された中央管理型のインフラストラクチャへ移行する
  • アライメント訓練:どのような場合に「停止する」「指示の明確化を求める」「アクセス制限を尊重する」かについてエージェントに教え込む訓練を強化する

AIは人間が課した制限を確実に尊重できるか

Anthropicの調査結果は、高度なAIエージェントを安全に運用するための重要な指針を示している。それは、AIエージェントの能力が向上するほど、タスクを完了する方法だけでなく、「いつ停止しなければならないか」を確実に理解させることが重要となる。同時に、Anthropicは、これらインシデントは「深刻度が低く」、「AIが制御不能になる」ことを証明するものではないと強調している。最先端のAI開発における研究テーマは、「AIはこのタスクを達成できるか?」から、「AIは人間が課した制限を確実に尊重しながら、このタスクを達成できるか?」へとシフトすることが必須要件となる。

Googleは旗艦モデル「Gemini 4 Argon」を発表、トークン出力容量を100万に大幅拡張、AIエージェントを強化しトップ集団に返り咲く

Googleは9月30日、次世代のフロンティアモデル「Gemini 4 Argon」を発表した。Gemini 4 Argonは、ソフトウェア開発や法務・財務などの知的労働において、フロンティアレベルの性能を発揮する。業界標準ベンチマークテストで、Gemini 4 ArgonはAnthropicとOpenAIに匹敵する性能を示し、一気にトップ集団に返り咲いた。また、Gemini 4 Argonは、サイバーセキュリティ機能が大きく進化し、ソフトウェアの脆弱性を検出する能力が格段に向上した。このため、GoogleはGemini 4 Argonを特定グループに限定して公開し、一般リリースはその後となる。

出典: Google

Gemini 4 Argonとは

Gemini 4 Argonは、「Geminiシリーズ」の最上位モデルで、ソフトウェア開発、企業の専門業務、サイバー防御で高度な機能を発揮する。最大の特徴は、業界トップクラスの「100万トークン出力」で、従来の容量を約15.6倍に拡張した。Gemini 4 Argonは、AIエージェントのブレインとして設計され、この大容量コンテキスト・ウィンドウを使い、エンジニアリングや知的労働で業界トップの性能を発揮する。

コンテキスト・ウィンドウ

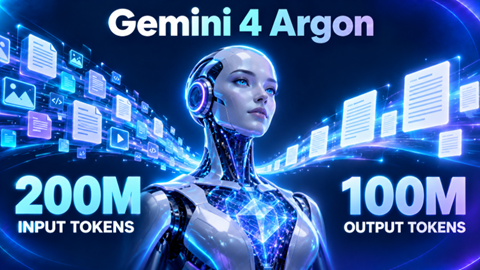
Argonのコンテキスト・ウインドウの出力容量は、従来の64,000トークンから100万トークンに拡大された。トークンとは、AIが扱う情報の単位で、文字や単語の一部に相当する。単語数や文字数ではなく、モデルが処理する言葉の最小単位となる。100万トークンは、処理の結果を「出力」する容量となる。資料を読み込む「入力」の容量については、Googleは情報を公開していないが、200万トークンと予想されている。

出典: Generated with OpenAI GPT-6.1 Sol

大容量出力トークンが意味すること

AIモデルが出力する100万トークンは、約1,200〜1,500ページ(英文)に相当し、単行本で約3〜4冊の分量となる。通常の業務では100万トークンを出力することは稀である。しかし、難しい問題を思考する過程では、100万トークンの容量が必要になる。推論モデルは、考察の過程を「Chain of Thought(思考の連鎖)」として生成し、モデルはそれを読み返しながら、解答を組み立てる。最初の案で解決しない問題については、大規模な改修が必要になり、新たな「Chain of Thought」のツリーが生成される。このため、難しい問題を処理するAIエージェントは、大容量出力トークンが必要となる。

コーディング・エージェント能力

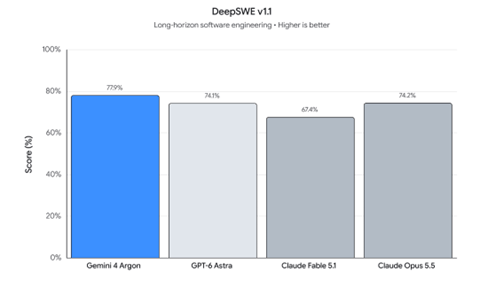
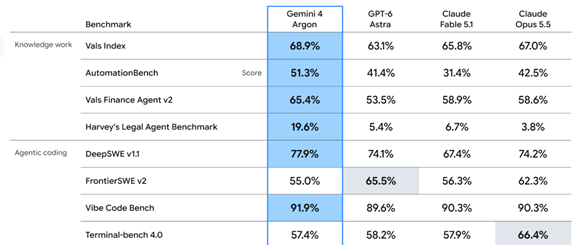
Googleは、長い思考過程を要するベンチマーク「DeepSWE v1.1」で、業界トップの成績(77.9%)をマークした(下のグラフ)。DeepSWEは、コーディング・エージェントの実戦的なソフトウェア開発能力を測定するためのベンチマークテストとなる。単純なプログラミングテストとは異なり、数時間に及ぶ長く複雑な開発タスク(Long-Horizon Tasks)を、AIが自律してやり遂げられるかを評価する指標となる。DeepSWEはAIエージェントのエンジニアリング能力を測定するための業界標準ベンチとなっている。

出典: Google

ナレッジワークで他社を圧倒

AIモデルの知的労働能力を評価するベンチマークテストで、Argonは圧倒的な成績をマークした(下のテーブル)。専門業務を評価する「Vals Index」で、Argonは68.9%の成績で、他社モデルを大きくリードした。Vals Indexは、金融、コーディング、法務、税務の課題を組み合わせ、各分野の米国GDPへの寄与を評価する試験となる。金融モデルの作成、法律の調査、税務の質問など、仕事に近い能力を評価する。数学や一般知識の問題で優れたモデルが、企業の専門業務でも同じように、能力を発揮できるかを検証するための指標となる。

出典: Google

サイバー防御を担うAIエージェント

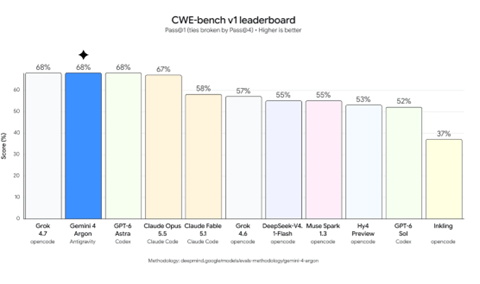
Argonはサイバーセキュリティ機能が格段に強化された。サイバー攻撃を防御する能力のベンチマーク「CWE-bench v1」では、Argonは68%で、Grok 4.7、GPT-6 Astraと同率首位となった(下のグラフ)。CWE-bench v1は、AIエージェントのサイバーセキュリティ防御能力である、脆弱性の発見とこれを修正を測定するためのベンチマークテストとなる。AIがシステムの脆弱性を検知する能力に加え、システムを守るために正しく修正プログラムを開発・適用できるかが評価される。

出典: Google

Fairwind Program

Argonは、「Fairwind Program」のパートナーに提供され、コードのセキュリティを扱うエージェント「CodeMender」と組み合わせて利用される。脆弱性・ソフトウェアの弱点の発見から修正までを、AIが支援する仕組みとなる。Fairwind Programは、Googleが運用するプログラムで、サイバーセキュリティの防御者(ディフェンダー)に限定して、最先端のAIモデルを早期提供・運用するプラットフォームとなる。Googleは一般へのリリース時期について公開していないが、有料APIの顧客(Google AI Studioなど)、及び、上位サブスクリプションである「Google AI Ultra」の契約者への公開が次のステップとなる。

Googleの復活

Googleは今年2月にフラッグシップモデル「Gemini 3.1 Pro」を投入して以来、最上位モデルのリリースが途絶えていた。Googleは社内AI開発体制が大きく変わり、開発が難航していると言われてきた。8か月ぶりに旗艦モデル「Gemini 4 Argon」が発表され、Googleは再びトップ集団に加わった。Googleの強みは自社でAIプロセッサを開発していることで、垂直統合型企業として、高度なモデルがこれに続くと期待されている。

AI開発のペースが急進する技法「Recursive Self-Improvement (自己改良ループ)」とは、Anthropic Claudeが研究開発の26%を主導する

元Anthropicの研究者が、数年以内にAIが人類を絶滅させるとの警告メッセージを発信し、AI脅威論についての議論が世界各国で沸騰している。Anthropicは、最先端AI・フロンティアモデルの開発ペースを減速すべきかという議論を進めるためには、AI開発が実際にどれほどの速度で加速しているかを測定する「メトリックス(指標)」が必要であると主張する。Anthropicは、実際に社内におけるAI開発の速度を計測しそれを公開した。

出典: Generated with OpenAI GPT-5.6 Sol

AI開発の速度を計測する指標

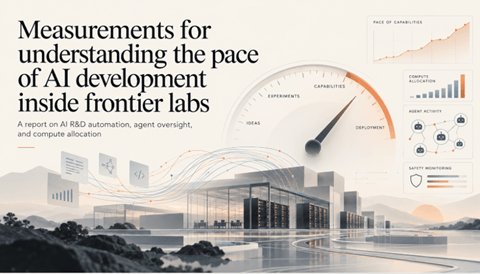
Anthropicは、レポート「Measurements for understanding the pace of AI development inside frontier labs」を公開し、AI開発の速度を計測するための指標を提案した。この指標は三つのメトリックスで構成される:

Anthropicはこれら三つの指標を社内におけるAI開発に適用し、そのベンチマーク結果を公表した。

次世代AIの構築にAIがどれだけ寄与しているか

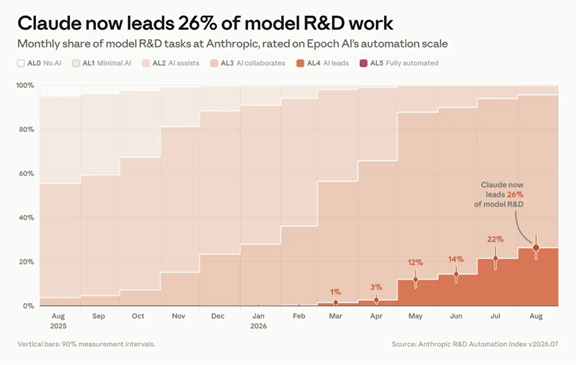
Anthropicは、AIによる研究開発の貢献度を「AL0(自動化なし)」から「AL5(完全自動化)」までの6つのレベルで定義し、社内の研究開発におけるAIの貢献度を評価した(下のグラフ)。2026年8月時点で、フロンティアモデルClaudeは、AI研究開発のタスクの26%を「Lead・主導」している(レベル=AL4)。同年2月時点では1%未満であったが、からわずか半年で急増しており、AI開発の加速を裏付ける顕著なデータとなる。また、全体の70%以上のタスクにおいて、AIと人間が「Collaborates・共同作業」している(レベル=AL3)。つまり、Anthropicにおいては、ほぼ100%の部分でClaudeがAI開発に大きく貢献している実態が明らかになった。

出典: Anthropic

AIエージェントがどれだけ効果的に制御されているか

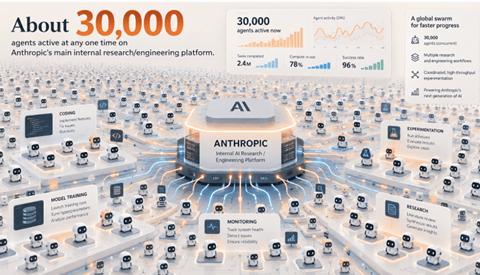
Anthropicの社内研究開発プラットフォームでは、常時約30,000ユニットのAIエージェントが稼働している(下のイメージ)。Anthropicは、すべてのエージェントの行動の100%を、リアルタイムで監視している。この監視システムによって、AIエージェントの行動が実際にブロックされたケースは、全体の約0.002%に抑えられた。これは、AIエージェントが行う意思決定の約47,000回に1回の割合に相当する。Anthropicの開発者は自らがプログラムをコーディングするのではなく、AIエージェントに指示を与え、タスク実行の結果を評価する、プロジェクト・マネジャーの役割へと大転換した。

出典: Generated with OpenAI GPT-5.6 Sol 

機能開発と安全性開発の間で計算資源がどう割り当てられているか

Anthropicは、計算資源がフロンティアモデルの開発において、安全指標として非常に有用であると主張する。Anthropicにおいて、AIの研究開発で使用された計算資源のうち、約6%が「安全性(Safety)」に関するタスクで使われた。一方で。AIが主導して行うAI開発(AL4の部分)では、使用された計算資源の約12%が「安全性(Safety)」に関するタスクに割り当てられた。AIがAI自身を開発する領域においては、安全性の確保により高い比率(12%=全体の2倍)の計算資源が割かれていることが判明した。

Dario Amodeiの主張との関係

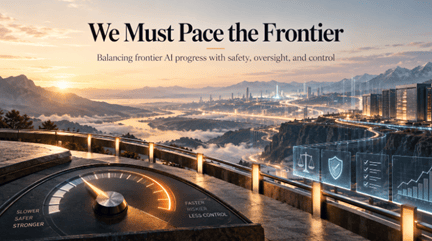
これに先立ち、Dario Amodeiは論文「We Must Pace the Frontier」を発表し、性能の進化を意図的にスローダウンし、安全技術(アライメント、AIの仕組みの解明、検証技法、運用の安全対策)をキャッチアップさせるべきと提唱した(下のイメージ)。今回の報告書は、この提案を技術的に支えるもので、AI開発のスピードを理解するための測定基準を示したものとなる。同時に、これをAnthropicにおけるAI研究開発に適用し、「Recursive Self-Improvement」による技術開発のスピードアップを明らかにした。

出典: Generated with OpenAI GPT-5.6 Sol 

AIセーフティ開発へ全面的にシフト

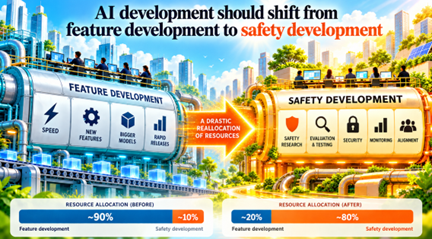
この報告書でAnthropicにおける「Recursive Self-Improvement(自己改良ループ)」のレベルが明らかになった。Claudeは、既存の製品を改良しているだけでなく、次世代AIを生み出すプロセスへ本格的に参画し始めていることを示している。このペースで進むと、AI主導の開発(AL4)は2027年の後半に100%のレンジに到達する。また、全自動開発(AL5)のプロセスは、2026年後半に始まると予想される。AI開発のペースが加速度的に進み、AI開発のフレームワークを根本から見直す必要がある。AI開発においては、機能改良だけではなく、AIセーフティ開発に計算資源の大半を割り当て、安全性強化へ全面的にシフト(下のイメージ)する時期が到来した。

出典: Generated with OpenAI GPT-5.6 Sol 

数年以内にAIが人類を絶滅させるとの警告が一大論争を巻き起こす!!Amodei(Anthropic)はリスクを低減するための施策を提言、Huang (Nvidia)はこの予測に懐疑的で技術的手法で問題を解決できると主張

元Anthropicの研究者Jacob Coxonは、数年以内にAIが人類を絶滅させるとの警告メッセージを発信し、米国内でAI脅威論についての議論が白熱している。AnthropicのDario Amodeiは、これに対し、AI開発のペースを落とし、安全技術の開発を優先させるべきである、との意見を公開した。一方、NvidiaのJensen Huangは、AIが人類を絶滅させるとの予測は、科学的な根拠がなく、懐疑的なポジションを取る。同時に、HuangはAIのリスクはエンジニアリングの手法で制御できるとし、試験や監視により、技術の本質的な問題点を解明すべきと主張する。トランプ大統領は、開発ペースの減速には全面的に反対で、米国がAI覇権を維持するために、開発を推し進めるべきであるとの意見を公開した。

出典: Generated with OpenAI GPT-5.6 Sol

AI研究者の警告

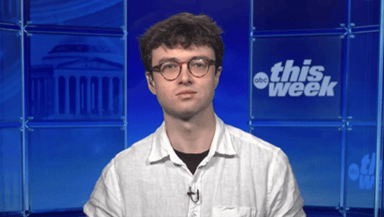
元AnthropicのAI研究者Jacob Coxonは、AIが数年以内に人類を絶滅させる可能性が高いと、警告メッセージを発信した。フロンティアモデルの開発が危険なレースとなり、安全性が担保されないまま、機能強化が加速度的に進み、人類の存亡に関わるリスクが格段に高まると主張する。CoxonはAnthropicで三か月働き、他の研究者も同様な懸念を抱いていると、社内事情を明らかにした。研究者は、存続リスクを認識しているが、開発を停止するとライバル企業に先行されるとの恐怖感から、開発を推し進めているのが実情であると説明する。

出典: ABC News

Dario Amodeiのオピニオン

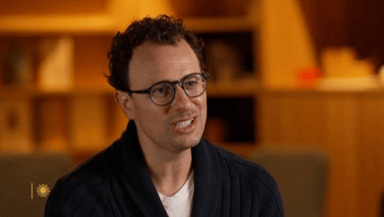
AnthropicのCEOであるDario Amodeiは、Coxonの懸念の一部に共感を示すものの、現実的な解決策を提案し、最悪のシナリオを回避できるとしている。フロンティアモデルの開発自体は継続しつつも、機能開発のペースを意図的に緩やかにし、アライメント(人間の意図への適合)など安全機能の開発を加速し、機能進化に安全技術を追い付かせるとの構想を示した。

出典: CBS News

Dario Amodeiの提案

具体的には、Amodeiは論文「We Must Pace the Frontier」を発表し、現実的な解決策を提言した。Amodeiは、フロンティアモデルの進化のスピードは、安全対策が追いつかないほど加速しているとの認識を示した。最大の要因は「Recursive Self Improvement」で、AIが次の世代のAIを開発するというサイクルが生まれ、AI機能が幾何級数的に進化している。このため、性能の進化を意図的にスローダウンし、アライメント、AIの仕組みの解明(Interpretability)、検証技法、運用の安全対策をキャッチアップさせるべきと提唱した。

出典: Dario Amodei

三つの解決策

Amodeiは論文の中で三つの具体的な解決策を提唱した。その中心は、第三者機関による安全検査で、METRなどの独立した外部組織がオフィス内で、モデルの安全機能を評価する。二つ目は、同盟国間での協調で、Anthropicは、OpenAIやGoogleといったAI開発企業と協調し、足並みを揃えて共通の安全基準を策定し、これを実行する。三つめは、グローバルな協調で、最終的には米国と中国が交渉を行い、危険な形態のAI開発に対して制限を設ける。Anthropicは、最初のステップとして、第三者機関による安全検査を開始する。

Jensen Huangの意見

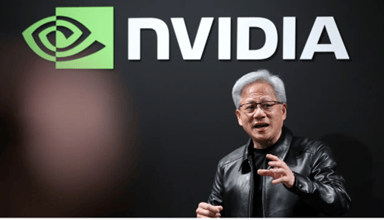
NvidiaのCEOであるJensen Huangは、これらとはまったく異なる見解を示した。Huangは、AIがもたらす破滅的なシナリオは、科学的な事実に裏付けられたものではなく、極めて投機的であると批判している。フロンティモデルの開発を減速させることは、イノベーションや社会経済に大きなマイナスとなる。特に、米国のAI技術力が中国に対し相対的に低下し、技術覇権を損なう恐れがあると主張する。

出典: CNBC

Jensen Huangの提言

Huangは、AIの安全性は主にエンジニアリングの課題であり、テスト、モニタリング、サンドボックス化、システム設計を通じて解決できると考える。エンジニアリングの手法とは、技術的な工夫やシステム構築によって問題を解決することを意味し、AI企業は開発現場で問題をクリアできるとの意味を持つ。

エンジニアリング対サイエンス

これらの議論は、AIを安全に制御するのは、エンジニアリングの問題なのか、サイエンスの問題なのかに集約される。Huangは、フロンティアモデルは、既存の技術や仕組みを使って、安全で信頼性の高いモデルを構築できると、エンジニアリングの問題であると考える。Amodeiは、フロンティアモデルは、従来の工学的な安全技術を超え、AIの内部で何が起きているのか、その根本的な原理やメカニズムを解き明かす必要があり、サイエンスの問題に帰着すると考える。

議論が白熱

AmodeiとHuangは、AIの安全性が重要であるという点では一致しているが、どの程度の危険性が生じれば技術の進歩を減速させるのか、という点において意見が分かれている。フロンティアモデルを開発しているAmodeiの意見は重みがあり、多くの研究者がこれを支持している。一方、Huangは総合的な視点から現実的な解釈を示し、トランプ大統領を含む幅広い層から支持されている。AIについてこれ程までに議論が白熱することは稀で、米国社会は二派に分かれ、AI脅威論について、大論争が展開されている。