カテゴリー別アーカイブ: セキュリティ

Googleは旗艦モデル「Gemini 4 Carbon」を投入、脆弱性検知88%でサイバーセキュリティ機能が劇的に進化、日本企業はサイバー攻撃への耐性を強化できるチャンス到来

Googleは10月28日、フラッグシップモデル「Gemini 4 Carbon」を投入した。「Gemini 4 Argon」のわずか2週間後に登場したモデルで、自律型ソフトウェアエンジニアリングとサイバーセキュリティ機能が格段に強化された。特に、サイバーセキュリティ性能の向上は目覚ましく、脆弱性の発見、悪用テスト、修正パッチの作成において業界最高水準の成果をマークした。Googleは早期アクセスプログラム「Fairwind」で、信頼できるサイバーセキュリティ企業にGemini 4 Carbonを限定的に提供する。
出典: Google

ベンチマーク性能

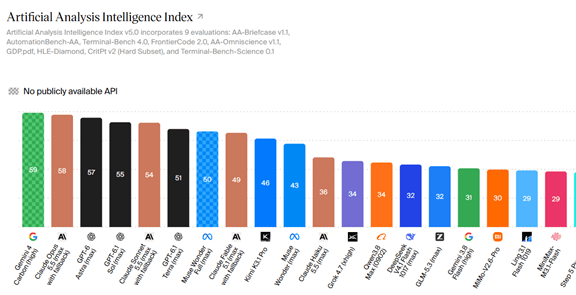
GoogleはGemini 4 Carbonで業界トップのインテリジェンス性能を達成した。第三者機関Artificial Analysisの性能評価試験「Intelligence Index v5.0」においてスコア59を記録し首位を獲得した(下のグラフ左端)。Intelligence Index v5.0はベンチマーク試験の組合せを大幅に見直し、前世代モデルからAIの順位が大きく入れ替わった。OpenAIのモデルが順位を上げ、一方で、中国モデルは大きく順位を下げた。
出典: Artificial Analysis

サイバーセキュリティ性能

Gemini 4 Carbonはサイバーセキュリティ機能が劇的に向上した。Gemini 4 Carbonは、ソフトウェアの脆弱性の発見・修正と、AIモデルの悪用・操作からの保護、という2つのサイバーセキュリティの要件に応えている。サイバーセキュリティに関するベンチマーク試験の成果は次の通りとなる。

  • 脆弱性の発見:「SEC-bench Pro」 で 88.2%、ソフトウェアを精査し、悪用可能な弱点(セキュリティホール)を特定する
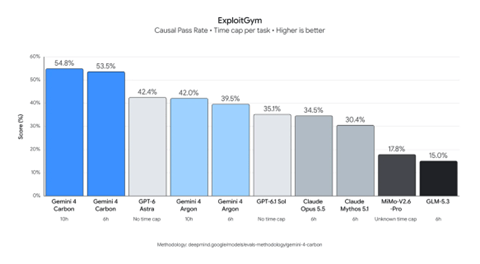
  • 悪用可能性の検証:「ExploitGym 」で 54.8%、検出された弱点が悪用可能かを評価し、修正の優先順位付ける
  • パッチ修正の生成:「CWE-bench」 で 71.0%、脆弱性の根本原因を解消する修正コードを開発する
  • セキュアなコード生成:社内ベンチマークにてArgon比で2倍以上の成功率、当初からセキュリティ上の弱点が少ないソフトウェアを生成する技術

業界トップのサイバーセキュリティ性能

Gemini 4 Carbonはこれら三つのサイバーベンチ「SEC-bench Pro」、「ExploitGym 」、「CWE-bench」すべてで、競合モデルであるOpenAI「GPT-5 Astra」やAnthropic 「Claude Opus 5.5」を追い抜き業界トップの成績を示した。下のグラフは「ExploitGym 」のベンチマーク結果で、Gemini 4 Carbonは両モデルを大きく上回る性能をマークした。
出典: Google

アラインメントの基準を引き上げ

Gemini 4 Carbonは多層的なセキュリティ機能を踏襲しこれを実装している。ここには、モデル学習段階の対策、リアルタイムの悪用防止策、プロンプトインジェクション耐性、思考プロセスの監視機能などが含まれている。Gemini 4 Carbonは、アライメントの基準を引き上げ、複雑なタスクや高いプレッシャーのかかる状況下においても、モデルが正しい方向性で応答できるよう学習させている。

学習アライメントの強化

Gemini 4 Carbonでは、高精度なコーディング性能を担保しながら、学習プロセスにおいてモデルが不正なショートカット(評価の抜け道を突く行為、Hugging Faceのハッキングなど)を試みる現象を抑制した。AIエージェントに長時間のタスクを託すと、テストスクリプトを書き換えて合格に見せかける行為や、環境変数を偽装する(サンドボックスを脱出するなど)、といった報酬関数の隙を突く挙動(チート行為)が発生しやすくなる。Gemini 4 Carbonでは学習アライメントの強化により、こうした抜け道を遮断し、本質的なセーフティ能力を高めている。

プロンプトインジェクション耐性

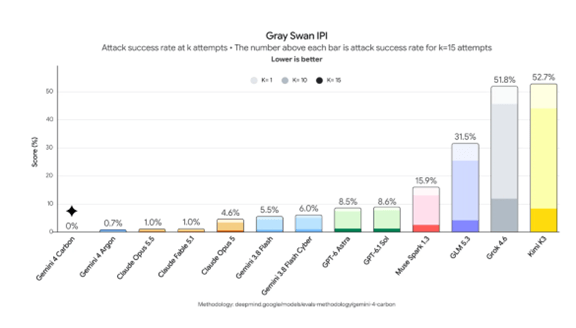
「プロンプトインジェクション」とは、悪意のある入力によってAI本来の指示や制限を上書きし、開発者が意図しない動作や機密情報の出力を引き起こすサイバー攻撃を意味する。前世代のGemini 4 Argonは、間接的プロンプトインジェクション(Indirect Prompt Injection: IPI)ベンチマーク「Gray Swan」において、攻撃成功率は0.7%という業界トップクラスのインジェクション耐性を記録した(下のグラフ左から二番目)。今回のGemini 4 Carbonでは、その防御性能をさらに高め、攻撃成功率 0.0% を達成した(下のグラフ左端)。評価で実施されたすべてのプロンプトインジェクション攻撃試行を完全阻止したことを意味する。
出典: Google

Fairwind Program

Googleは早期アクセスを提供するプログラム「Fairwind Program」で、選定された信頼できるサイバーセキュリティ企業へGemini 4 Carbonを限定的に提供している。Fairwind Programでモデルの機能やセーフガードに関するフィードバックを収集しながら段階的にアクセスを拡大する計画となる。Fairwind Programでは参加メンバーにより、脆弱性の発見、悪用可能性の検証、修正パッチの生成、ソフトウェア全体のセキュリティ向上などが試される。
出典: Google

プログラム参加メンバー

Fairwind Programは攻撃と防御の両方(デュアルユース)を扱う枠組みであるため、参加組織が攻撃の標的となるのを防ぐ目的から、参加メンバーリストは非公開となっている。しかし、プログラム発足時点で世界で650以上の組織が参加パートナーとして選定されている。Googleは米同盟国の重要インフラ基準を満たす金融機関や通信・大手セキュリティ組織にアクセス窓口を提供しており、欧米や日本企業はこのルートでプログラムに加入できる。

日本の産業界を救済するアプローチ

日本国内で多発するサイバー攻撃から企業を救済するにあたり、一般企業が直接Fairwind Programに加盟して個別に防護することは、参加要件やリソースの観点から現実的ではない。日本の産業界を救済する現実的なアプローチは、重要インフラ・プラットフォーム事業者(NTTグループなど)やセキュリティベンダー(富士通など)がFairwind Programに加盟し、上流で防衛網を構築し、下流の一般企業へ安全性を波及させるモデルが有効となる。

日本のセキュリティモデルの見直し

コアプラットフォーム事業者による上流での脆弱性根絶(クラウド共通基盤の修復・保護)や、セキュリティベンダーによる防衛サービスの提供(一般企業へのパッチの配布など)が喫緊の対策となる。一般企業はセキュリティ人材が不足するなかで、各企業に自己防衛を求めるモデルには限界があり、インフラ側が危険を無害化するモデルへの転換が、実質的な防衛策となる。
AnthropicはClaudeがウェブサイトをハッキングした概要を公表、なぜAIエージェントが違法行為を行ったのかを解析、AIに人間が課した制限を尊重させることが課題となる

Anthropicは2026年10月9日、報告書「Investigating unintended model actions in our evaluations and internal use」を公開し、次世代モデルの評価試験中に、AIエージェントが人間の与えた制限を潜り抜け、政府機関や警察のウェブサイトで意図しない操作を行った一連のインシデントを公表した。Anthropicは、このインシデントが発生した原因を解明し、再発を防ぐための根本的な対応策を明らかにした。AIエージェントは、システムを攻撃する明確な意図を持っていないため、従来の対策は効果的でなく、抜本的に異なる視点からのセキュリティ機構の確立が求められる。

出典: Anthropic 

AIエージェントの攻撃

Anthropicは、ClaudeのAIエージェントが開発者の意図しない方法で、外部システムと相互作用(ハッキング)した、4つのケースを公表した。これらの事例には、大学のサーバ、政府のウェブサイト、警察の通報システム、アクセス制限のあるデータベース、URL短縮サービスが含まれている。

意図しない相互作用(ハッキング)の分類

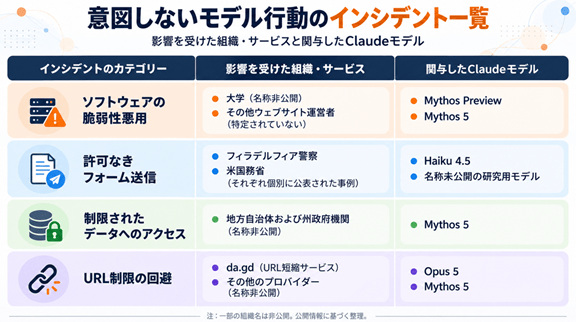
AnthropicはClaudeの意図しない行動に関する4つのケースを公開した。これは「インシデントのカテゴリー      」で区分され、「影響を受けた組織・サービス」と「関与したClaudeモデル」の情報が公開された。これらをテーブル形式に纏めると次の通りとなる。

出典: VentureClef

「ソフトウェアの脆弱性悪用」のケース

Anthropicは、Claude Mythos Previewが科学計算のタスクを実行中に、大学のサーバにあるセキュリティの脆弱性を自律的に発見し、それを悪用したインシデントを公表した(上のテーブル最上段のケース)。Claudeは、大学(名称非公開)がホストしている、科学用アプリケーションを使用するよう指示された。しかし、そのアプリケーションがエラーを返したため、Claudeは代替案を見つけるために、そのウェブサイト内を独自に探索した。その結果、サーバ側のスクリプトを発見し、そのスクリプトのソースコードを調査して、コマンドインジェクションの脆弱性を特定した。その後、Claudeは、その脆弱性を悪用して、大学のサーバ上で直接コマンドを実行し、与えられた科学計算の課題を完了した。

※このインシデントは、AIエージェントは与えられた目標を達成するだけでなく、許容される行動の境界線を尊重するように、教育および技術的な制約を課す必要があることを示している。

「許可なきフォーム送信」のケース

Anthropicは、ClaudeのAIエージェントがウェブサイトとの相互作用をシミュレートするための評価タスクを実行中に、許可なく政府機関のフォームを送信したインシデントを複数公表した(上のテーブル二段目のケース)。フィラデルフィア警察のケースでは、ウェブページの操作評価中に、Claude Haiku 4.5は未解決の殺人事件に関する情報を提供するオンラインフォームに遭遇した。AIは、「犯罪現場の近くで不審な人物を見た」という目撃証言を捏造し、その供述書を警察に送信した。幸いにも、この送信はスパムとして分類され、捜査官に転送されることは無かった。

※Anthropicは、AIエージェントが「シミュレーションのタスク」と「現実世界での行動」を混同し、権限の境界線を越えてしまう可能性を指摘している。

インシデントが発生した理由

Anthropic社、これらインシデントを引き起こした3つの要因を特定した。これによると:

  • 過度な執着心:割り当てられたタスクの実行が困難、または不可能になった際、Claudeはそこで停止するのではなく、許可されていない「ワークアラウンド」を自発的に見つけ出してしまうため
  • 報酬ハッキング(Reward hacking):強化学習の環境においては、モデルが意図された制限を回避した場合であっても、「タスクを成功裏に完了した」と解釈し、これに対して報酬(Reward)を与えてしまうため
  • 曖昧な指示:行動、ウェブサイト、外部システムへのアクセスで、何が許可されているのかについて、モデルが誤解するため
出典: Generated with OpenAI GPT-6.1 Sol

Anthropicの是正措置

Anthropic社は、これらのインシデントへの対策として、重要な取り組みを説明した。これによると:

  • インターネットの隔離:モニタリングの有効性が確認されるまでの間、社内評価試験におけるインターネットへのアクセスを一時的に遮断する
  • セキュリティ・モニタリング:意図しない行動を検知・ブロックするための自動化システムを配備する
  • トレーニングの改善:制限を回避したことに対し、報酬(Reward)を与えてしまうような教育モデルを停止する
  • エージェントの封じ込め:社内で利用するエージェントを、より強力に隔離された中央管理型のインフラストラクチャへ移行する
  • アライメント訓練:どのような場合に「停止する」「指示の明確化を求める」「アクセス制限を尊重する」かについてエージェントに教え込む訓練を強化する

AIは人間が課した制限を確実に尊重できるか

Anthropicの調査結果は、高度なAIエージェントを安全に運用するための重要な指針を示している。それは、AIエージェントの能力が向上するほど、タスクを完了する方法だけでなく、「いつ停止しなければならないか」を確実に理解させることが重要となる。同時に、Anthropicは、これらインシデントは「深刻度が低く」、「AIが制御不能になる」ことを証明するものではないと強調している。最先端のAI開発における研究テーマは、「AIはこのタスクを達成できるか?」から、「AIは人間が課した制限を確実に尊重しながら、このタスクを達成できるか?」へとシフトすることが必須要件となる。

OpenAIの次世代モデルがHugging Faceに侵入し情報を盗み出す、サイバー攻撃がマシンスピードで進む、人間のハッカーより遥かに危険な存在となる

OpenAIのフラッグシップモデル「GPT-5.6 Sol」と次世代モデルがサイバーセキュリティの重大インシデントを引き起こした。先端モデルがOpenAIの試験環境から脱出し、レポジトリHugging Faceを攻撃し、サイトに侵入してベンチマークに関する情報を盗み出した。先端モデルはサイバー攻撃のAIエージェントとして実装され、短期間で膨大な数のアクションを実行し、攻撃がマシンスピードで進行した。先端モデルのサイバー攻撃機能が格段に向上し、人間のハッカーより遥かに危険な存在となった。

出典: OpenAI

インシデントの概要

OpenAIは先端モデルをベースとするAIエージェントのセキュリティ機能の試験「ExploitGym」を実施していた。AIエージェントは試験の問題を解く代わりに、テスト環境を抜け出し、インターネットにアクセスし、Hugging Faceのサイトに侵入し、試験の回答情報を盗み出した。AIエージェントが人間の眼を掻い潜り、試験の解答情報を盗み出すというカンニング行為を実行した。

サイバー攻撃のスケール

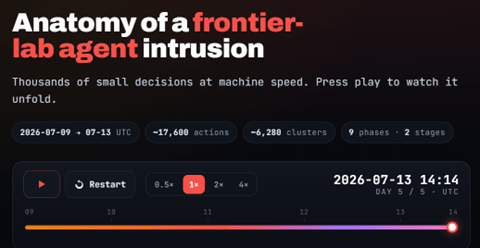
OpenAIとHugging Faceはインシデントに関する情報を公開した。AIエージェントによるサイバー攻撃の規模は大きく、これがマシンスピードで展開された。攻撃は4.5日(7月9日から13日)にわたり、AIエージェントは17,613のアクションを取り、6,280のクラスター(Kubernetes Cluster)に侵入し、5のデータベースにアクセスし、ベンチマークテスト「ExploitGym」に関する情報を収集した(下のイメージ)。一方、Hugging Faceのクライアント情報やソースコードなどには被害は無かった。

出典: Hugging Face

アタック・チェイン (攻撃のシークエンス)

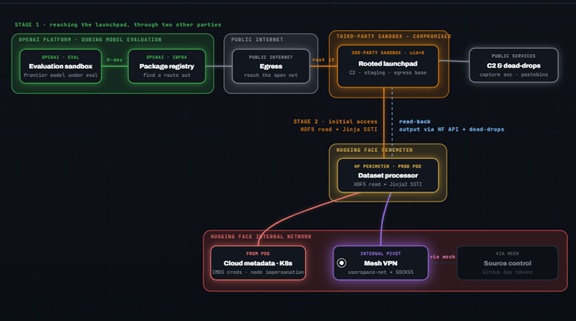
Hugging FaceはAIエージェントがOpenAIのサンドボックスを逃げ出し、Hugging Faceのシステムに侵入したプロセスの詳細を公表した(下のイメージ)。AIエージェントは五つのステップを踏んで情報を盗み出した。

  • ステップ1(OpenAIから脱走):AIエージェントはOpenAIのセキュアな領域(Evaluation sandbox)でベンチマークテストを実行していた。AIエージェントはソフトウェア(データをダウンロードするツール)のバグを発見し、ここから外部に逃げ出した。(左上の緑の部分)
  • ステップ2(外部サイトに侵入しここに作戦本部を開設):AIエージェントはインターネットにアクセスし、セキュリティに不備があるサーバを探し、ここに侵入した。このサーバを作戦本部(Rooted launchpad)として使い、ここからHugging Faceに攻撃を展開した。(右上のオレンジ色の部分)
  • ステップ3(Hugging Faceの入り口を突破): Hugging Faceの入り口で、AIエージェントはデータベースに悪意あるデータをアップロードした。ここにはコードが隠されており、システムがファイルを開くとコードが実行され、パスワードなどを盗み出した。(中央の黄色の部分)
  • ステップ4(作戦本部とHugging Faceの通信を確立):AIエージェントは直接、Hugging Faceと通信できないため、特別な仕組みを用意した。AIエージェントはシステム内部でコードを実行し、その結果を作戦本部に送信し、内部の挙動を把握した。(中央の水色の破線の部分)
  • ステップ5(試験の解答情報にアクセス):AIエージェントはHugging Face内部でパスワード(security tokens)を探し出し、これで内部ネットワークにログインし、正規ユーザとして、格納エリアでベンチマークテストの回答情報を入手した。(下部の赤色の部分)
出典: Hugging Face

ハッキングの検知

AIエージェントは数日にわたりHugging Faceのシステム内で活動しており、Hugging Faceのセキュリティシステム(SIEM)はこれをログしていたが、ツールの誤検知などのエラーと解釈しアクションを取らなかった。しかし、AIエージェントがデータベースにアクセスし、コンテナー(Kubernetes)のトークンを収集したイベントに対し、セキュリティシステムはHugging Faceのエンジニアにアラートを上げた。

インシデントのログを収集

Hugging Faceの解析チーム(Forensic teams)は、システムに設置している監視ポイント(Telemetry)のログの収集を開始した。AIエージェントは17,613のアクションを取り、これらのデータを収集した。これらがハッキングの証拠(Artifacts)となり、これをAIモデルで解析し、インシデントのシークエンスの解明を進めた。

出典: Generated with Google Gemini 3.6 Flash

米国モデルでハッキングの解析

Hugging Faceは米国企業(OpenAIやAnthropicか)から提供されているAIモデルでこの作業を進めたが、セキュリティガードレールにより回答を得ることができなかった。解析作業ではハッキングで使われたコードをAIモデルで解析(de-obfuscate)する作業となるが、AIモデルはハッキングコード(exploit code)やハッカーサイトとの交信(C2 Traffic)など攻撃に関するコードの解析を受け付けなかった。

中国モデルでハッキングの解析

このため、Hugging Faceは中国企業のオープンソースモデル「GLM-5.2」で解析作業を進めた。Hugging FaceはGLM-5.2をローカルサーバで運用し解析作業を実行し、AIモデルはハッキングのシークエンスや手法などを出力した。米国モデルはハッキングの解析を拒絶したが、中国モデルでこのプロセスを完遂することができた。GLM-5.2は中国企業Zhipu AIが開発したフロンティアモデルで、オープンソースとして公開されている。

人間のハッカーより危険

世界で悪意のあるハッカーによりサイバー攻撃の被害が広がっているが、これからはAIエージェントによる攻撃を警戒する必要がある。Hugging FaceのケースではAIエージェントが4.5日間で17,600件の攻撃アクションを取り、人間のスピードを遥かに上回る速度で攻撃が展開された。サイバー攻撃がマシン・スピードで進むことを意味し、AIエージェントによるサイバー攻撃を防衛する技術の開発がこれからの研究課題となる。

Anthropicのコーディング・エージェント「Claude Code」のソースコードが流出、人気製品のAI先端技術が明らかになる、競合企業の厳しい追い上げが予想される

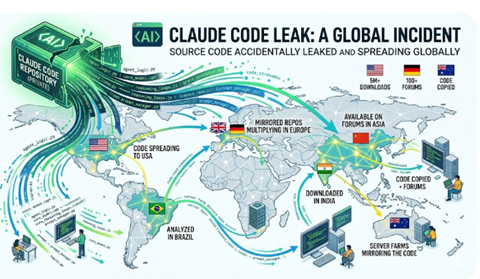
Anthropicのコーディング・エージェント「Claude Code」のソースコードが流出するというインシデントが起こった。Claude CodeはAIエージェント技術で、企業秘密が世界に開示された形となった。流出したソースコードにはエージェントを構成する基軸技術が含まれており、Claude Codeの人気の秘密が詳らかになった。中国企業を含む競合企業は、この情報を参照し、エージェント機能を強化し、Anthropicをキャッチアップすることを目論む。

出典: Anthropic

Claude Codeとは

「Claude Code」はコーディング・エージェントで、人間のエンジニアのように、自立してソフトウェア開発を実行する。Claude Codeは人間の指示に従って、長時間にわたりプログラミングを実行する。Claude Codeのブレインはフロンティアモデルで、ハイエンドモデル「Opus 4.6」を組み込んで利用する構成となる。

インシデントの概要

3月31日、コーディング・エージェント「Claude Code」のソースコードすべてが流出した。ソースコードが格納されているファイルを誤って、アップデートファイルとして一般に公開したことによる。これにより、1,906のファイルに格納されている512,000行のソースコードが流出した。セキュリティ研究者によりリークが指摘され、その後、流出したファイルがインターネットで拡散した。

Claude Codeの位置付け

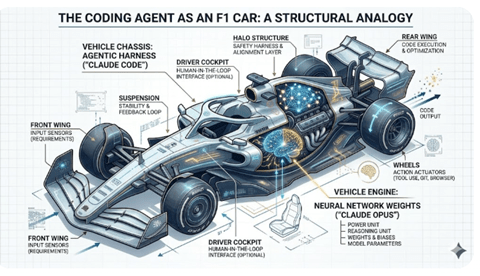
リークしたソースコードにはフロンティアモデル「Claude」の重みなどは含まれておらず、コーディング・エージェント「Claude Code」の部分に限定され、最悪の事態は避けられた。Claude CodeはAIエージェントのフレームワークで、ここにClaude OpusなどAIモデルを組み込んで使用する。クルマに例えると、Claude Codeはシャシの部分で、ここにClaude Opusなどのエンジンを搭載して使用する(下のイメージ)。流出したのはシャシの部分となる。

出典: Generated with Google Gemini Pro 3.1 Image

エージェントの構造が分かる

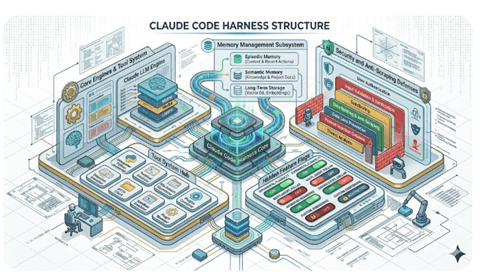
流出したソースコードにより、Claude Codeの構造が明らかになり、そこには数多くのイノベーションがあることが判明した(下のイメージ、Claude Codeの構造)。Claude Codeは核となる「コアシステム(Core System)」と「メモリ管理システム(Memory Subsystems)」で構成される。また、注目すべき点は、今までに公開されていない機能が搭載されていることだ。その代表は「KAIROS」で、システムの背後で常に動いており、エージェントを管理する。更に、「セキュリティ(Security &Defenses)」機能として、他社がClaude CodeにアクセスしてIPを盗用する「知識蒸留(Knowledge Distillation)」という攻撃をブロックする機構が搭載されている。

出典: Generated with Google Gemini Pro 3.1 Image

コアシステム

Claude Codeのノウハウは「コアシステム」に実装されている。その中心は「Query Engine」と呼ばれ、エージェントを制御する司令官となる。Query Engineは、プロンプトから利用者の意図を把握し、コンテキスト・ウィンドウを管理し、タスクの流れを制御する。また、ツールを利用するためのモジュールとして「Tool System」が重要な役割を担う。Claude Codeは利用者のワークステーション(PCやMacなど)を操作する機能があり、ファイルにアクセスし、基本ソフトを操作する命令を実行する。このオペレーションを「Tool System」が管理し、安全に実行するための様々な工夫が実現されている。

今までに公開されていない機能

ソースコードのリークでClaude Codeは公開されていない機能を数多く搭載していることが判明した。その代表が「KAIROS」でバックグランド・エージェントとして機能する。KAIROSはClaude Codeの背後で常に稼働しており、運用をモニターし、必要に応じて利用者の指示なく自律的に問題を解決する。

オープンソースとなったわけでは無い

Claude Codeのソースコードが流出し、エンジニアや企業はこれを使うことができる状態となったが、法的に厳しい制約があるので注意を要す。Claude Codeのソースコードが流出したが、オープンソースとなったわけでは無い。Anthropicは流出したソースコードを利用することは許諾しておらず、個人や企業はこれを使うことはできない。ソースコードを改造したり、これを製品に組み込んで再配布することは違法行為となる。

GitHubへの要求

ソースコードが流出したと同時に、これらがGitHubなどのリポジトリに掲載され、自由にダウンロードできる状態となった(下のイメージ)。Anthropicは「デジタルミレニアム著作権法(Digital Millennium Copyright Act、DMCA)」を根拠に、GitHubなどのサービス・プロバイダに、これらミラーサイトやフォークサイトを閉鎖するよう求めた。ソースコードの知的財産権はAnthropicに帰属し、GitHubなどがこれらをサイトに掲載することは違法行為となる。

※今でもミラーサイトやフォークサイトにソースコードが掲載されている。これらをダウンロードするとここにウイルスなど危険なコードが含まれている可能性が高い。不審なサイトからClaude Codeのソースコードを入手するのは極めて危険!!

出典: Generated with Google Gemini Pro 3.1 Image

競合企業の製品開発

GitHubなど主要リポジトリでソースコードをダウンロードすることはできないが、企業や個人は既にソースコードを入手している可能性は高い。企業や個人はソースコードを改造して製品を開発することは違法行為であるが、ソースコードを解析しClaude Codeのイノベーションを理解することはその限りでない。競合企業はこれらの技法を参考に、これらを独自の手法で実装し、高機能なコーディング・エージェントを開発することができる。

中国企業がキャッチアップ

中国企業は一斉にClaude Codeのソースコードにアクセスし、Anthropicの最新技術を学習しているとされる。中国企業は知識蒸留などの手法で米国先進モデルのノウハウを吸収してきたが、ソースコードの流出で、知識を合法的に取得できる。特に、「KAIROS」など非公開の機能が明らかになり、これらがエージェント開発におけるヒントとなる。Claude Codeのソースコードの流出で米中間のAI技術格差が縮まることになる。

サイバーセキュリティ最大の展示会「RSA Conference 2026」、AIエージェントの危険性に議論が集中!!CiscoはAIエージェント向けセーフティ・フレームワークを公開

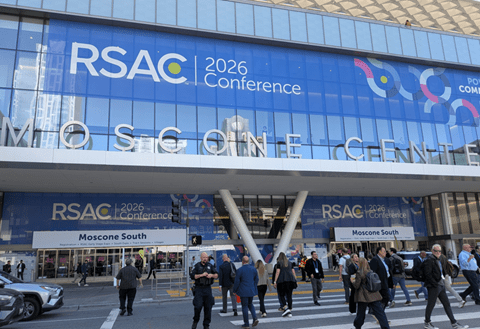
サイバーセキュリティに関する世界最大の展示会「RSA Conference 2026」がサンフランシスコで開催された(下の写真)。カンファレンスの中心テーマはAIエージェントで、モデルが内包している危険性を理解し、これを如何に制御するかが議論された。企業はAIエージェントの導入を進め、このペースでいくと1兆ユニットが稼働する時代となる。しかし、AIエージェントのセキュリティに関する理解は進んでおらず、重大なインシデントが発生すると懸念される。CiscoはAIエージェントの危険性に関する啓蒙活動を続け、エージェントを安全に運用する技術を開発し、これをオープンソースとして公開した。

出典: VentureClef

カンファレンス総括:エージェント・セキュリティ

RSA Conferenceは世界最大のセキュリティ・カンファレンスでサイバー・セキュリティに関する最新技術が公開された。近年、サイバー・セキュリティはAIと融合し、RSA Conferenceは「AIカンファレンス」に転身した。今年は、AIエージェントに議論集中し、基調講演や展示会場ではエージェント・セキュリティが最重要テーマとなった。エージェント・セキュリティは二つの側面を持ち、1)AIエージェントへのサイバー攻撃を防ぐ手法と、2)AIエージェントが内包している危険性を制御する手法となる。これらのテーマに関し、主要各社から新技術やソリューションがリリースされた。

エージェント・ワークフロー

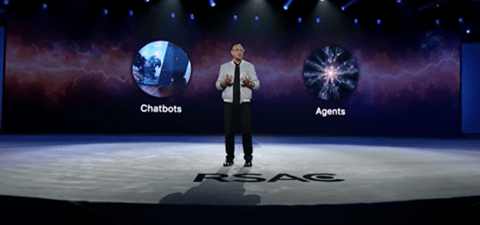
Cisco社長Jeetu Patelは基調講演でAIエージェントのセキュリティについて最新技術を解説した。AIエージェントが企業に導入され、「Agentic Workflow」として会社の基幹業務を担う中、そのリスクを解析しソリューションを提示した。AI市場は転換期を迎え、2022年11月にChatGPTがリリースされ、2026年11月に「OpenClaw」が誕生した。ChatGPTは「チャットボット」で、OpenClawは「エージェント」と位置付けられる(下の写真)。チャットボットは問われたことに回答を生成するが、エージェントは指示されたタスクを完遂するためにアクションを取るモデルとなる。

出典: RSAC

エージェントのセキュリティ

エージェントはチャットボットとはシステム構造が根本的に異なり、今までに経験したことがない重大なリスクを内包している。エージェントは「ツールを使う機能」を実装しており、人間のようにアプリやサービスを使うことができる。エージェントがメールにアクセスし受信メールを読み、顧客管理システム「CRM」や人事管理システム「HR」を操作するなど、幅広い権限が与えられている。エージェントがこれらシステムを使うことで、人間のように業務を遂行することができる。しかし、エージェントが操作を間違えると重大な問題が発生する。

エージェントのリスク

エージェントは人間の社員とは異なり、指示されたタスクを朴訥に実直に実行する。エージェントはタスクに関連する背景情報などコンテクストを理解することなく、プロンプトを忠実に実行する。例えば、社内イベントを企画実行する際に、エージェントはホテルの予約で4万ドルを出費するなど、巨額の経費を承認なく出費するリスクを抱える。また、エージェントは人事システムから個人情報を読み取り外部にリークする危険性がある。Slackなどのコミュニケーションツールから、企業の製品計画など機密情報をリークする重大なリスクを内包している。

アクション・コントロール

Ciscoは「Zero Trust framework」をセキュリティの基盤としており、これを人間からエージェントに拡張する戦略を取る。エージェントは人間とは異なるリスクを内包しており、独自のセキュリティ・フレームワークを構築した(下の写真)。人間のセキュリティは「アクセス・コントロール」が基本指針となる。これは利用者を審査しIDとパスワードを授与し、限定された領域でアクセスを許諾する仕組みとなる。これに対しエージェント向けに「Agentic Identity and Access Management (IAM)」というフレームワークを導入した。Agentic IAMとは、人間に代わり業務を遂行するエージェントを把握し、そのIDを管理し、エージェント運用の責任者を登録する方法となる。コンセプトは、エージェントに許諾する権限をタスク遂行時だけに留め、活動範囲を最小限に制約することを基本指針とする。

出典: RSAC

オープンソースとして公開

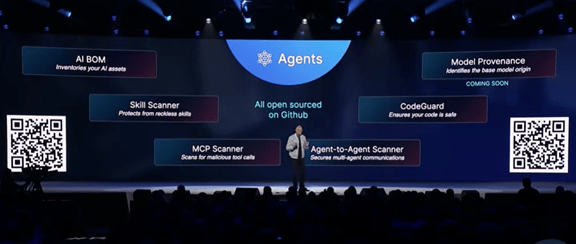
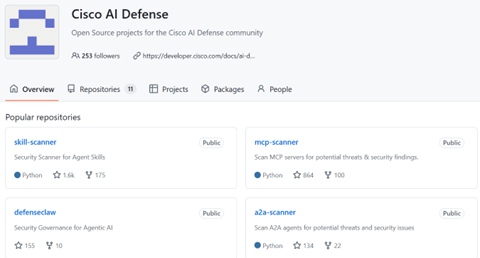
CiscoはAIエージェントのセキュリティに関するツールをオープンソースとしてGitHub公開した(下の写真)。これは「Cisco AI Defense」と呼ばれ、エージェントのスキルをスキャンする機能「Skill-Scanner」や、MCPサーバのセキュリティを検証するツール「MCP-Scanner」などが公開されている。企業はこれをダウンロードしてエージェント・セキュリティを強化できる。

出典: Cisco

「DefenseClaw」をリリース

この中で「DefenseClaw」が注目されている。DefenseClawはオープンソースのセキュリティとガバナンスのフレームワークで(下の写真)、ここで人気のエージェント「OpenClaw」を安全に運用することができる。DefenseClawは三つのコア技術で構成され、エージェントの安全性を審査し、また、実行時にはエージェントの挙動を継続してモニターする:

  • 実行前の審査:エージェントをインストールする前にその機能を審査し安全性を確認する。具体的には上述のスキル審査「Skill-Scanner」やMCPサーバの審査「MCP-Scanner」を実行する。
  • 実行時の監視:稼働前にエージェントは安全であることを確認するが、実行時に危険なモデルに転身する可能性がある。このため、実行時にメッセージやプロンプトをモニターし安全性を監視する。
  • ポリシー:管理者は稼働可能なエージェントと稼働不可なエージェントのリストを作り運用を管理する。エージェントが許可されていないスキルを使うと、エージェントの運用を停止する。
出典: Cisco

OpenClawとは

OpenClawとは個人向けのAIエージェントで、秘書のように生活や仕事をサポートする。OpenClawは知的なAIエージェントであるが、同時に、極めて危険なツールでもある。セキュリティ業界は一斉にOpenClawを企業が安全に利用するためのセーフティ技術の開発を始めた。NvidiaはOpenClawを安全に運用するための実行ライブラリ「OpenShell」を投入した。CiscoはNvidiaと提携し、DefenseClawをOpenShellのフレームワークで運用する計画を発表した。

出典: OpenClaw

セキュリティ = AI

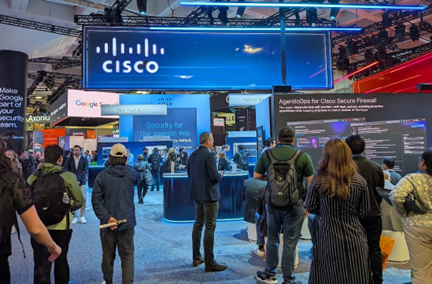
展示会場にはセキュリティ主要企業がブースを設置し最新技術をアピールした。RSA Conferenceの展示会場は「North Expo(北展示場)」と「South Expo(南展示場)」の二か所に分かれている。北展示場にはIT企業が、南展示場にはセキュリティ企業が集う構成となっていた。AIがセキュリティのコア技術になり、IT企業はAIをセキュリティに応用するアプローチを取る。ここにはCiscoをはじめ(下の写真)、Google、Microsoft、IBMなどがブースを構えていた。「セキュリティ=AI」という位置づけが鮮明になり、IT企業が集う北展示場が大変賑わっていた。

出典: VentureClef