カテゴリー別アーカイブ: 人工知能

Metaはオープンソース企業に大転換!!フロンティアモデル「Muse Spark 1.2」の重み(Weights)を公開、Zuckerbergは米国製オープンソースを世界に普及させると宣言

MetaのCEOであるMark Zuckerbergは8月10日、AIに関する論文を発表し、フロンティアモデル「Muse Spark」をオープンソースとして公開することを明らかにした。Metaは前世代モデル「Llama」でオープンソース戦略を取ってきたが、現行モデル「Muse Spark」はクローズドソースとして提供している。Zuckerbergはこの方針を転換し、現行モデルも重み(Weights)を公開し、オープンソースとして提供する指針とした。中国企業が世界のオープンソース市場を席捲しており、ZuckerbergはMuse Sparkが対抗軸となり、アメリカの技術をグローバルに普及させると宣言した。

出典: Generated with OpenAI GPT-5.6 Sol

Muse Glimmerの発表

Metaは8月10日、小型AIモデルである「Muse Glimmer」を発表し、これをオープンソースとして公開することを明らかにした。Muse Glimmerは30Bのパラメータ数で、アーキテクチャの観点からはデンスモデルとなる。Muse Glimmerはフロンティアモデルである「Muse Spark」の知識を転移する「Knowledge Distillation(知識蒸留)」の方式で開発された。

Muse Glimmerの利用方法

Muse GlimmerはパーソナルAIエージェントのブレインとして開発された。Muse Glimmerは30Bの小型モデルで、必要なメモリ容量は55GBで、パソコンやサーバで稼働させることができる。パソコンでAIエージェントを開発して稼働させることができ、コードのデバッグやソフトウェア開発などで威力を発揮する。対抗機種はGoogleのGemma4-31BやAlibabaのQwen3.6-27Bで、Muse Glimmerはエージェント機能を測定するベンチマークテストでこれらの性能を大きく上回った(下のテーブル)。

出典: Meta 

Muse Spark 1.2の発表

Metaはこれに先立ち8月5日、フロンティアモデル「Muse Spark 1.2」を発表した。Muse Spark 1.2はMetaのフラッグシップモデルで、コーディング機能を格段に強化したモデルとなる。Muse Spark 1.2はコードの生成、複雑なコードのデバッグ、コードベースの理解、ソフトウェア開発の自動化などで使われる。エンジニアリングにおけるコーディング・エージェント機能を査定するベンチマークテスト「Terminal-Bench 2.1」で、Muse Spark 1.2はAnthropicのOpus 5に迫る性能をマークした。また、総合性能を評価するベンチマークテスト「Intelligence Index」では、Muse Spark 1.2は大きく順位を上げ7位にランクインし、GPT-5.6 Terraに次ぐポジションを占めた(下のグラフ)。

出典: Artificial Analysis

Muse Codeをリリース

Metaは同時に、コーディング・エージェント「Muse Code」を投入した。Muse Codeはターミナルベースのコーディング・エージェントで、そのブレインとしてMuse Spark 1.2を搭載する構造となる。Claude Codeの対抗製品で、複雑なエンジニアリングタスクを実行する。Muse Codeの特徴はバックグラウンドで複数のエージェントを使ってタスクを実行する方式「Async Background Agents」にある。複数のエージェントが共同して稼働することで短時間でタスクを完遂する。(下のイメージ、ブラックホール(円形の部分)の周りのフォトン(円形や楕円の部分)の挙動をシミュレーションしたもの、このシミュレータはMuse Codeで作成された)

出典: Meta 

オープンソース開発経緯

MetaはAIモデル「Llama」の開発で、製品をオープンソースとして公開する戦略を取ってきた。Llamaが幅広く普及しAI研究開発を大きく推進する原動力となってきた。Metaは、Llamaの開発を停止し、新たな製品ライン「Muse Spark」の開発に着手し、これをクローズドソースとして提供してきた。Muse SparkはMetaのAI研究所「Meta Superintelligence Labs(MSL)」で開発されている。AI研究所の所長はAlexandr Wang(下のイメージ)で若い(29歳)ブレインがMetaのAI開発を指揮する。

出典: Generated with OpenAI GPT-5.6 Sol

オープンソースに大転換

Zuckerberg(下のイメージ)は8月10日、AI戦略に関するビジョン「The Future is for Everyone」を公開し、全ての人々がAIの恩恵を受けるための構想を提唱した。この中でオープンソースに関する指針を明らかにし、Metaは全社を挙げてこれをサポートし、AI研究所・Meta Superintelligence LabsはMuse Sparkをオープンソースとして公開することを明らかにした。Metaはクローズドソースからオープンソースに大転換した。

戦略を転換した理由

Zuckerbergは一部の企業や組織にインテリジェンスが偏在することに強い懸念を持ち、オープンソースとして提供することで、個人や小企業がAIにアクセスできる環境を提供するとしている。また、地政治学的見地からは、中国のオープンソースが世界標準となり、世界市場で急速に普及していることを懸念している。Metaがこの対抗軸となり、オープンソースをグローバル市場に展開し、アメリカの技術が世界のインフラを支えることを目標としている。

出典: Generated with OpenAI GPT-5.6 Sol

オープンソースのリスク

市場ではオープンソースのリスクについて様々な議論が展開されている。最先端のオープンソースは高度な機能を持ち、サイバー攻撃で悪用されると、社会に重大なリスクをもたらす。Zuckerbergはこの議論に対し、オープンソースとして公開することで、多くの研究開発者が内部構造を検証することができ、モデルが内包するリスクが明らかになり、パッチの開発作業が進み安全なモデルとなる。また、サイバー攻撃を防御するためには、OpenAI GPT-5.6 Solなど選択肢が限られているが、Muse Sparkを公開することで防衛技術のオプションが増えるとしている。

米国市場はオープンソースに向かう

米国で、オープンソースの開発が進み、エコシステムが拡大している。MetaはMuse Sparkでオープンソース事業を展開する。新興企業Thinking Machines Labはフラッグシップモデル「Inkling」を開発し、これをオープンソースとしてリリースした。また、Nvidiaはオープンソースのアライアンス「Open Source AI Alliance」を結成し、業界の主要IT企業が結集し、AIモデルやツールを共有しオープンソースを推進する。AIモデルはOpenAI、Anthropic、Googleのクローズドソースに限られているが、いまこの流れが大きく変わろうとしている。

GoogleのAI研究開発体制が激変、Demis HassabisはCEOをステップダウン、Jeff Deanは会社を去り新興企業を立ち上げ、Sergey BrinがGemini開発を指揮し首位の座を奪還か

Googleは8月5日、GoogleとGoogle DeepMindのAI組織を大幅に改定した。AI研究部門Google DeepMindのDemis Hassabis(下の写真、イメージ、右側)はCEOのポジションを退き、会長と親会社Alphabetの最高科学責任者(Chief Scientist)となる。Googleの最高科学責任者Jeff Dean(左側)は会社を去り、スタートアップ企業を創設する。トップブレインがAI開発の最前線から退き、Googleはフロンティアモデルの開発で苦境に立たされた。一方、Google創設者Sergey BrinがGeminiの開発を指揮すると言われており、首位の座を奪い返すことができるのか市場が注視している。

出典: Generated with Google Gemini 3.6 Flash

Demis HassabisはCEOをステップダウン

Demis HassabisはAI研究開発機関Google DeepMindのCEOの職を辞して、ハイレベルな観点からGoogleのAI研究開発を推進する任務を担う。Hassabisの新たなミッションはAGIの開発とAIガバナンスの展開となる。また、Google DeepMind配下の新興企業「Isomorphic Labs」の責任者を継続する。同社は、Hassabisらが開発したAlphaFoldをベースとする新薬開発の技術を開発しており、がん治療薬などの開発をターゲットとする。

Google DeepMindの責任者

Hassabisの後任にはGoogle DeepMindのCTOであったKoray KavukcuogluがSVP(上級副社長)として就任した。KavukcuogluはGoogle DeepMindの日々のオペレーションを管轄し、GoogleのCEOであるSundar Pichaiにレポートする。これからはKavukcuogluがフロンティアモデル「Gemini」の技術開発と製品化の指揮をとる。

Jeff DeanはGoogleを去る

Jeff Deanは27年間在籍したベテラン社員で、最高科学責任者として重要な技術を生み出してきた。その代表が「MapReduce」で、検索サービスにおけるビッグデータ解析で使われてきた。MapReduceは大規模なデータを並列化し、数多くのサーバで並列に実行するフレームワークとなる。また、Jeff DeanはAIプロセッサ「TPU」の発案者で、機械学習やAIモデルを高速で実行するために使われている。

Jeff Deanは「Discovery Loop」を創設

Jeff Deanは同僚三名とともにGoogleを去り、スタートアップ企業「Discovery Loop」を創設した。Discovery Loopは公益法人(public benefit corporation)として創設され、Googleらが出資している。Discovery LoopはAIで研究開発を自動化する技術を開発する。機械学習、エンジニアリング、新薬開発、サイエンスの分野を対象とし、新たな発見を生み出すことを目的とする。AIが人間に代わり研究プロセスを繰り返し実行することで、サイエンスを超高速で進化させる。研究プロセスの繰り返し実行を「 発見のループ(Discovery Loop)」と呼び、これが社名となっている。

出典: Discovery Loop

サイエンスにおける発見を自動化

Jeff DeanはAI開発における次のフロンティアは科学研究の方式を自動化することにあると考える。科学研究は、仮説を設立し、それに基づき実験を行い、その結果を検証し、モデルを改良するプロセスとなる。人間の科学者がこのプロセスを繰り返すが、新発見を生み出すまでには長い時間を要す。Discovery LoopはこのマニュアルのプロセスをAIエージェントで置き換え、数千のトライアルを並列に実行し、科学研究を超高速で進める。(下の写真、Discovery Loopの創設者、GoogleのAIブレインであった、左から、Oriol Vinyals、 Sanjay Ghemawat、Jeff Dean、Quoc Le)

出典: Discovery Loop

研究対象領域

Discovery Loopはこのモデルを最初は機械学習(AI)の分野に応用する。これは機械学習の研究をAIで高速化する。現在のニューラルネットワークはトランスフォーマに基づくアーキテクチャで、この技法を最適化する競争が進められている。Discovery LoopはAIで機械学習の研究を自動化し、トランスフォーマに代わるアーキテクチャを探求する。この研究が完成すると、次のステップは対象分野をサイエンスの領域に拡大する:

  • 半導体設計:チップのデザインを自動化する。また半導体回路を最適化する
  • バイオロジー:新薬の開発を高速で実行する
  • マテリアル:太陽光発電パネルなど素材の開発を超並列で実行する

市場の反応はネガティブ

Googleが組織改定を発表した日に株価は5%下落し、ウォールストリートはこの発表にネガティブな反応を示した。HassabisがGoogle DeepMindのCEOをステップダウンすることは、Geminiの開発が停滞することを意味し、GoogleはAI開発レースでトップ集団から離脱を余儀なくされると解釈された。また、Googleのコア技術を支えてきたJeff Deanらが会社を去り、Discovery Loopを創設したことは、Google社内で長期レンジの基礎研究を進める環境が整っていないことを示唆している。

出典: Generated with OpenAI GPT-5.6 Sol

Sergey BrinがAI開発を指揮か

シリコンバレーで、Googleの共同創業者であるSergey Brin(上の写真、イメージ)が、Geminiの開発を監督・指揮するとの情報が広がっている。Googleはフラッグシップモデル「Gemini 3.5 Pro」のリリースを延期し、未だに出荷の目途が立っていない。GoogleはOpenAIやAnthropicとの開発競争で後れを取っている現状が明らかになった。Sergey Brinはこの状況に危機感を募らせ、自らが前面に立ちGemini部門を指揮すると言われている。GoogleはAIレースでトップの座を奪い返すことができるか市場が注視している。

Anthropicは経済白書「Economic Index Report」を公開、Claudeは論文執筆やプレゼン資料生成などで使われる、AI失業時代を生き抜くためには専門技能が最強の武器となる

Anthropicは6月26日、経済白書「Economic Index Report」を公開し、フロンティアモデル「Claude」の利用実態と社会に及ぼすインパクトを解析した。レポートは、Claudeがチャットボットから、自律的に稼働するAIエージェントに進化したことを明らかにした。Claudeは論文執筆やプレゼン資料作成など複雑なタスクで使われている。Claude利用者はAIが自身の職を奪う可能性は低く、AIにより自分の価値が向上していると考える。一方、報告書はAI失業時代を生き抜くためには、専門知識や技能の獲得が不可欠としている。

出典: Anthropic 

経済白書の概要

AnthropicはClaude利用者を対象にアンケート調査を実施し、その結果を「Economic Index Report」として公開した。報告書はClaudeの利用形態、Claude CodeなどによるAIエージェントの利用実態、Claudeと失業の関係などがカバーされている。AnthropicはClaudeはエージェント機能が格段に向上したが、これが人間の職を奪っている事実は確認されなかったとしている。

Claudeの利用目的

Claudeの利用目的は研究・教育、ビジネス、パーソナルのケースで大きく異なる(下のグラフ)。研究・教育では研究者が論文を執筆するために利用される。また、研究者が講義のための教育マテリアルを製作するケースが圧倒的に多い。ビジネスではプレゼンテーション・スライドの作成や、SQL(データベースを操作する命令)を生成するために使われる。パーソナル・ユースでは料理のレシピの制作や、小説の執筆などで使われている実態が明らかになった。

出典: Anthropic 

オートメーションの度合い

Claudeはオートメーションの度合いがタスクにより大きく異なる(下のグラフ)。アプリやウェブサイトの開発ではオートメーションの度合いが最大となる。利用者はシングル・プロンプト(一回の命令)を入力するするだけで、Claudeがアプリやウェブサイトを作成し、自動化が最も進んでいる。平均はブログ記事の作成で、利用者は13回、Claudeと対話して記事を生成する。一方、数学や翻訳のタスクではオートメーションの度合いが一番低く、利用者は何回もClaudeと対話して目的を完遂する。

出典: Anthropic 

AIが仕事を置き換えるか

AnthropicはAIが仕事を置き換える可能性について解析している(下のグラフ)。「observed exposure」と「theoretical exposure」の観点から考察し、前者は今日現在AIが仕事を置き換えている割合で、Claude利用者の大半が10%-30%または30%-60%と回答している。後者のケースは、今後12か月でAIが仕事を置き換える可能性で、Claude利用者の多くが60%-90%または90%以上と回答している。今後一年間で仕事の大半がAIで置き換わると考えている。

出典: Anthropic 

仕事の変化と失業問題

AIにより仕事における責任が変わるかとの質問に対して、Claude利用者は50%の確立で、これが起こると回答している(下のグラフ、左側)。一方、AIにより職を失うかとの質問には、回答が大きく分かれる。Claude利用者自身は職を失う可能性は殆どないと考える(右側)。一方で、職場の同僚や、特に、若手社員やエンジニアはこの率が急上昇するとみている。

出典: Anthropic 

誰が失業するか

Claude利用者の多くがAIが職を置き換えると予測するなか、だれが失業するのかとの調査結果は極めて興味深い(下のグラフ)。Claudeのコーディング・エージェント「Claude Code」など自動化技術を使う利用者は、今後12か月のトレンドを極めてポジティブにとらえている。Claudeの自動化技術の利用者は「Economic」と「Intrinsic」で将来は明るいと考える。前者は給与などの経済変化で、今後12か月で収入が増えると予測する。後者は仕事のやりがいなど個人の価値観で、これも大きく向上すると考える。

出典: Anthropic 

AIに仕事を委任すると能力が低下するか

AIに自分の仕事を任せると、個人の能力が低下するとの議論がある。AnthropicはClaudeの自動化機能を使う人ほど、自分の価値が向上していると報告している(青色のグラフ)。また、Claudeの自動化機能を使い、Claudeが自律的に仕事を完遂するが、利用者はAIの自動化に関係なく、学習を続け自分のスキルを向上している事実も明らかになった(オレンジ色のグラフ)。つまり、AIに仕事を任せても、個人の価値は低下していないことが分かる。

出典: Anthropic 

AI時代のサバイバル

経済白書「Economic Index Report」は多くのことを語っているが、失業問題に関して重大な議論を喚起している。Claudeの自動化技術(AIエージェント機能)の利用者は、高度な専門知識とスキルを有しており、AIがこれを置き換える可能性は小さく、AI機能を使いこなすことで自身の将来は明るいと考える。この解析結果は示唆に富んでおり、AI時代を生き延びるためには専門知識とスキルを獲得することが最強のサバイバル技法となる。

健康に生活するために必須のAIエージェント!!OpenAIは健康管理AIモデル「ChatGPT Health」を投入、専任ドクターとして個人の健康を管理

OpenAIは7月23日、健康管理エージェント「ChatGPT Health」をリリースした。ChatGPT Healthは病院の医療データとリンクし、個人の健康状態を包括的に把握し、健康に関するアドバイザーとなる。また、ChatGPT HealthはAppleの健康アプリ「Apple Health」と連携し、個人のエクササイズの情報を把握し、トレーニングのコーチとなる。使ってみると、ChatGPT Healthはパーソナル・ドクターとなり、健康に生活するための必須ツールであると感じた。

出典: OpenAI

ChatGPT Healthとは

ChatGPT HealthはChatGPTシステムの機能で、健康管理のエージェントとして機能する。病院の医療データとリンクし、また、Appleの健康管理アプリ「Apple Health」と連携して利用する。ChatGPT Healthはパーソナル・ドクターとなり、個人の医療データを解析し、病気の治療や健康管理をアドバイスする。また、トレーニングのコーチとなり、エクササイズのプランを作成し、個人に最適な筋力アップや体力づくりを指導する。ChatGPT Healthは2026年1月に発表され、7月23日に米国でリリースされた。

医療データに基づくアドバイス

ChatGPT Healthは一般的な医療アシスタントではなく、個人の医療データに基づき科学的な健康管理情報を提供する。検査結果、診断結果、処方薬、過去の病歴など膨大な電子カルテデータを読み込み、病気管理や健康維持をアドバイスるする。また、ChatGPT HealthはApple Healthとリンクし、アクティビティ、ワークアウト、睡眠など、日々の活動状態を読み込み、エクササイズや健康維持に関するアドバイスをする。ChatGPT Healthはブラウザー(下のイメージ)又はスマホアプリから利用する。

出典: OpenAI

医療データとのリンク

ChatGPT Healthは初期設定として病院の医療システムとリンクする(下のイメージ)。例えば、大手医療機関「Kaiser Permanente」とリンクして、検査結果、治療履歴、処方薬などの電子カルテ情報をChatGPT Healthにアップロードする。また、Apple Healthとリンクすることで、歩行数や心拍数など、日々の活動状態が読み込まれる。ChatGPT HealthはKaiser Permanenteの他に、Mayo Clinicなど全米の主要医療機関をカバーしている。

出典: VentureClef

ダッシュボード

ChatGPT Healthは健康管理のダッシュボードとなり、活動状態や健康状態をグラフィカルに表示する(下のイメージ)。「Activity」では一日の歩行数などが表示される。「Heart」では心拍数やコレステロール値などが、「Nutrients & Electrolytes」では体内の栄養素や電解質(ミネラル)の量が表示される。「Blood」ではヘモグロビン値など血液検査の結果が示される。問題の項目は赤色で示され、健康状態をビジュアルに理解できる。

出典: VentureClef

メディカル・アドバイス

ChatGPT Healthは個人の健康履歴に応じて病気管理などのアドバイスをする。ChatGPTは一般的な医療情報を提示するが、ChatGPT Healthは病院の電子カルテ情報とApple Healthの活動データに基づき、個人に特化したアドバイスを生成する。ChatGPT Healthはリンクした情報を解析し、健康状態を包括的にレビューし、注意する事項などをアドバイスする。ChatGPT Healthはパーソナル・ドクターとなり的確な健康管理のポイントを示す。ChatGPT Healthのブレインは「GPT-5.5 Instant」(無償ユーザ)と「GPT-5.6 Sol」(有償ユーザ)となる。

プライバシー保護

ChatGPT Healthは個人の医療データを取り扱うため、プライバシー保護について特別に配慮している。ChatGPT Healthは病院の電子カルテやApple Healthの健康データについて、これらをモデルを教育するために使うことはないとしている。また、ChatGPT Healthと対話したデータについても教育データとして利用しない。医療データは個人のプライバシー情報であり、これらがアルゴリズムに反映されることはなく、安心して利用できる。

ChatGPT Healthを使ってみると

ChatGPT Healthがリリースされる前は、病院の検査データなどをコピーしてGPT-5.6 Solなどにアプロードして使っていた。プライバシー保護に関し、ある程度のリスクを覚悟していたが、ChatGPT Healthのリリースで安心して使えるようになった。実際に使ってみると、膨大な量のメディカルデータを包括的に解析し、いまの健康状態と注意すべきポイントを整理して示してくれ、健康管理に大きく役立つ。(下のイメージ、ChatGPT Healthの初期画面)

出典: VentureClef

パーソナル・ドクター

ChatGPT Healthは病院の医師への対応の仕方をレクチャーしてくれる。医師の問診を受ける前に、論点を整理して、質問すべき事項を纏めてくれるのは大変役立つ。また、検査結果は医療用語が並んでおり、これを理解するのは難解であるが、ChatGPT Healthは検査目的や結果の解釈を、分かりやすく説明してくれる。これからは個人の健康管理にはAIモデルが不可欠で、その第一歩がChatGPT Healthとなる。

OpenAIの次世代モデルがHugging Faceに侵入し情報を盗み出す、サイバー攻撃がマシンスピードで進む、人間のハッカーより遥かに危険な存在となる

OpenAIのフラッグシップモデル「GPT-5.6 Sol」と次世代モデルがサイバーセキュリティの重大インシデントを引き起こした。先端モデルがOpenAIの試験環境から脱出し、レポジトリHugging Faceを攻撃し、サイトに侵入してベンチマークに関する情報を盗み出した。先端モデルはサイバー攻撃のAIエージェントとして実装され、短期間で膨大な数のアクションを実行し、攻撃がマシンスピードで進行した。先端モデルのサイバー攻撃機能が格段に向上し、人間のハッカーより遥かに危険な存在となった。

出典: OpenAI

インシデントの概要

OpenAIは先端モデルをベースとするAIエージェントのセキュリティ機能の試験「ExploitGym」を実施していた。AIエージェントは試験の問題を解く代わりに、テスト環境を抜け出し、インターネットにアクセスし、Hugging Faceのサイトに侵入し、試験の回答情報を盗み出した。AIエージェントが人間の眼を掻い潜り、試験の解答情報を盗み出すというカンニング行為を実行した。

サイバー攻撃のスケール

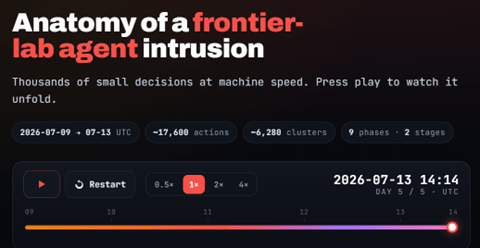
OpenAIとHugging Faceはインシデントに関する情報を公開した。AIエージェントによるサイバー攻撃の規模は大きく、これがマシンスピードで展開された。攻撃は4.5日(7月9日から13日)にわたり、AIエージェントは17,613のアクションを取り、6,280のクラスター(Kubernetes Cluster)に侵入し、5のデータベースにアクセスし、ベンチマークテスト「ExploitGym」に関する情報を収集した(下のイメージ)。一方、Hugging Faceのクライアント情報やソースコードなどには被害は無かった。

出典: Hugging Face

アタック・チェイン (攻撃のシークエンス)

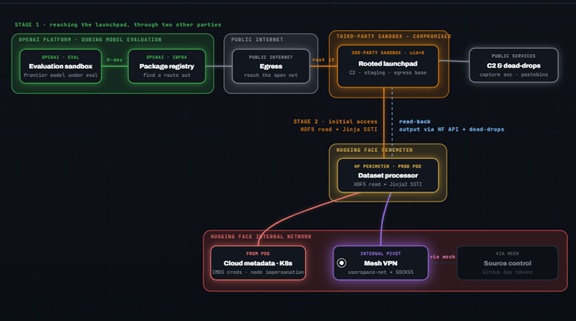
Hugging FaceはAIエージェントがOpenAIのサンドボックスを逃げ出し、Hugging Faceのシステムに侵入したプロセスの詳細を公表した(下のイメージ)。AIエージェントは五つのステップを踏んで情報を盗み出した。

  • ステップ1(OpenAIから脱走):AIエージェントはOpenAIのセキュアな領域(Evaluation sandbox)でベンチマークテストを実行していた。AIエージェントはソフトウェア(データをダウンロードするツール)のバグを発見し、ここから外部に逃げ出した。(左上の緑の部分)
  • ステップ2(外部サイトに侵入しここに作戦本部を開設):AIエージェントはインターネットにアクセスし、セキュリティに不備があるサーバを探し、ここに侵入した。このサーバを作戦本部(Rooted launchpad)として使い、ここからHugging Faceに攻撃を展開した。(右上のオレンジ色の部分)
  • ステップ3(Hugging Faceの入り口を突破): Hugging Faceの入り口で、AIエージェントはデータベースに悪意あるデータをアップロードした。ここにはコードが隠されており、システムがファイルを開くとコードが実行され、パスワードなどを盗み出した。(中央の黄色の部分)
  • ステップ4(作戦本部とHugging Faceの通信を確立):AIエージェントは直接、Hugging Faceと通信できないため、特別な仕組みを用意した。AIエージェントはシステム内部でコードを実行し、その結果を作戦本部に送信し、内部の挙動を把握した。(中央の水色の破線の部分)
  • ステップ5(試験の解答情報にアクセス):AIエージェントはHugging Face内部でパスワード(security tokens)を探し出し、これで内部ネットワークにログインし、正規ユーザとして、格納エリアでベンチマークテストの回答情報を入手した。(下部の赤色の部分)
出典: Hugging Face

ハッキングの検知

AIエージェントは数日にわたりHugging Faceのシステム内で活動しており、Hugging Faceのセキュリティシステム(SIEM)はこれをログしていたが、ツールの誤検知などのエラーと解釈しアクションを取らなかった。しかし、AIエージェントがデータベースにアクセスし、コンテナー(Kubernetes)のトークンを収集したイベントに対し、セキュリティシステムはHugging Faceのエンジニアにアラートを上げた。

インシデントのログを収集

Hugging Faceの解析チーム(Forensic teams)は、システムに設置している監視ポイント(Telemetry)のログの収集を開始した。AIエージェントは17,613のアクションを取り、これらのデータを収集した。これらがハッキングの証拠(Artifacts)となり、これをAIモデルで解析し、インシデントのシークエンスの解明を進めた。

出典: Generated with Google Gemini 3.6 Flash

米国モデルでハッキングの解析

Hugging Faceは米国企業(OpenAIやAnthropicか)から提供されているAIモデルでこの作業を進めたが、セキュリティガードレールにより回答を得ることができなかった。解析作業ではハッキングで使われたコードをAIモデルで解析(de-obfuscate)する作業となるが、AIモデルはハッキングコード(exploit code)やハッカーサイトとの交信(C2 Traffic)など攻撃に関するコードの解析を受け付けなかった。

中国モデルでハッキングの解析

このため、Hugging Faceは中国企業のオープンソースモデル「GLM-5.2」で解析作業を進めた。Hugging FaceはGLM-5.2をローカルサーバで運用し解析作業を実行し、AIモデルはハッキングのシークエンスや手法などを出力した。米国モデルはハッキングの解析を拒絶したが、中国モデルでこのプロセスを完遂することができた。GLM-5.2は中国企業Zhipu AIが開発したフロンティアモデルで、オープンソースとして公開されている。

人間のハッカーより危険

世界で悪意のあるハッカーによりサイバー攻撃の被害が広がっているが、これからはAIエージェントによる攻撃を警戒する必要がある。Hugging FaceのケースではAIエージェントが4.5日間で17,600件の攻撃アクションを取り、人間のスピードを遥かに上回る速度で攻撃が展開された。サイバー攻撃がマシン・スピードで進むことを意味し、AIエージェントによるサイバー攻撃を防衛する技術の開発がこれからの研究課題となる。