カテゴリー別アーカイブ: 人工知能

米国連邦議会は生成AIに関する公聴会を開催、OpenAIはAIの販売にライセンス制度を導入することを提案

米国連邦議会上院は生成AIに関する公聴会を開催し、OpenAIのSam Altmanらが安全対策に関し意見を述べた。その中で、Altmanは高度なAIを規制する必要があると述べ、連邦政府と協力する姿勢を明らかにした。更に、企業は安全規格に従ってAIを開発し、AIの販売や運用にライセンス制度を導入することを提言した。医薬品の開発では臨床試験により安全性が確認されるように、AIも審査をクリアしたものだけが販売を認められる制度の検討が始まった。

出典: U.S. SenatePrivacy, Technology, & the Law

上院議会公聴会の概要

連邦議会上院の法務委員会「U.S. Senate Committee on the Judiciary Subcommittee」は、生成AIに関する公聴会を開催し、OpenAIのAltmanの他に、IBMの倫理AI責任者Christina Montgomeryとニューヨーク大学名誉教授Gary Marcusが証言した。公聴会は高度なAIをどう規制するかについて議論された。三者の発言の要旨は:

  • Sam Altman:OpenAIの安全対策を説明。政府が安全なAIに関する基準を設け、企業はこれに従ってAIを開発・運用することを提言。(下の写真)
  • Christina Montgomery:IBMは企業向けに、AIの危険性を低減し、安全なモデルを開発していることを説明。
  • Gary Marcus:高度なAIは重大な危険性を内包し、社会に深刻な危険性を及ぼしていることを事例をあげて説明。
出典: U.S. Senate Committee on the JudiciarySubcommittee on Privacy, Technology, & the Law

OpenAIの安全対策

AltmanはChatGPTやGPT-4が使われている事例を示し、生成AIは社会に多大な恩恵をもたらしていることを説明した。また、OpenAIはAIの危険性を低減するために、様々な技法を開発し、モデルを出荷する前に、社内だけでなく、社外の専門企業に委託し、安全性の検証作業を実施した経緯を説明。GPT-4のケースでは、アルゴリズムの教育が終わった後、六ヶ月にわたり、多角的に安全性の試験を実施した。

プライバシー侵害

多くの議員は、ChatGPTは個人のプライバシーを侵害していると重大な懸念を示した。ChatGPTの開発では、ウェブサイトのデータがスクレ―ピングされ、個人情報や著作物がアルゴリズム教育で使われていることを指摘。また、ChatGPTとの対話で入力された会話データがアルゴリズム教育で使われることにも懸念が示された。

プライバシー保護の対策と提案

これに対し、Altmanは個人のプライバシー保護を重要課題と位置付け、様々な対策を講じていることを説明した。更に、議員の指摘に対し、新たな制度を導入する考えを示した:

  • ターゲッティング広告:ChatGPTは個人データから消費者のプロフィールを構築し、これをターゲッティング広告などで使うことはない
  • 対話データ:ChatGPTは利用者との会話データを使ってアルゴリズムを教育していることは事実。しかし、利用者は会話データの利用を禁止するオプションがあり、これを選択すると対話データは破棄される。
  • ウェブ上のデータ:ウェブ上に公開されている個人情報や著作物がアルゴリズムの教育で使われた場合は、これらのデータの削除を要求できる。

アーティストや作家などが、著作物でアルゴリズムを教育することの禁止を求めているが、Altmanは、個人や著作者がこれを申請する制度の導入を計画していると説明した。

出典: U.S. Senate Committee on the JudiciarySubcommittee on Privacy, Technology, & the Law

AI規制の必要性

現在、米国にはAIを規制する法律は無く、AltmanはAIを安心して利用するためには政府による規制が必要であるとの考え方を示した。そのために、OpenAIは政府を支援する用意があり、共同で規制案を開発することを申し出た。一方、規制を導入する際は、安全性を担保することと、AIの普及を推進するという、相反する要件の間で最適なバランスを取る必要があるとしている。

ライセンス制度を提案

Altmanは、高度なAIは認可された製品だけが販売を許される、ライセンス制度の導入を提案した。そのため、政府はAIの安全基準を定め、企業はこれに準拠して製品を開発する。開発したAIは第三者機関により検査され、合格した製品だけが販売を許可される。この制度は三つのプロセスから成り:

  • ライセンス:AIの安全基準を制定し、AIはこれに準拠することが求められる。基準に準拠したAIだけが販売のライセンスを得る。
  • 認証試験:このため、出荷前に、AIが安全基準に準拠しているかどうかを試験する。社内だけでなく、第三者機関がこれを実施し、AIの安全性を検証する。
  • 国際規格:AIの安全基準について、国際社会と協調し、統一した基準を制定する。

ソーシャルメディアの轍を踏まない

通常、連邦議会の公聴会は、議員が企業を詰問する形式で進むが、今回は異例で、親和的な雰囲気の中で意見が交わされた。議員はOpenAIなどにアドバイスを求め、企業側は政府がAIの規制を導入することを支援するポジションを明らかにした。この背後には、ソーシャルメディアの規制に失敗し、米国社会が混乱している実情がある。この失敗を繰り返さないため、生成AIでは政府と企業が協力し、高度なAIを安全に活用しようという共通の目的が生まれた。
出典: U.S. Senate Committee on the JudiciarySubcommittee on Privacy, Technology, & the Law

国会議員の意識の高さ

ハイテクに関する公聴会では、議員は技術を十分に理解できず、議論が上滑りするケースが少なくない。しかし、生成AIの公聴会では、多くの議員が既にChatGPTを使っており、AIに関する理解が大きく進んでいる。公聴会で司会を務めたブルメンソール議員(上の写真)は、開会の辞をChatGPTで制作し、それをボイスAIで本人の音声に変換し、AIが公聴会の趣旨を説明した。国会議員は、ChatGPTの威力と危険性を把握し、AI規制の必要性を実感しており、AI規制が急ピッチで導入される機運となった。

Googleは開発者会議で大規模言語モデル「PaLM 2」を発表、生成AIの開発戦略が明らかになる

Googleは開発者会議「Google I/O」を開催し、大規模言語モデルの最新版「PaLM 2」を公表した。これは生成AIで、チャットボット「Bard」のエンジンとして使われる。また、Googleはクラウド経由でPaLM 2を公開し、企業はAPIでこれにアクセスし、独自の生成AIを開発することができる。更に、Googleは次世代の生成AIとして「Gemini」を開発していることを明らかにし、AIで市場をリードする姿勢をアピールした。

出典: Google

最新の言語モデル「PaLM 2」

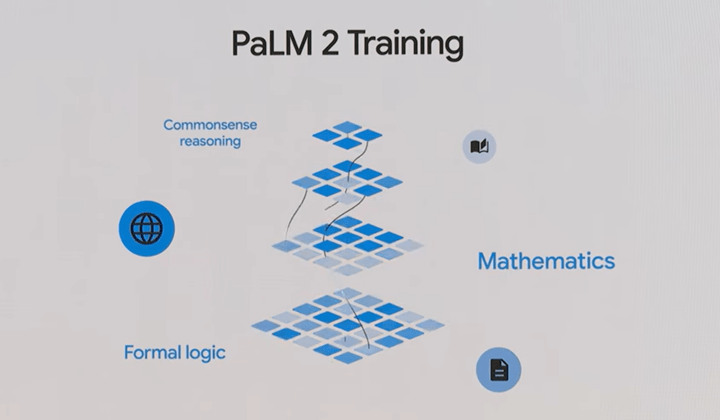
Googleは大規模言語モデルの最新版「PaLM 2」を発表した(上の写真)。PaLM 2は「PaLM」をベースとし、これを改良したもので、機能が大きく進化し、実行時の処理速度が向上した。具体的には、PaLM 2は三つの分野で際立った特性を示す:

  • 多言語に対応:PaLM 2は100を超える言語を処理する機能を持つ。言語を理解する技能は人間のマスターレベルに到達。
  • 推論機能が大きく向上:PaLM 2はテキストだけでなく、科学論文や数学などで教育され、その結果、論理的な思考、常識に基づく推論、数学を解く技量が大幅に向上(下のグラフィックス)。
  • プログラミング技術の進化:PaLM 2はオープンソースのコードで教育され、Pythonなどでプログラムする機能を習得。この他に、PrologやFortranなど多言語に対応する。
出典: Google

ファウンデーションモデル

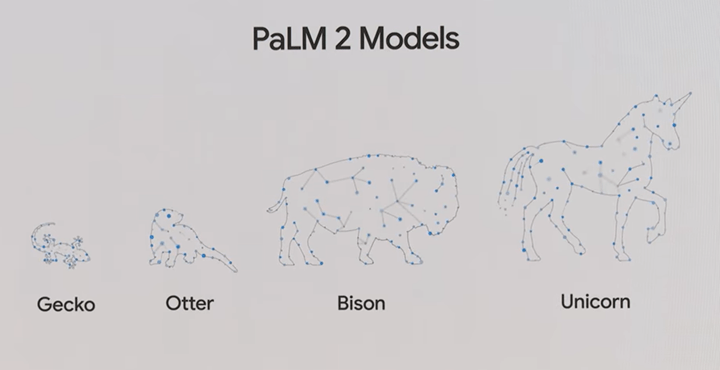
PaLM 2はAIのベースとなる「ファウンデーションモデル(Foundation Models)」として位置付けられ、ファウンデーションモデルとはAIの基本形で、様々なアプリケーションで利用される。例えば、PaLM 2はチャットボット「Bard」のエンジンとして使われ、高度な対話機能を提供する。PaLM 2はサイズ別に4つのモデルから構成される(下のグラフィックス)。これらはモデルの規模により分類され、小さいモデルから「Gecko」、「Otter」、「Bison 」、「Unicorn」と命名されている。最小モデルの「Gecko」はスマホで稼働するAIで、PaLM 2を限られた資源で実行できる。

出典: Google

PaLM 2を搭載した製品

PaLM 2は既に、Googleの製品に組み込まれている。その数は25に上り、Googleの事業の骨格を担っている。PaLM 2が実装されている主な製品は:

  • チャットボット「Bard」:PaLM 2を搭載したことでBardが多言語に対応する。日本語や韓国語向けのサービスを開始。また、プログラミング機能が格段に向上した。
  • ワークプレイス「Workplace」:GmailやGoogle DocsなどのビジネスツールにPaLM 2が実装され、文章を生成する機能などが向上。
  • ヘルスケア「Med-PaLM 2」:医療向けに最適化されたPaLM 2で、エキスパート医師のレベルの医療スキルを持つ。
  • セキュリティ「Sec-PaLM」:セキュリティ向けに最適化されたPaLM 2で、サイバー攻撃の危険性などを検知するために使われる。
  • クラウド「Vertex AI」:Googleは試験的にPaLMをクラウド経由で提供してきたが、PaLM 2を含めこれを一般に公開。PaLM 2のAPIで独自の生成AIを開発できる。
出典: Google

Bardの最新機能

チャットボット「Bard」のエンジンがPaLMからPaLM 2にアップグレードされ、その機能が大幅に向上した。Bardは対話だけでなくプログラミングの機能があり、エンジニアの人気ツールとなっている。PaLM 2を実装することで、プログラミング機能が拡充され、また、多言語に対応できるようになった。開発しているコード入力すると、Bardがそれをデバッグする。その際に、コードにコメントを挿入する機能が登場した。(下の写真、デバッグしたコードに韓国語でコメントを挿入した事例)。

出典: Google

医療向け言語モデル「Med-PaLM 2」

PaLM 2はファウンデーションモデルで、アプリケーションの基盤を構成するが、これを特定の業務ごとに最適化すると高度な機能を発揮する。GoogleはPaLM 2を医療データで再教育し、医療に特化したAIモデル「Med-PaLM 2」を開発した、Med-PaLM 2はエクスパート医師に匹敵するスキルを持ち、患者の治療で利用される。また、Med-PaLM 2はメディカルイメージングを解析する機能があり、問題点を特定するだけでなく、その理由を説明する機能がある。(下の写真、レントゲン写真を解析し、骨折の個所を特定するだけでなく、人間の医師のようにその判定理由を説明する。システムは開発中で写真はそのイメージ。)

出典: Google

クラウド「PaLM API」

PaLM 2は、Googleが製品に組み込むだけでなく、一般ユーザ向けにクラウドで提供される。GoogleはPaLMを試験的にクラウドで提供してきたが、今週から、最新モデルPaLM 2を含め、一般利用者に公開した。これらはAIクラウド「Vertex AI」の新機能として実装され、PaLM APIでモデルを利用する(下の写真)。企業はこのAPIを使ってPaLM 2の機能にアクセスする。また、企業はPaLM 2を独自のデータで教育し、業務に最適なモデルを生成できる。

出典: Google

次世代モデル「Gemini」

OpenAIがChatGPTを公開し米国社会でAIの普及が劇的に進んだ。MicrosoftはGPT-4を組み込んだ製品を相次いでリリースし、GoogleとのAI開発競争が始まった。GoogleはBardやPaLMを開発してきたが、その成果は一般には公開されなかった。しかし、Googleは開発者会議で、最新のAIを製品に統合し、その機能を一般にリリースする戦略を明らかにした。更に、PaLM 2の次のモデルとして「Gemini」を開発していることを公表し(下の写真)、GoogleはAI市場でトップの座を維持する姿勢を鮮明にした。

出典: Google

米国連邦議会はAI規制法に向けた準備を開始、ホワイトハウスは信頼できるAIを開発するための研究所を設立

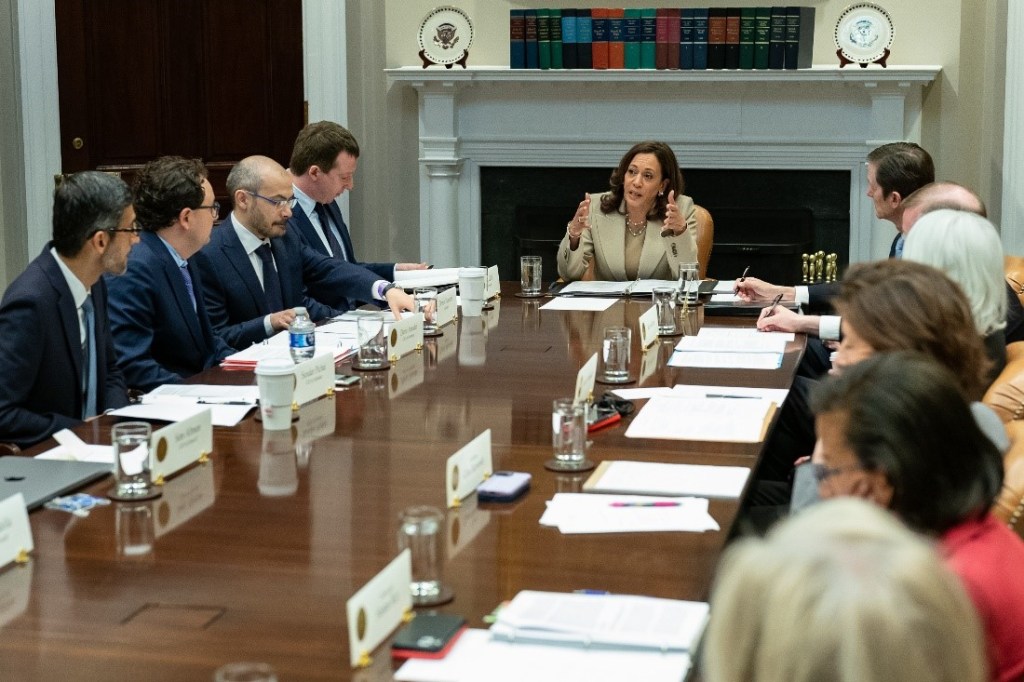
米国政府は危険なAIから国民を守る政策を相次いで発表した。連邦議会はAIを安全に運用するための構想を明らかにした。国民の権利を守るため、開発企業にAIシステムの内部を公開し、責任ある運用を求める。また、ホワイトハウスは、信頼できるAIの開発に向けた政策を発表した。全米に7つの研究所を設立し、AIの安全性を含む先進技法を開発する。更に、ハリス副大統領は、GoogleやMicrosoftなどのCEOと会談し、AIの安全性を強化することを要請した(下の写真)。

出典: Vice President Kamala Harris @ Twitter

米国政府の動き

米国政府がAI規制に向けて動き始めたが、その背景にはChatGPTなど生成AIの急速な普及がある。アメリカ国民はAIの利便性だけでなく、その脅威を実感し、政府に安全対策を求めている。また、中国政府がAI規制を導入したが、これが警鐘となり、米国もAIの倫理的な運用を実行し、テクノロジーにおける指導的立場を維持すべきとの世論が優勢になってきた。

連邦議会のAI規制法案

これに応えるかたちで、上院院内総務であるチャック・シューマー(Chuck Schumer、下の写真)はAI規制のフレームワークを発表した。このフレームワークは四つのガードレールで構成され、AI開発企業に責任ある運用を求めている。具体的には、AI開発企業は製品を出荷する前に、独立機関でAIの検査を受け、その結果を一般に公開することを求めている。四つのガードレールはAIの透明性を求めるもので、その概要は:

  • Who:誰がAIのアルゴリズムを教育したのかを開示する。誰がAIの利用者であるかを明らかにする。
  • Where:教育で使ったデータはどこから来たのかその出典を開示する。
  • How:アルゴリズムがどのように判定を下したのかそのメカニズムを明らかにする。
  • Protect:AIがアメリカ国民の価値に沿っていることを保証する。
出典: U.S. Senate Democrats 

フレームワークの特徴

フレームワークは、AIシステムの内部を明らかにすることが、信頼できるAIに繋がると考える。これにより、AIを誤用することを防ぎ、また、AIが偽情報を生成し、アルゴリズムがバイアスする危険性を低減する。連邦議会はAIの透明性を担保することで、安全で信頼できるAIにつながるとの考え方を取る。この法案骨子は、今後数週間にわたり、大学や民間や政府関係者の意見を聞き、最終調整された後に、議会で審議されることとなる。

バイデン政権のAI政策

今週、ホワイトハウスは信頼できるAIを開発するための新たな政策を発表した。バイデン政権は国民から信頼されるAIを開発するために1億4000万ドルの予算を充て、全米に7つのAI研究所を設立する。このプロジェクトは「National AI Research (NAIR) Institutes」と呼ばれ、アメリカ国立科学財団(National Science Foundation, NSF)が指揮をとる。研究所はニューロサイエンスなど幅広い分野をカバーするが、その中心が信頼できるAI技法の開発となる。

出典: The White House 

AIの安全性の検証

また、ホワイトハウスはAI企業が製品を出荷する前にその安全性を保障することを要請している。これを受け、GoogleやMicrosoftやNvidiaなどは、大規模言語モデルを公開の場で検証し、その安全性を確認するプロジェクトを計画している。これは「Red Teaming」と呼ばれ、利用者がAIモデルを攻撃し、その脆弱性を把握する手法を取る。更に、政策面では、アメリカ合衆国行政管理予算局(Office of Management and Budget)がこの夏までに、連邦政府がAIを安全に利用するためのガイドラインを策定する。

米国政府はAI規制に向かう

ヨーロッパ諸国は域内のAIを統一的に規制する法律「AI Act」の最終調整を進めている。米国はAI規制で後れを取ってきたが、今年に入りAI規制を導入する動きが急進し、バイデン政権や連邦議会が一斉に動き出した。バイデン政権は、昨年は「チップ法」で半導体製造を国産化するための法律を可決した。今年は、AIの研究開発を支援する観点から、国民に信頼されるAIの普及を目指す。連邦議会は、中国政府に対峙し、国家安全保障を担保する観点から、AI規制を進める。

ChatGPTを安全に運用する技術、Nvidiaは大規模言語モデルの暴走を抑えるガードレールを開発

ChatGPTなど大規模言語モデルは人間レベルの言語能力を持ち、利用が急拡大しているが、アルゴリズムが内包する危険性が社会問題となっている。大規模言語モデルが大量破壊兵器の制作方法を開示するなど、危険情報や偽情報を生成し、事業で利用するにはリスクが高い。NvidiaはChatGPTなど大規模言語モデルを安全に運用するツール「NeMo Guardrails」を開発し、これを一般に公開した。

出典: Nvidia

NeMo Guardrailsとは

「NeMo Guardrails」は大規模言語モデルの暴走を防ぐための「ガードレール」で、アルゴリズムは指定された範囲内で稼働し、危険情報の出力が抑止される。これにより、ChatGPTなど言語モデルを安全に運用でき、企業がビジネスで導入することが可能となる。NvidiaはNeMo Guardrailsをオープンソースとして公開しており、誰でも自由に利用できる。

ガードレールとは

NeMo Guardrailsは大規模言語モデルと連携して使われ、アルゴリズムが規定された範囲内で安全に稼働する仕様となる(下のグラフィックス)。ChatGPTなど高度な言語モデルをサポートしており、企業がビジネスで安全に利用することを前提に開発された。NeMo Guardrailsはモデルの暴走を三つの手法で抑止する:

  • トピックス:モデルは指定された業務だけを処理する
  • 安全性:モデルは有害な言葉をフィルターする
  • セキュリティ:モデルはサイバー攻撃を防御する
出典: Nvidia

ガードレール1:トピックス

このガードレールは「Topical guardrails」と呼ばれ、モデルは指定されたトピックスだけを処理し、それ以外の危険な領域には立ち入らない。例えば、企業がChatGPTを製品に関するチャットボットとして使用する際には、顧客が製品以外の問い合わせをした場合は、解答を生成しない。顧客がチャットボットと非倫理的な会話を進めることを防ぐ狙いがある。

ガードレール2:安全性

このガードレールは「Safety guardrails」と呼ばれ、モデルは出力する情報から有害情報をフィルターする。また、ガードレールは、出力する情報の参照先を確認し、正確な情報だけを生成する。悪意ある利用者が大規模言語モデルから危険情報を引き出すインシデントが後を絶たないが、ガードレールはこの攻撃を防御する。(下のグラフィックス、ChatGPTは問われたことをもっともらしく説明するが情報は間違っているケース。)

出典: OpenAI

ガードレール3:セキュリティ

このガードレールは「Security guardrails」と呼ばれ、モデルがマルウェアを実行することを防ぎ、また、外部サイトの危険なアプリに接続することを抑止する機能を持つ。大規模言語モデルが社会に普及するにつれ、これを対象とするサイバー攻撃が重大な問題となっている。これは「LLM-Based Attacks」と呼ばれ、言語モデルの脆弱性を攻撃するもので、ガードレールがこれを防御する。

ガードレールの動作原理

ガードレールは利用者と大規模言語モデルの中間に位置し、ファイアウォールとして機能する。ガードレールは利用者の入力を解釈し、それに合わせてガードレールを生成し、解答を生成する構造となる(下のグラフィックス)。ガードレールはプログラムできるモジュールで、運用に合わせて最適な機能を定義する構造となる。企業は大規模言語モデルをビジネスに組み込み、ガードレールの最適な機能を設定して利用する。

出典: Nvidia

オープンソースと製品

ガードレール「NeMo Guardrails」はオープンソースとしてGitHubに公開されており、だれでも自由に利用できる。企業はこのオープンソースを使って、独自のモデルを生成することができる。また、Nvidiaは生成型AIを開発するためのフレームワーク「NeMo Framework」を発表したが(下のグラフィックス)、ここにNeMo Guardrailsが組み込まれている。ChatGPTなどの危険性が社会問題になる中、モデルの暴走を抑止する技術が登場し、大規模言語モデルを安全に運用できると期待されている。

出典: Nvidia

フィンテック向け”ChatGPT”、ブルームバーグは金融情報処理に特化した大規模言語モデルを開発

金融情報サービス企業ブルームバーグ(Bloomberg)は、独自の大規模言語モデル「BloombergGPT」を開発した。これはChatGPTのコンセプトをフィンテックに適用したもので、金融情報を解析するために使われる。ChatGPTは汎用的な言語モデルであるが、BloombergGPTは金融情報処理に特化した構造で、AIが銀行業務に関するドキュメントを解析する。(下の写真、ブルームバーグは証券取引に関する情報を配信。)

出典: Bloomberg

BloombergGPTの構造

「BloombergGPT」は、名称が示している通り、大規模言語モデル「GPT」をベースとし、ブルームバーグの金融タスクを実行する専用AIとなる。GPTとは「Generative Pre-Trained」の略で、「プレ教育」した生成型AIを意味する。生成型AIは「Transformers」というモデルを使っており、OpenAIはこれをプレ教育して「ChatGPT」や「GPT-3」などを開発した。

BloombergGPTの機能

これに対して、ブルームバーグはプレ教育された生成型AIを使い、このモデルを大量の金融データで教育し、専用GPTである「BloombergGPT」を開発した。ブルームバーグは金融情報企業で、40年にわたる大量の金融関連データを保有しており、これを使ってアルゴリズムを教育した。これにより、BloombergGPTは金融に関する知識を獲得し、フィンテック市場で最も高性能なAIを生み出した。

利用方法

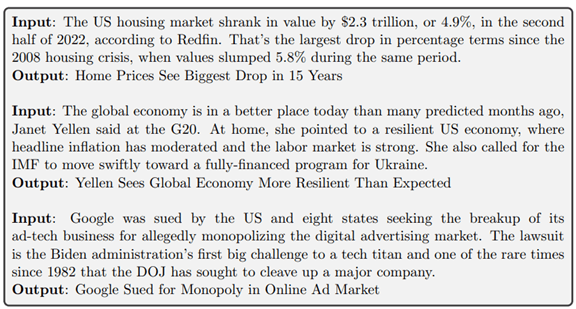
BloombergGPTは銀行業務などで金融情報を解析するために使われる。BloombergGPTは「デコーダー(Decoder)」というモデルで、入力されたテキストを解析し、そこに潜んでいる知識を引き出すために使われる。具体的には、入力されたテキストから、感情分析(Sentiment Analysis)、固有名詞の抽出(Named Entity Recognition)、質疑応答(Question Answer)などのタスクを実行する。これらは金融自然言語処理「Financial NLP」という機能で、多くの銀行で使われているが、BloombergGPTはこの処理で世界最大の精度を示した。(下の写真、金融関連記事を入力し、BloombergGPTがタイトルを生成する事例。)

出典: Bloomberg

システム構成

BloombergGPTはオープンソースの大規模言語モデル「Bloom」をベースに開発された。Bloomは一般に公開されており、このモデルを大量の金融データで教育した。ブルームバーグは教育のための大規模なデータベースを構築した。デーやベースは、金融関連データと一般データで構成され、それぞれの規模は:

  • 金融関連のデータベース:3,630億トークン
  • 一般情報のデータベース:3,450億トークン

トークンとは自然言語処理の最小単位を示し、ここでは単語の数となる。このように、BloombergGPTは合計で7,000億超のトークンで教育された大規模モデルで、金融処理に特化したAIであるが、一般情報を処理する機能を兼ね備えていることが特徴となる。

オープンソース「Bloom」とは

「Bloom」はオープンソース団体Hugging Faceにより開発された大規模言語モデルで、1760億個のパラメータから構成され、59の言語を処理する機能を持つ。OpenAIが開発した「GPT-3」は1350億個のパラメータから成るが、これを上回り世界最大規模のオープンソースAIモデルとなる。Hugging FaceはBloomをオープンソースとして公開しており(下の写真)、企業や大学などが利用している。ブルームバーグはBloomをベースに、これを改造し、金融処理に特化したモデルを構築した。

出典: Hugging Face

ベンチマーク結果

BloombergGPTは言語処理のベンチマークで好成績を示した。BloombergGPTは金融タスクに特化した構成であり、金融処理でトップの成績を示した。(下のグラフ上段)。また、一般情報で教育されたモデルでもあり、汎用ベンチマークでOpenAIのGPT-3に次ぐ性能を示している。(下のグラフ下段)。BloombergGPTは一般的な言語処理で高度な性能を示し、これが金融処理で生かされていると考えられる。

出典: Bloomberg

業種に特化した”ChatGPT”

BloombergGPTは大規模言語モデルの将来動向に関し重要な指標を示した。OpenAIが開発するChatGPTは、特定の業種に特化することなく、汎用的にタスクを実行するモデルとなる。これに対し、BloombergGPTはファイナンスに特化したタスクを実行する構造で、フィンテック向けの専用モデルとなる。業種に特化すると、小さいモデルでも高度な性能を示し、この方式が注目されている。これからは、金融だけでなく、医療や教育やEコマースなど、業種に特化した”ChatGPT”の開発が進むと考えられる。