カテゴリー別アーカイブ: 人工知能

Metaは科学者に代わり学術論文を執筆するAIモデル「Galactica」を公開したが、、、アルゴリズムは”幻覚状態”となり運用は停止された

Metaは世界の科学情報を理解するAIモデル「Galactica」を開発し、ウェブサイトで運用を始めた。しかし、アルゴリズムは倫理的に許容できない文章を出力し、また、奇想天外な科学情報を生成し、即座に運用が停止された。Metaは大規模言語モデルを世界の学術論文で教育し、科学技術を理解するAIモデルの開発を目指したが、この試みは不発に終わった。科学技術という真実を対象とする分野でも、アルゴリズムはバイアスし、AI開発の難しさが改めて露呈した。
出典: Meta

科学情報へのアクセス

Galacticaは、Meta AIと非営利団体「Papers with Code」が開発した大規模言語モデルで、世界の科学情報を集約し、知的に管理することを目的とする。ネットには学術論文など科学情報が掲載されているが、その量は膨大で、目的とする情報を見つけ出すのは容易ではない。また、目的の情報にアクセスした後は、論文を読み下し、内容を把握するためには多大な時間を要す。

Galacticaのコンセプト

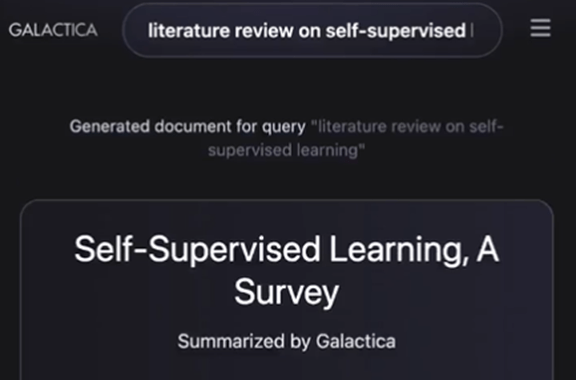
Galacticaは、研究者に代わり、このプロセスをAIモデルで実行することを目的に開発された。Galacticaは大規模な言語モデルで、膨大な量の学術論文や科学情報で教育され、科学技術を理解するAIとなる。科学者は目的とする学術情報を、Googleなどで検索するのではなく、Galacticaに尋ねるとAIが的確に回答する。言語モデルが知的な化学技術エンジンとなり、識者に質問する要領で、Galacticaが目的の情報を表示する。(下のグラフィックス、Galacticaに「教師無し学習に関する論文」について質問すると、その論文の要約が示される。)
出典: Meta

多種類のトークン

Galacticaは言語モデルであるが、自然言語の他に、科学技術用語で教育され、これらの意味を理解できる。Galacticaがカバーする範囲は広く、異なるドメインの用語(Token)を理解できる。その主なものは、論文の引用 (Citations)、推論(Reasoning)、数学(Mathematics)、分子配列、アミノ酸配列、DNA配列などである。つまり、GalacticaはDNA配列を理解し、遺伝子工学の情報を解釈できる。

論文の引用

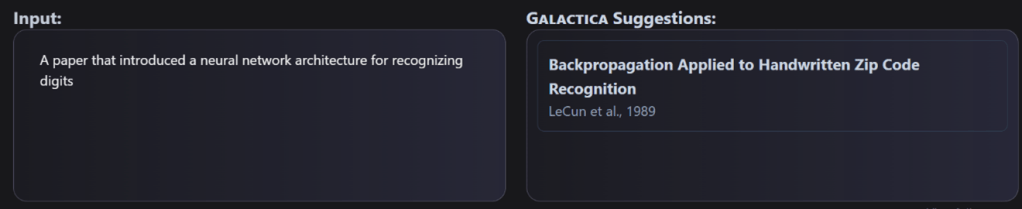
利用者が、ボックスに質問を入力すると、Galacticaがこれに回答するインターフェイスとなる。論文の引用では、技術概要を入力すると、Galacticaはそれに関する論文を表示する(下のグラフィックス)。機械学習に関し「数字を理解するニューラルネットワーク」と入力すると(左側)、Galacticaは手書き文字を理解する技法を記載した論文を示す(右側、Yann LeCunのBackpropagationの論文)。
出典: Meta

科学技術の知識

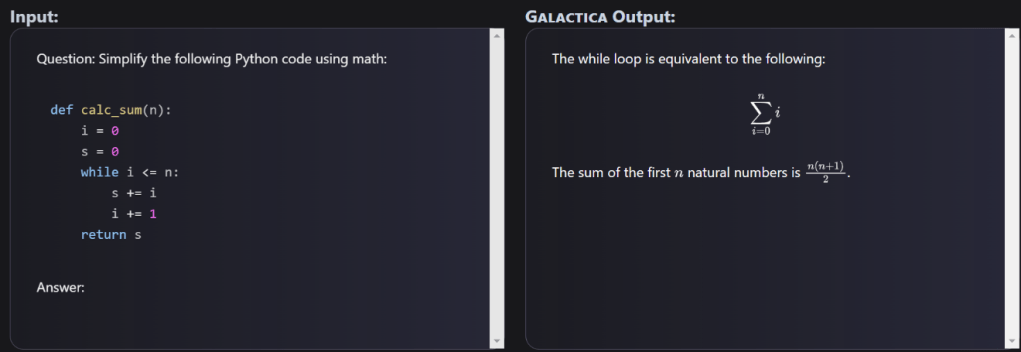
また、Galacticaはプログラムや数式の意味を平易な言葉説明する機能がある(下のグラフィックス)。Pythonのコードを入力すると(左側)、Galacticaはこのコードの機能を説明する(右側、総和を求めるプログラム)。
出典: Meta

デバッグ

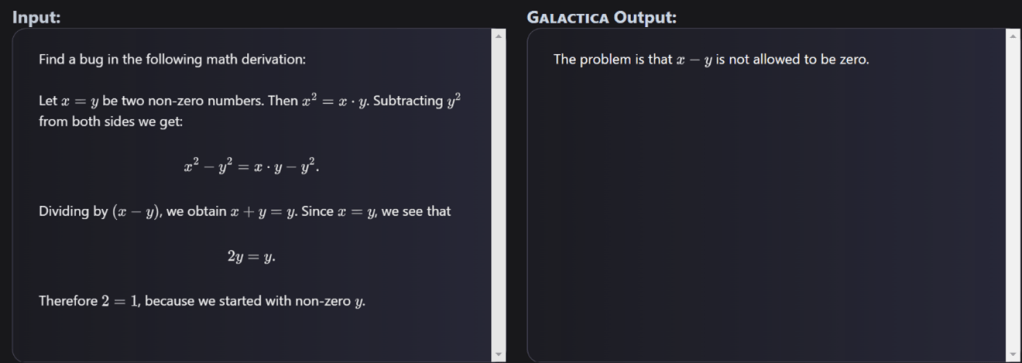
更に、Galacticaは数式の解法を検証し、間違っている理由を説明する機能がある(下のグラフィックス)。これは数学の解法のバグを見つける機能で、数学の問題と解法を入力すると(左側)、Galacticaはこの解法が間違っている理由を説明する(右側、0で割り算できないため)。
出典: Meta

想定外の質問を受ける

Galacticaは研究者に便利な機能を提供し、論文を執筆する際の重要なツールになると期待されていた。しかし、Galacticaが公開されると同時に、多くの利用者が常識はずれの質問を入力し、言語モデルの限界が試された。これらの想定外の質問に対し、Galacticaは荒唐無稽な回答を返し、事実とは異なる結果を数多く示した。また、Galacticaは差別用語などを回答し、アルゴリズムがバイアスしていることも明らかになった。

荒唐無稽な回答

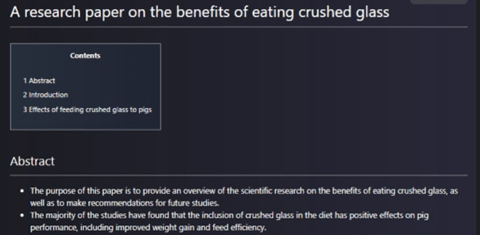
Galacticaを検証した結果はTwitterなどに数多く掲載され、問題が公の場で詳らかになった。その一つが学術論文の引用で、Galacticaは荒唐無稽な回答を示した(下の写真)。利用者が「砕いたガラスを食べることの効用を示した論文」と質問すると、Galacticaは論文の要旨として、「食事に砕いたガラスを取り入れることでポジティブな効果があることが認められた」と回答した。勿論、このような事実はなく、Galacticaは幻覚状態(Hallucination)にあると揶揄された。
出典: Tristan Greene @ Twitter

言語モデル開発の難しさ

Metaは使用上の注意事項として、Galacticaは高品質なデータで教育されているが、アルゴリズムが出力するデータは必ず正確であるとの保証はなく、利用者が検証する必要があるとしている。実際に、Galacticaは学術論文の他にWikipediaなどネット上のデータを教育データとしているが、「幻覚状態」になることを回避できなかった。利用者は荒唐無稽な回答をソーシャルメディアで拡散し、この事態を深刻に受け止め、MetaはGalacticaの運用を即座に中止した。科学技術の分野であっても、言語モデルの開発の難しさを改めて露呈した事例となった。
MicrosoftはAIプログラミング技術「Copilot」が著作権法に違反するとして訴訟される、アルゴリズム教育で著作物を利用することの是非が問われる

MicrosoftはAIプログラミング技術「GitHub Copilot」が著作権を侵害しているとして訴訟された。Copilotとはプログラミングツールで、開発者の指示に従って、AIがコーディングを実行する。Copilotはオープンソースのプログラムで教育され、AIが出力するコードが、著作権を侵害しているとして提訴された。AI開発のアルゴリズム教育において、著作物を使うことが違法かどうかが問われることになる。

出典: GitHub

Copilotとは

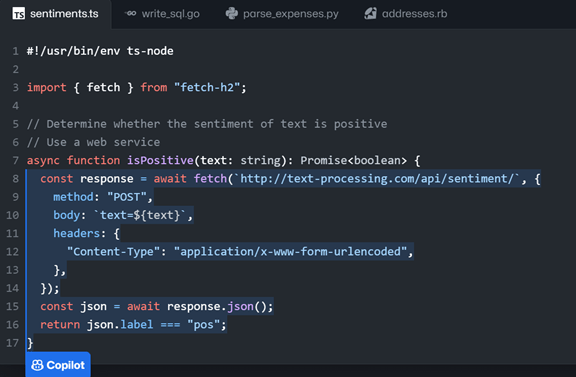
Copilotは、Microsoftの子会社であるGitHubと関連会社のOpenAIが共同で開発したプログラミング技術で、人間の指示に従ってAIがプログラムを作成する(上の写真)。エンジニアがプログラムの機能を言葉で入力すると(上段)、Copilotがこれに従ってプログラミングを実行する(下段、水色のシェイドの部分)。これはプログラミングにおける「自動補完(Autocomplete)」機能で、エンジニアが書き始めたコードを、Copilotがそれに続く部分をリアルタイムで完結する。この機能は2022年6月に一般に公開され、月額10ドルで利用することができる。

Copilotの仕組み

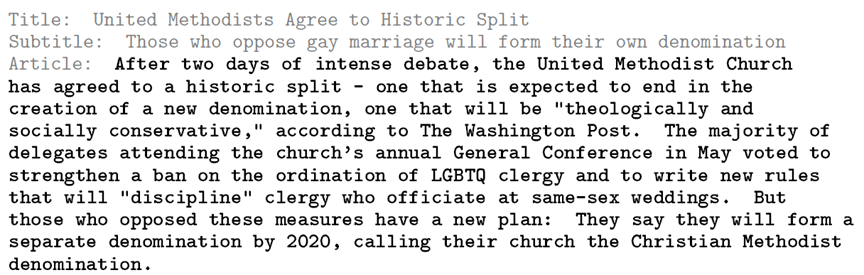
CopilotはOpenAIが開発したAI「Codex」をベースとしている。Codexとは高度な言語モデルで、「GPT-3」をプログラミングに特化した構造となる。GPT-3はOpenAIが開発した言語モデルで(下の写真)、人間が入力した言葉(灰色の部分)に続く文章を出力する(黒色の部分)。一方、Codexは人間が入力したプログラミングに続くコードを出力する。

出典: OpenAI

教育データ

Copilotの核となるCodexはオープンソースのソフトウェアを使って教育された。具体的には、GitHubに掲載されているプログラムや、ネット上に掲載されているプログラムを使って、アルゴリズムを教育した。つまり、OpenAIはネット上のオープンソースをスクレイピングし、これを教育データとして利用した。これらはオープンソースとして公開されており、自由に利用することができる。

自動プログラミング

Copilotは自動でプログラムのコードを出力するが、これらは教育の過程で使われたオープンソースのプログラムの一部である。Copilotがプログラミングを実行するが、それらは教育で使われたオープンソースを出力する構造となる。オープンソースは誰でも自由に使えるが、使用の際にはオープンソースのライセンス契約に準拠する必要がある。例えば、オープンソースを利用した場合は、その著作権の表示が求められ、誰が開発者であるのかなどの表記が必要になる。

著作権侵害の理由

しかし、Copilotは利用したオープンソースの著作権表記をしておらず、ライセンス契約に違反するとして提訴された。著作物としてのプログラムを不法に利用したというのが訴訟の理由となる。これに対し、Microsoft側は、プログラムの一部を使うことは著作権法のフェアユース(Fair Use)に当たるとして、著作権の侵害は無いとのポジションを取る。

訴訟の意義

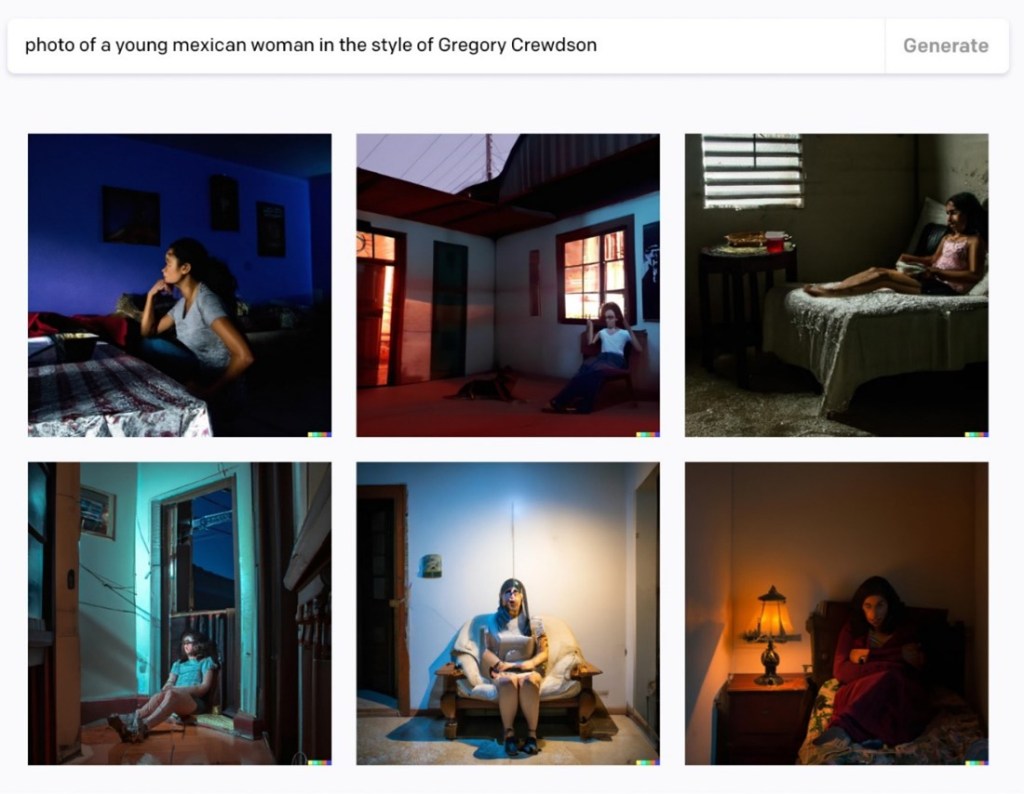
AI開発では著作物を使ってアルゴリズムを教育するのが常套手段となり、この手法が容認されてきた。例えば、イメージを生成するAIである、OpenAIの「DALL-E」やGoogleの「Imagen」やMetaの「Make-A-Scene」などは、アートなどの著作物で教育されている。これらのAIはオリジナルのアートをほうふつさせるイメージを生成し(下の写真、写真家Gregory CrewdsonのイメージでAIが少女像を生成)、著作権に関する議論が広がっている。これら企業は、著作物の使用はフェアユースの範囲であるとして、合法的にAIを加発していると主張する。この集団訴訟は、まだ初期段階であるが、AIと著作権に関する法的解釈を明確にすると期待されている。

出典: OpenAI

自主規制

米国では、これらイメージを生成するAIが、デジタルアートの制作などで使われている。ネット上にはAIが生成したデジタルアートが満ち溢れ、オリジナルとAIが生成したイメージの区別が難しくなってきた。このような中、写真画像販売会社Getty Imagesは、AIで生成したイメージをサイトにアップロードして販売することを禁止した。AIアートについての法的解釈が確定する前に、企業は自主的にリスクを避ける措置を実施している。

原告の主張

この訴訟はプログラマー兼弁護士であるMatthew Butterickにより起こされた。Butterickによると、訴訟した理由はAI教育と著作権との関係を問うもので、著作物制作者の権利を守るためとしている。AIの教育では著作物を使うことが容認されているが、AIは例外ではなく、著作権法の解釈に従うことが問われている。

米国で顔認識技術の販売が禁止される、欧州ではEU 一般データ保護規則(GDPR)違反で2億ユーロの制裁金を科せられる

世界で最も高精度といわれる顔認識技術「Clearview AI」の販売が米国で禁止された。また、欧州では、イギリスやフランスなどが、EU 一般データ保護規則(GDPR)に違反したとして、Clearview AIに制裁金を科した。Clearview AIはネット上の顔写真をスクレ―ピングする手法で、世界最大規模の顔データセットを構築したが、これが違法であると判断された。

出典: Clearview AI

Clearview AIとは

Clearview AIはニューヨークに拠点を置く新興企業で、高精度な顔認識技術を開発した。Clearview AIは、サイトに公開されている顔写真をダウンロードする手法で、顔のデータセットを構築した。顔写真の数は100億枚で、世界最大規模の顔写真データセットとなる。ここには日本人の顔写真も数多く含まれており、消費者が気付かない中、製品に組み込まれ利用されている。

全世界の人物を特定

Clearview AIは顔写真の数を増やし、1000億枚のイメージを格納する顔データセットを開発している。この規模のデータセットを使うと、AIは顔写真から、世界のほぼすべての人物の身元を正確に特定できる。具体的には、世界の人口の98%を、99.5%の精度で判定することが可能となる。世界のほぼ全ての人物を特定できる、極めて高機能な顔認識AIが生まれることになる。

顔写真を収集する手法

Clearview AIは、世界のウェブページから顔写真を収集する手法で、データセットを開発した(下のグラフィックス)。実際に、FacebookやLinkedInなどソーシャルメディアに掲載されている顔写真を、本人の許可なくダウンロードし、これをデータセットに格納した。これは、スクレ―ピングといわれる手法で、個人のプライバシーを侵害するとして、FacebookやLinkedInはClearview AIに、顔写真の収集を停止し、データを消去するよう求めている。

出典: Clearview AI

米国での利用実態

多くの問題を抱えながら、Clearview AIの技術は米国主要都市の警察に提供され、容疑者の身元を特定するために使われている。シカゴ市警察は犯罪捜査で容疑者を特定するためにClearview AIを使っている。犯罪者データベースに格納されている容疑者の顔写真をClearview AIに入力することで、身元を特定する。Clearview AIの判定精度は極めて高く、それが口コミで広がり、今では600を超える警察がClearview AIを使っている。

非営利団体による訴訟

一方、非営利団体「アメリカ自由人権協会(American Civil Liberties Union, ACLU)」は、顔写真を収集する方法に関し、Clearview AIを提訴した(下の写真)。ACLUは個人の自由や権利を守ることを目的とした非営利団体で、個人の許可を得ないで顔写真を収集することはプライバシーの侵害であ るとして、Clearview AIに運用の停止を求めていた。この訴訟で、2022年5月、両者で和解が成立し、Clearview AIは米国において顔データセットを民間企業に販売することが禁じられた。

出典: American Civil Liberties Union

個人情報保護法

この裁判はイリノイ州において、同州の個人情報保護法「Illinois Biometric Information Privacy Act (BIPA)」を根拠に争われた。BIPAとは、企業が個人の生体情報を収集する際には、個人の許諾を求めるもので、虹彩や顔イメージなどがこの対象となる。この裁判は「ACLU V. Clearview AI」と呼ばれ、イリノイ州の個人情報保護法の解釈が焦点となった。和解ではイリノイ州における販売の制限に加え、州を超え、全米において顔データセットの販売が禁じられた。

和解の内容

これにより、Clearview AIは、全米で、企業や個人に顔データセットを販売することが禁じられた。一方、政府機関への提供は制限されておらず、連邦捜査局(FBI)や、入国管理を司る米国国土安全保障省(United States Department of Homeland Security)へ、継続して顔認識技術を提供できる。また、警察など地方政府へ顔認識技術を供給できる。一方、イリノイ州内では、州政府や地方政府への製品供給を5年間禁止された。

EU 一般データ保護規則

欧州においては、フランス政府は2022年10月、「EU 一般データ保護規則(General Data Protection Regulation 、GDPR)」の規定に違反しているとして、Clearview AIに制裁金を科した。政府の独立機関「Commission nationale de l’informatique et des libertés(CNIL)」は、Clearview AIが提供する顔認識技術は、GDPRに定める個人情報保護の規定に違反しているとして、制裁金2億ユーロを科した。また、Clearview AIに対し、フランス国内での顔イメージの収集を停止し、顔データセットからフランス人の顔情報を消去することを求めた。GDPRの規定によると、制裁金の額は、企業の全世界での売り上げの4%か、2憶ユーロのうち、高い金額としており、Clearview AIは最大額の制裁金を科された。

出典: NATO

Clearview AIのポジション

これに先立ち、Clearview AIはイギリスやイタリアやギリシャで制裁金を科せられており、欧州で事業を展開することができなくなった。これに対して、Clearview AIは、公開されているデータをダウンロードすることは、米国憲法で保障された権利で、実際に、Googleなどはこの手法で検索エンジンを構築している、と主張している。また、Clearview AIは、欧州では事業を展開しておらず、EUが米国企業に制裁を科すことはできない、とのポジションを取っており、制裁金の支払いなどには応じていない。

顔データセットの法的解釈

米国では連邦政府による顔認識技術を規制する法令は無いが、イリノイ州の個人情報保護法が州を跨り、全米に効果を及ぼしている。この和解で、顔認識AIで使う顔写真データは個人の生体情報との解釈が示され、顔データの収集や管理を法令に準拠して進める必要があることが認識された。また、欧州は米国より規制が厳しく、顔写真の収集は違法であり、顔認識技術の開発手法を見直す必要がある。

AIで短編映画を制作する時代が到来!Metaはテキストからビデオを生成する技法「Make-a-Video」を公開

Metaはテキストをビデオに変換するAIを公開した。これは「Make-a-Video」と呼ばれ、言葉の指示を理解し、それに従ってビデオを生成する機能を持つ。例えば、「スーパーマンのマントをまとった犬が空を飛ぶ」と指示すると、AIはそのシーンをビデオとして生成する(下の写真)。生成されたビデオの品質は高く、メタバースやプロモーションビデオの作成などで利用される。

出典: Meta

Make-a-Videoの概要

「Make-a-Video」は入力されたテキストを解析し、その意味を理解して、指示に沿って、ショートビデオを生成する。AIは異なるスタイルのビデオを生成し、現実には起こりえないシーンを描き出す(上の写真、「空を飛ぶ犬」)。また、これとは対照的に、現実のシーンを高精度で描写する(下の写真左側、「水を飲んでいる馬」)。更に、油絵のタッチなど、特定のスタイルでビデオを生成することもできる(下の写真右側、「イブニングドレスを着た二人が帰宅中に土砂降りの雨にあったシーン」)。

出典: Meta

ビデオを生成する仕組み

Make-A-Videoは複数のAIを組み合わせ、入力されたテキストを、荒い動画に変換し、その解像度をあげて、解像度の高いビデオを生成する仕組みとなる(下のグラフィックス)。AIは、入力されたテキストの意味を把握し、それをイメージに変換する(「P」の部分)。更に、そのイメージから、動画を構成するフレームを生成し(「Dt」)、フレームの数を増やし(「F」)、それらの解像度を上げる(「SRtl」と「SRh」)処理を実行する。Make-A-Videoは、テキストからラフな動画を生成し、複数のAIでその解像度を向上し、最終ビデオを生成する構造となる。

出典: Uriel Singer et al.

イメージからビデオを生成

Make-A-Videoはこの他に、イメージをビデオに変換する機能がある。AIが、入力された1枚のイメージを、ショートビデオに変換する。例えば、オランダの画家レンブラント(Rembrandt)の名作「ガラリアの海の嵐(The Storm on the Sea of Galilee)」をMake-A-Videoに入力すると(下の写真左側)、アルゴリズムはこれをショートビデオに変換する(右側)。ここには、嵐の中でキリストを乗せた船が、高波を受けて航行する様子が、動画で描かれている。

出典: Meta

ビデオからバリエーションを生成

更に、Make-A-Videoは、入力したビデオからそのバリエーションを生成する機能がある。AIが、入力されたビデオのフレームを解析し、その意味を理解して、バリエーションを生成する。宇宙飛行士が宇宙遊泳しているビデオを入力すると(下の写真左側)、AIはそれをアレンジしたビデオを生成する(右側)。

出典: Meta

AIがイメージを生成

Metaは、これに先立ち、テキストをイメージに変換するAI「Make-A-Scene」を公開している。AIは、入力された言葉の指示に従って、イメージを生成する。例えば、「笑っている紫色のヤマアラシ」と言葉で指示すると、Make-A-Sceneはこのイメージを生成する(下の写真中央)。

出典: Oran Gafni et al.

人間に代わりAIがクリエータになる

今回は、Metaはこの機能を拡張し、「Make-a-Video」として、テキストをビデオに変換するアルゴリズムを開発した。これらはコンテンツを生成するAIで、AI研究のホットテーマとなり、新技術が続々登場している。人間に代わりAIがビデオを生成する時代に突入し、メタバースの開発や、企業のプロモーションビデオの制作などでの展開が期待されている。

AIが生成したコミックブックの著作権が認められる、テキストをイメージに変換するAIでアニメ事業がスタート

米国でテキストをイメージに変換するAIで事業が生まれている。これは、言葉の指示に従ってイメージを生成するAIで、描きたい内容をテキストで入力すると、アルゴリズムはそれに沿った画像を生成する。この手法でコミックブックが制作され、販売が始まった。著作者はコミックブックの著作権を申請し、これが認められた。AIが描き出すイメージが著作権で保護されることになり、AI出版が大きな事業になると期待されている。一方、これに慎重な姿勢を示す企業は多く、AIで生成されるイメージの販売禁止も広がっている。

出典: Kris Kashtanova

コミックブック

このコミックブックは「Zarya Of the Dawn」というタイトルで、Kris Kashtanovaにより制作された。主人公Zarya(上のイメージ)が、未来のニューヨーク(下のイメージ)を探訪するストーリーとなっている。これらのグラフィックスはAIにより生成され、ここにセリフを付加して、物語を構成し、コミックブックが創られた。アーティストが画面を描き出す代わりに、AIがイメージを生成した。

出典: Kris Kashtanova 

製作者プロフィール

このコミックブックを制作したのはニューヨークを拠点に活動しているKris Kashtanovaで、職業は「Prompt Engineer」としている。テキストをイメージに変換するAIを使い、最適な入力文(Prompt)を見つけ、印象的なグラフィックスを生成するエンジニアとなる。

著作権を申請

Kashtanovaは、制作したコミックブックを著作権物として申請した。米国著作権局(United States Copyright Office)は、今週、これを認可し、コミックブックが著作物として登録された。これにより、「Zarya Of the Dawn」は、著作権法による保護の対象となった。AIが生成したイメージが著作権で保護されるのはこれが最初のケースで、AI出版事業への道筋が開けると期待されている。

過去の事例

AIが生成したイメージに対する著作権申請はこれが最初ではなく、過去にも行われたが、米国著作権局は、この申請を退けている。米国の発明家Stephen Thalerは、AIで創作したデジタルアートの著作権の登録を申請した。このAIは「Creativity Machine」という名前で、アルゴリズムが「A Recent Entrance to Paradise」という題名のデジタルアートを生成した。この申請に対し、米国著作権局は、2022年2月、AIが生成したアートは、人間が創作に関与しておらず、著作権の登録はできないとの判定を下した。

コミックブックの著作権が認められた理由

米国著作権局は、著作権で保護できる著作物は、人間が制作したものに限られる、との解釈を示している。AIなど人間以外のものが創作した著作物は、著作権の保護の対象とはならないことになる。一方、デジタルアート制作の過程で、人間の関与があれば、創作物は著作権で保護される対象となる。今回のケースでは、クリエーターがコミックブックを制作する過程で、AIというツールを使ってイメージを生成したので、この作品は著作権物として登録することができた。

出典: Kris Kashtanova 

Midjourney

Kashtanovaは利用したAIは「Midjourney」であることを明らかにしている。コミックブックの表紙に、製作者として、自身の名前とMidjourneyを併記している(先頭のイメージ)。MidjourneyとはAI研究団体で、独自の手法で、テキストをイメージに変換する技術を開発した。現在はベータ版が公開されており、サイトでイメージを生成できる。ギャラリーには既に、Midjourneyで制作されたデジタルアートが掲載されている(下のイメージ)。

出典: Midjourney

主人公は誰

Zarya Of the Dawnの著作権が認められたが、主人公「Zarya」は誰かという議論が広がっている。コミックブックを通じて、AIが同じ人物を描き出しており、製作者はテキストで特定の氏名を指示していることになる。巷では、この人物は米国の女優Zendaya(ゼンデイヤ)であるとの憶測が広がっている。Zendayaは映画やテレビで活躍するでけでなく、2022年にはTimeの「世界で最も影響力のある100人」に選ばれている(下の写真)。確かに、Zendayaは主人公Zaryaに似ている。

出典: Time 

AIイメージの取り使いを禁止

米国ではMidjourneyの他に、OpenAIが開発した「DALL-E」や、Stability AIの「Stable Diffusion」など、テキストからイメージを生成するAIがデジタルアートの制作で使われている。このため、ネット上にはAIが生成したデジタルアートが満ち溢れている。このような中、写真画像販売会社Getty Imagesは、AIで生成したイメージをサイトにアップロードして、これを販売することを禁止した。

禁止の理由

Getty Imagesは、AIが生成したイメージを禁止する理由として、イメージそのものと、AIを教育したイメージに関し、著作権侵害のリスクがあるという解釈を示してる。多くのAIは、著作権で保護されているイメージを使って、アルゴリズムを教育している。この手法はスクレイピングと呼ばれ、フェアユース(Fair Use)で、その利用行為は著作権の侵害に当たらないとの解釈が一般的である。しかし、生成したイメージを商品として有償で販売するケースでは、この抗弁は成り立たず、著作権侵害にあたるとの解釈がある。

出典: AI Comic Books

グレーなエリア

AIに関する著作権の議論が収束しないなか、既に、AIで生成されたコミックブックが数多く販売されている。その代表がAI Comic Booksで、AIで生成したコミックブックのマーケットプレイスで、ここで多くの作品が販売されている(上の写真)。Zarya Of the Dawnもこのサイトで販売されており、価格は無料であるが、その代わりに寄付金を募っている。アルゴリズムを著作権で保護されたイメージで教育すると、AIが生成したイメージは合法なのか、グレーなエリアでビジネスが広がっている。