カテゴリー別アーカイブ: 人工知能

グーグルスマホ「Pixel 2」でAIチップが稼働、ARでスターウォーズをリアルに生成でき現実と仮想の境界が消滅

映画「スターウォーズ」がGoogleスマホ「Pixel 2」にやってきた。極めて精巧なキャラクターをビデオの中に取り込むことができる (下の写真)。街の中を銀河帝国軍の機動歩兵が歩き、上空をXウイング戦闘機が飛び交うビデオを撮影できる。今までのARとは比べ物にならない精度で、リアルなキャラクターがスマホで生成される。これを可能にしたのがスマホ向けAIプロセッサで、大規模な計算を瞬時にこなす。このプロセッサはAIエンジンとしても使われ、スマホはAIマシンであることが鮮明になった。

出典: Google

拡張現実アプリ

Googleは2017年12月、拡張現実アプリ「AR Stickers」を投入した。このアプリを使うと、ビデオや写真にオブジェクトやテキストをAR (Augmented Reality、拡張現実) として組み込むことができる。多くのスマホでARアプリを使えるが、AR Stickersの特長は高精度でARを実装していることだ。もはや現実と仮想の区別ができない。

銀河帝国軍の機動歩兵が動き出す

AR Stickersは様々なセットを提供しているが、一番人気は映画スターウォーズ最新作「Star Wars: The Last Jedi」のキャラクターである。このセットを選ぶと、映画に登場するキャラクターをビデオの中に取り込める。例えば、銀河帝国軍の機動歩兵「Stormtrooper」を選ぶと、ビデオの中に配置できる。撮影を始めるとビデオの中でStormtrooperが動き喋り出す(下の写真)。一人だけでなく複数のStormtrooperを配置でき、それぞれが独自に動く。これらの機動歩兵は極めてリアルに描写され、動きは滑らかで、現実のキャラクターと見分けがつかない。

出典: VentureClef

反乱同盟軍の戦闘機

反乱同盟軍の戦闘機「X-wing Fighter」を選ぶと、可変翼をX状に広げ空中をホバリングする。戦闘機は背景の明るさに調和し、地上にはその影を落とす。戦闘機を前から撮影するだけでなく、周囲をぐるっと一周して360度のアングルから撮影できる。戦闘機は背景に溶け込み、仮想イメージであるとは思えない。

出典: VentureClef

可愛いロボットBB-8

異なるキャラクターを組み合わせて使うこともできる。雪だるまのようなかわいいロボット「BB-8」を選ぶと、画面の中をころころと動き回る。ここにStormtrooperを加えると、二つのキャラクターがそれぞれ独自の動きをする。時に、二つのキャラクターが鉢合わせして、コミュニケーションが始まる (下の写真)。StormtrooperがBB-8に「向こうに行け」と指示しているようにも見える。

出典: VentureClef

宇宙戦闘機は極めてリアル

「TIE Fighter」を選ぶと、二つのイオンエンジン (Twin Ion Engines) で飛行する宇宙戦闘機が登場する。宇宙戦闘機はイオンエンジン特有の音を出して飛行し、時々レーザーキャノンで攻撃する。TIE Fighterに近寄ってアップで撮影すると、細部まで克明に描写されていることが分かる。機体についた傷や角の摩耗などが極めてリアルに描かれている (下の写真)。モックアップで撮影したとしか思えず、これが仮想のオブジェクトであるとは驚きだ。

出典: VentureClef

開発環境「ARCore」

これらはARアプリ開発プラットフォーム「ARCore」で開発された。GoogleはARCoreを公開しており、パートナー企業もこの環境でARアプリを作ることができる。ARCoreがサポートしているデバイスはGoogle Pixel、Google Pixel 2、及びSamsung Galaxy S8である。AR基礎技術はGoogleの特別プロジェクト「Tango」で開発された。今般、ARCoreが公開されたことで、Tangoはここに集約されることになる。

ARの仕組み

ARとは仮想コンテンツ (スターウォーズのキャラクターなど) を現実社会 (ビデオや写真) に組み込む技術を指し、ARCoreは三つのモジュールから構成される。「Motion Tracking」はARコンテンツの現実社会における位置を把握し、スマホでコンテンツをトラックする技術 (キャラクターの位置決め技術)。「Environmental Understanding」は現実社会でフラットな箇所を検知し、その場所と大きさを把握する技術 (平らな場所を検知する技術)。「Light Estimate」は現実社会における光の状態を把握する技術 (明るさを把握する技術)。

Motion Tracking

カメラが動くにつれ、ARCoreはConcurrent Odometry and Mapping (COM) というプロセスを実行し、カメラの位置関係を把握する。イメージの中の特徴的なポイント (Feature Point、下の写真で○印の個所) を把握し、それらがどのように変化するかをトラックし、空間の中でカメラの位置を把握する。ARCoreはこの動きとスマホの加速度計のデータを組み合わせ、カメラの位置とカメラの向き 「Pose」を把握する。GPSなどの位置情報が無くてもARCoreはピンポイントで位置を把握できる。

出典: Google  

Environmental Understanding

ARCoreは現実社会の中で平らな場所を検知する (下の写真でドットで示されたマトリックスの部分)。平らな場所とはFeature Pointが共通した水平面を持っているところで、これを「Planes」と呼ぶ。テーブルや床などの平らな部分がPlanesとなる。また、ARCoreはPlanesの境界を把握する。これらの情報がアプリに渡され、キャラクターが立つことのできる場所とその範囲を把握する。

出典: Google  

Light Estimate

ARCoreは現実社会の光の状態を把握する。具体的には、カメラで捉えたオブジェクトの平均的な光の強さを把握する。この情報をアプリに渡し、生成するオブジェクトをこれと同じ明るさにする (下の写真、明るい場所の猫は明るく描かれる)。これにより、生成したオブジェクトがリアルさを増し、背景のイメージに溶け込めるようになる。

出典: Google  

Anchors and Trackables

現実社会が理解できると、ARCoreはオブジェクトを生成しその中に置くこととなる。オブジェクトは現実社会に馴染み、自然な形で配置される。ARCoreは周囲の状況を把握しており、利用者はPosesを変えることができる。つまり、カメラを動かしオブジェクトの周囲を周回し、異なる方向から撮影できる。X-wingを周回し背後からも撮影できる (下の写真)。オブジェクトの周りを移動してもX-wingはホバリングを続け、アンカーで固定されているようにその場所に留まる。

出典: VentureClef

AI専用プロセッサ

高度なAR処理をPixel 2で実行できるのはAI専用プロセッサによる。Pixel 2は画像処理と機械学習のための専用プロセッサ「Pixel Visual Core」を搭載している。ARCoreはPixel Visual Coreで処理され、毎秒60フレームを生成し高精度な画像を創り出す。その結果、細部まで詳細に描かれたキャラクターが、画像処理の遅延時間はなくビデオの中を滑らかに動き、本物と見分けがつかなくなる。

ARアプリに先立ち、Pixel Visual Coreは写真撮影やAIで使われている。Pixel 2のカメラアプリは「HDR+」という機能を持ち、ダイナミックレンジの広い写真を撮影する。画像処理では大量の演算が発生するが、これらをPixel Visual Coreで高速実行する。

(下の写真、教会の中で薄暗い祭壇をHDR+で撮影すると、照明が当たっているように鮮明に描き出される。今まではHDR+処理に時間がかかり多くの電力を消費したが、Pixel Visual Coreでこの処理を瞬時に実行する。)

出典: VentureClef

画像処理と機械学習実行

Pixel Visual CoreはGoogleが設計したプロセッサでPixel 2のアクセラレータとして位置づけられる。Pixel 2のメインプロセッサはSnapdragon 835で、画像処理と機械学習実行がPixel Visual Coreにオフロードされる。開発環境としては、画像処理で「Halide」が、機械学習では「TensorFlow Lite」をサポートする。Pixel Visual CoreはAndroid 8.1 Oreoから使うことができる。つまり、Pixel 2にはPixel Visual Coreが搭載されているが、Android 8.1が公開された今月からこのプロセッサを使えるようになった。これに併せて、AR Stickersでスターウォーズのセットが提供された。

Neural Networks API

GoogleはAndroid 8.1で機械学習向けAPI「Neural Networks API」を公開した。エンジニアはこのAPIを使い機械学習機能をアプリに組み込むことができる (下のダイアグラム、Androidスマホやデバイス向けAI開発環境)。Neural Networks APIはPixel Visual Coreの他にGPUなどのプロセッサにも対応している。TensorFlow Liteは軽量のAI開発環境で、教育済みのAIアプリをスマホで実行 (Inference処理) するために使われる。パートナー企業もAndroid向けにAIアプリ開発ができ、スマホ上でリアルタイムに稼働するAIの登場が期待される。

出典: Google

少し危険な香りのするアプリ

GoogleはスターウォーズをモチーフにしたAR Stickersをテレビ放送でPRしており、全米で話題となっている。AR Stickersのインパクトは大きく、これ程リアルな仮想オブジェクトをスマホで生成できるとは驚きである。今まではプロの世界に限られていた特撮をPixel 2でできるようになった。ワクワクするアプリであるとともに、現実と虚構の世界の垣根がなくなり、少し危険な香りのするアプリでもある。
IBM Watsonがロボットと結びつく、情緒的な会話ができるAIへの挑戦

AIスピーカーの進化は目覚ましく、Amazon Echoはほぼ完全にこちらの言葉を理解し、会話が成立する。これだけで十分であるが、いつも同じ調子で応答するEchoは機械的であるとも感じる。次のステップは利用者の感情を理解して、それに応じた対応をする会話技術の開発となる。ベンチャー企業で情緒的な会話ができるAIの開発が進んでいる。

出典: Soul Machines

AIで人間を表現する

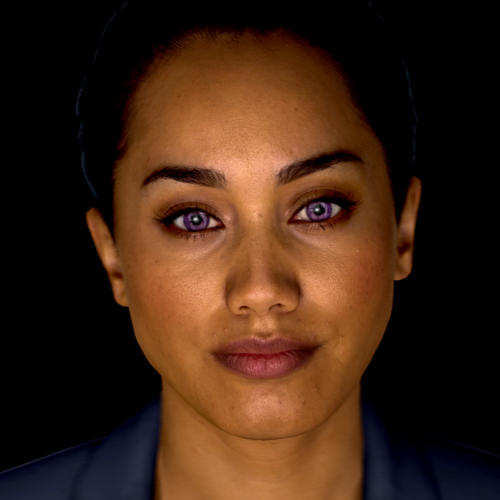
この研究を進めているのはニュージーランドに拠点を置くベンチャー企業Soul Machinesで、AIで人間を表現する「Human Computing」を目指している。人間のようにパーソナリティを持ち、固有の性格を備えた「Digital Humans」を開発している (上の写真)。言葉による会話に加え、感情を表現してコミュニケーションするAIを目指している。会話するAIはIBM WatsonのConversation機能を使い、Soul Machinesは感情表現の部分を開発している。

相手の感情を読み取り自分の感情を表現

Digital Humansは人間と同じように、知性と感性でコミュニケーションする。相手の言葉を理解し、同時に、相手の感情を読み取ることができる。発せられた言葉に込められたメッセージをリアルタイムに把握し、インタラクティブに反応する。更に、Digital Humansは多彩な感情を表現することができる。つまり、Digital Humansは相手の感情を読み取り、それに応じて自身の感情を表しコミュニケーションするAIとなる。

3D Facesで感情表現

Digital Humansの顔は「3D Faces」と呼ばれる。3D Facesは文字通り三次元の顔で、人間の顔を精細に再現する。 顔の表情は筋肉をベースにして生成され、目は見たものに対して反応して動く。Digital Humansは身体全体を表現するもので、3D Facesはその顔の部分となる。但し、Digital Humansはロボットではなくソフトウェアとして生成される。通常のディスプレイに表示されるほかARやVRで使われる。次のステップでヒューマノイドとして開発することが計画されている。

パーソナリティを持つ

Digital Humansは企業の仮想アシスタントとして利用され、固有のパーソナリティを持っている。パーソナリティは業務内容によって設定される。例えば、Digital Humansがコールセンターのエージェントとなる場合、その会社を代表するにふさわしいパーソナリティを持つ。具体的には、顧客への応対方法が設定され、感情表現や挙動振る舞いまでも規定される。

出典: Soul Machines

人間の脳を模して感情を持つ

Digital HumansはNeural Network Modelsに基づき、センサーで収集した情報を解析し挙動を決定する。Neural Network Modelsとは人間の脳をモデルにしたもので、Digital Humansは人間の反応や感情を模倣する。脳のニューロンを構成し、神経伝達物質 (Neurotransmitter) とホルモン (Dopamineなど) が主要機能を制御する。これらの挙動がDigital Humansの生理学的機能 (フィーリングや動き) を決める。

表情を学習する

相手の表情と言葉はカメラとマイクで読み込む。入力された音声は自然言語解析 (Natural Language Processing) で解析され、意味を理解しそれに返答する。言葉を喋るときは、顔の表情が変化し唇が動く。これらの動きは上述のNeural Network Modelsで表現する。このネットワークのアルゴリズムを教育して人間の表情に近づける。唇の動きでLip Reading(読唇術)できる精度を持つ。

コールセンターの仮想エージェント

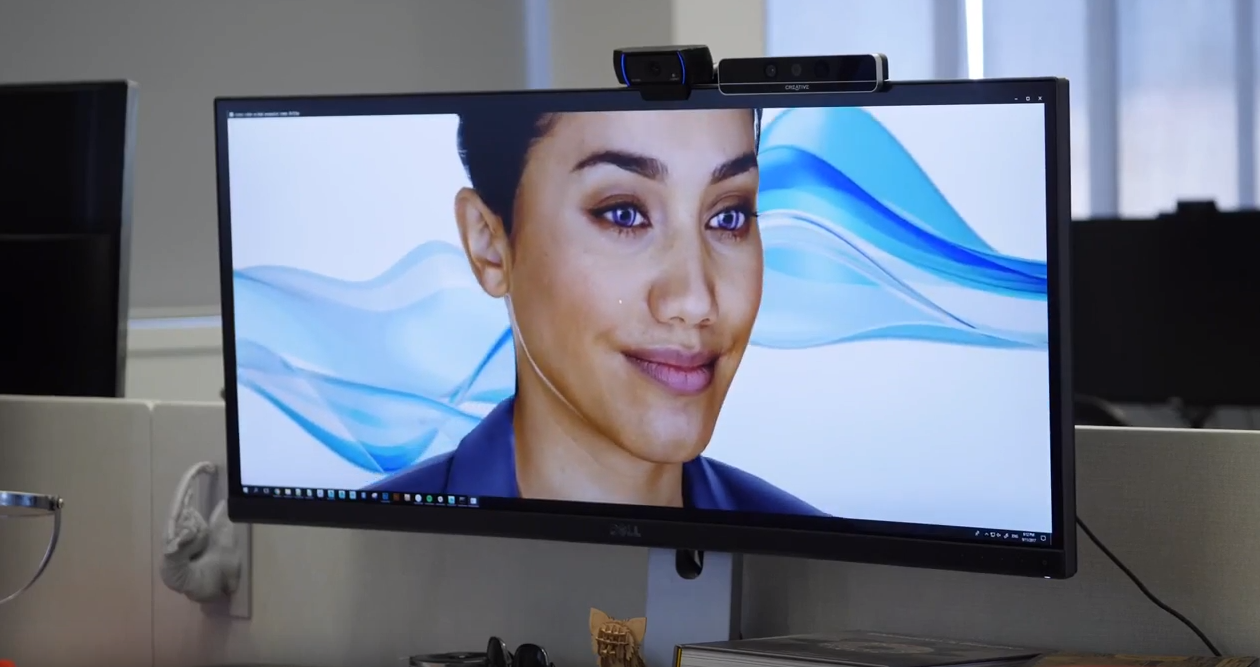
Soul Machinesは2017年11月、ソフトウエア企業Autodeskと共同でAva (Autodesk’s Virtual Agent) を開発した (上の写真)。Avaはコールセンターの仮想エージェントで、顧客の質問に答え、必要な情報を提供する。AvaはDigital Humansの基本機能を実装したもので、パーソナリティを持ち、感情を表現することができる。また、相手の言葉を理解するだけでなく、顔の表情やボディーランゲージを把握できる。人間のエージェントのようにAvaは理性と感性でコミュニケーションする。

なぜ感情表現が必要か

Digital Humanは本物とそっくりで、人間かソフトウェアか見分けがつかない。対話においても感情豊かにコミュニケーションする。対話では相手の顔が見えることで、信頼感が格段に向上する。そもそも、人間は顔を見ながら会話することを好む。人間のエージェントに代わりAvaが顧客と応対しても、顧客との信頼関係を築くことができると期待される。顧客は音声だけのチャットボットではなく、表情と感情を持った仮想エージェントと会話することで親近感が醸し出され絆が強くなる。

ロードマップ

Soul Machinesは相手の表情を読み取り、会話時の感情を生成するAI技法を開発している。今はディスプレイやAR・VRで顔を3Dで表現するが、将来は物理的な顔や人体を生成するとしている。表情豊かなヒューマノイドの開発が次のステップとなる。

3D映画として大ヒットしたAvatarは、James Cameron監督のSFファンタジー映画で、三次元空間でストーリーが展開される。映画の画像の6割はコンピューターグラフィックスで、これをニュージーランドの企業が開発した。Soul Machinesもここに拠点を置き、ニュージーランドは伝統的にコンピューターグラフィックスで高い技術を持っている。

AIのグランドチャレンジ、人間のように会話するチャットボットの開発

Amazonは会話するAIの開発コンペティション「Alexa Prize」を開催した。目標は20分間会話できるチャットボットを開発することで、22か国から100を超える大学チームが技術を競った。初年度の2017年は、米国のUniversity of Washingtonが優勝した。

出典: Amazon  

コンペティションの目的

AmazonがAlexa Prizeを始めた理由は、AIスピーカー「Echo」が目指している会話するAIを開発するためだ。AIの中で会話技法は極めて難しく、永遠に目標に到達できないという意見もある。AmazonはAlexaでこの技術を探求しているが、大学に参加を呼びかけ、若い頭脳によるブレークスルーを期待している。

Socialbotを開発

Amazonは会話するAIを「Socialbot」と呼んでいる。Socialbotとはチャットボットとも呼ばれ、AlexaのSkill (アプリに相当) に区分される。SocialbotはEchoを介し、幅広い話題で利用者と音声で会話する。話題としては、芸能、スポーツ、政治、ファッション、テクノロジーが対象で、人間とスムーズに対話が進むことがゴールとなる。

判定基準

参加大学はAmazonが提供するボイスアプリ開発環境 (Alexa Skills Kit) を使ってSocialbotを開発する。審査員がSocialbotと20分間会話し、会話能力を採点する。具体的には、Socialbotが話題に一貫性を持ち(Coherently)、相手を惹きつける(Engaging)能力などが評価される。但し、これはTuring Test (AIが人間のふりをする能力の試験) ではなく、あくまで会話能力が試される。

Socialbotと会話してみると

上位3チームのSocialbotは公開されており、Amazon Echoから会話することができる。実際に、Socialbotと話してみたが、技術は未完で会話はたどたどしい。しかし、Socialbotが話す話題は興味深く、話術も感じられ、会話に惹きつけられた。人間レベルに到達するにはまだまだ時間がかかるが、大きな可能性を秘めていることを実感した。

会話シーンのサマリー

優勝校のSocialbotとの会話は次のように進行した。Amazon EchoでSocialbotを起動すると、Socialbotは冒頭で挨拶 (「調子はどうですか?」) をしてから会話に入った。この技法は「Icebreaker」と呼ばれ、いきなり会話に入るのではなく、堅苦しさをほぐしてくれた。

興味ある話題を提示

ほぐれたところで、Socialbotは会話の話題を提示した。「休暇や人工知能や・・・の話をしましょうか?」。これは「Topic Suggestion」と呼ばれる技法で、相手の興味をそそる話題を提示する。Socialbotとは初対面なので、一般に受け入れられる話題が示された。

出典: Amazon  

最新の面白い話題を紹介

この問いかけに「人工知能」と返答すると、Socialbotはとっておきの面白い話を聞かせてくれた。「Facebookは利用者が投稿する写真からその人の感情を推測するAIを開発している・・・」。これは「Knowledge Ingestion」という技法で、Socialbotは最新の話題を常に取り入れ、会話でうんちくを披露し相手を惹きつける。人間の会話と同じように、フレッシュな話題が相手を惹きつける。

意地悪な質問

これに対して少し意地悪な質問をした。「どういう仕組みなの?」と尋ねると、Socialbotはこちらの質問を復唱した。Socialbotが、こちらの質問を正しく理解していることが分かり、少し気持ちよく感じた。

掘り下げて説明

しかしSocialbotはこの質問には回答できなかった。「I ask myself the same question」と返答した。相手が興味を持っていることを掘り下げて説明することを「Deep Dive」という。Deep Diveすることで話が深くなり対話が進む。ただし、このシーンではうまくいかなかった。

対話をリードする

Socialbotはこれにもめげず、「人工知能の話を続けますか」と質問してきた。これは「Leading Conversation」と呼ばれる手法で、会話のトピックスを示し、対話をリードする。会話がとん挫しそうになったが、これに対し「Yes」と回答し、人工知能の話題がさらに続いた。

出典: Amazon

話題が展開する

その後、Socialbotは「クラウドの友人が興味深いアドバイスをしてくれたが、聞きたい?」と興味をそそる。「Yes」と答えるとその話を始めた。「過酸化水素が入ったホワイトニングを使って歯磨きしたあとは、数分間そのままでいると効果があるよ」と生活のコツを紹介してくれた。「この話より人工知能に興味ある」と言ったが、この発言は無視され、Socialbotはホンジュラスの大統領選挙の話を始めた。

全体の感想

こちらの発言を無視されると、Socialbotであると分かっているが、あまり快く感じない。また、会話の話題が急に変わると、どうしたのかと不安を覚える。まだSocialbotが人間のように会話できるとは言い難いが、会話の内容は興味深く、対話時間は13分に及んだ。20分がゴールであるので、まだ研究開発は続く。

システム構成

SocialbotはAmazonのボイスアプリ開発環境で開発された。学生チームは、Amazonが提供している音声認識 (Automatic Speech Recognition、声をテキストに変換) とスピーチ合成 (Text-to-Speech、テキストを声に変換) を使うことができる。こちらが喋った言葉をシステムが認識し、Socialbotの発言は聞きなれたAlexaの声となる。

会話技術の開発

チームはその中間の会話技術を開発し、その技量が試験される。スムーズに会話するのは勿論であるが、Socialbotの話術やキャラクターなども開発目標となる。Socialbotが興味深い話題を話すだけでなく、自分の主張を持ち意見を述べることも視野に入る。更に、相手の言葉に対してジョークで返答すると完成度がぐんと上がる。

来年に向けて

Amazon EchoやGoogle Homeの爆発的な普及で会話するAIがホットな研究テーマになっている。企業で開発が進むが、大学の研究にも期待がかかっている。自動運転車は大学間のコンペティションで開発が一気に進んだ。Alexa Prizeは2018年度も計画されており、会話するAIはどこまで人間に近づけるか、グランドチャレンジが続く。

Amazonはビジネス向け音声サービスを投入、AIスピーカーが秘書となり会社の事務作業をこなす

大ヒット商品Amazon Echoが会社に入ってきた。Amazon Echoを会議室に置き、部屋の予約やテレビ会議への接続を言葉で指示できる。コピー室に置いておくと、用紙が切れた時には、Amazon Echoに発注を指示できる。AIスピーカーを会社で使うと事務作業が格段に便利になる。

出典: Amazon  

ビジネス向けのAlexa

このサービスは「Alexa for Business」と呼ばれ、Amazon開発者会議「AWS re:Invent 2017」で発表された。音声アシスタント機能をビジネスに適用するもので、家庭向けに提供されているAlexaを企業向けに拡大した構成となる。会社では煩雑な事務作業が多いが、Alexaがインテリジェントな秘書となり、言葉で指示したことを実行してくれる。

Alexa for Businessは個人モデル (Enrolled User) と共有モデル (Shared Device) がある。前者は社員がデスクに置いて個人で利用する形態で、後者は公共の場所 (会議室など) に置いてみんなで使う形態である。

デスクに置いて利用する

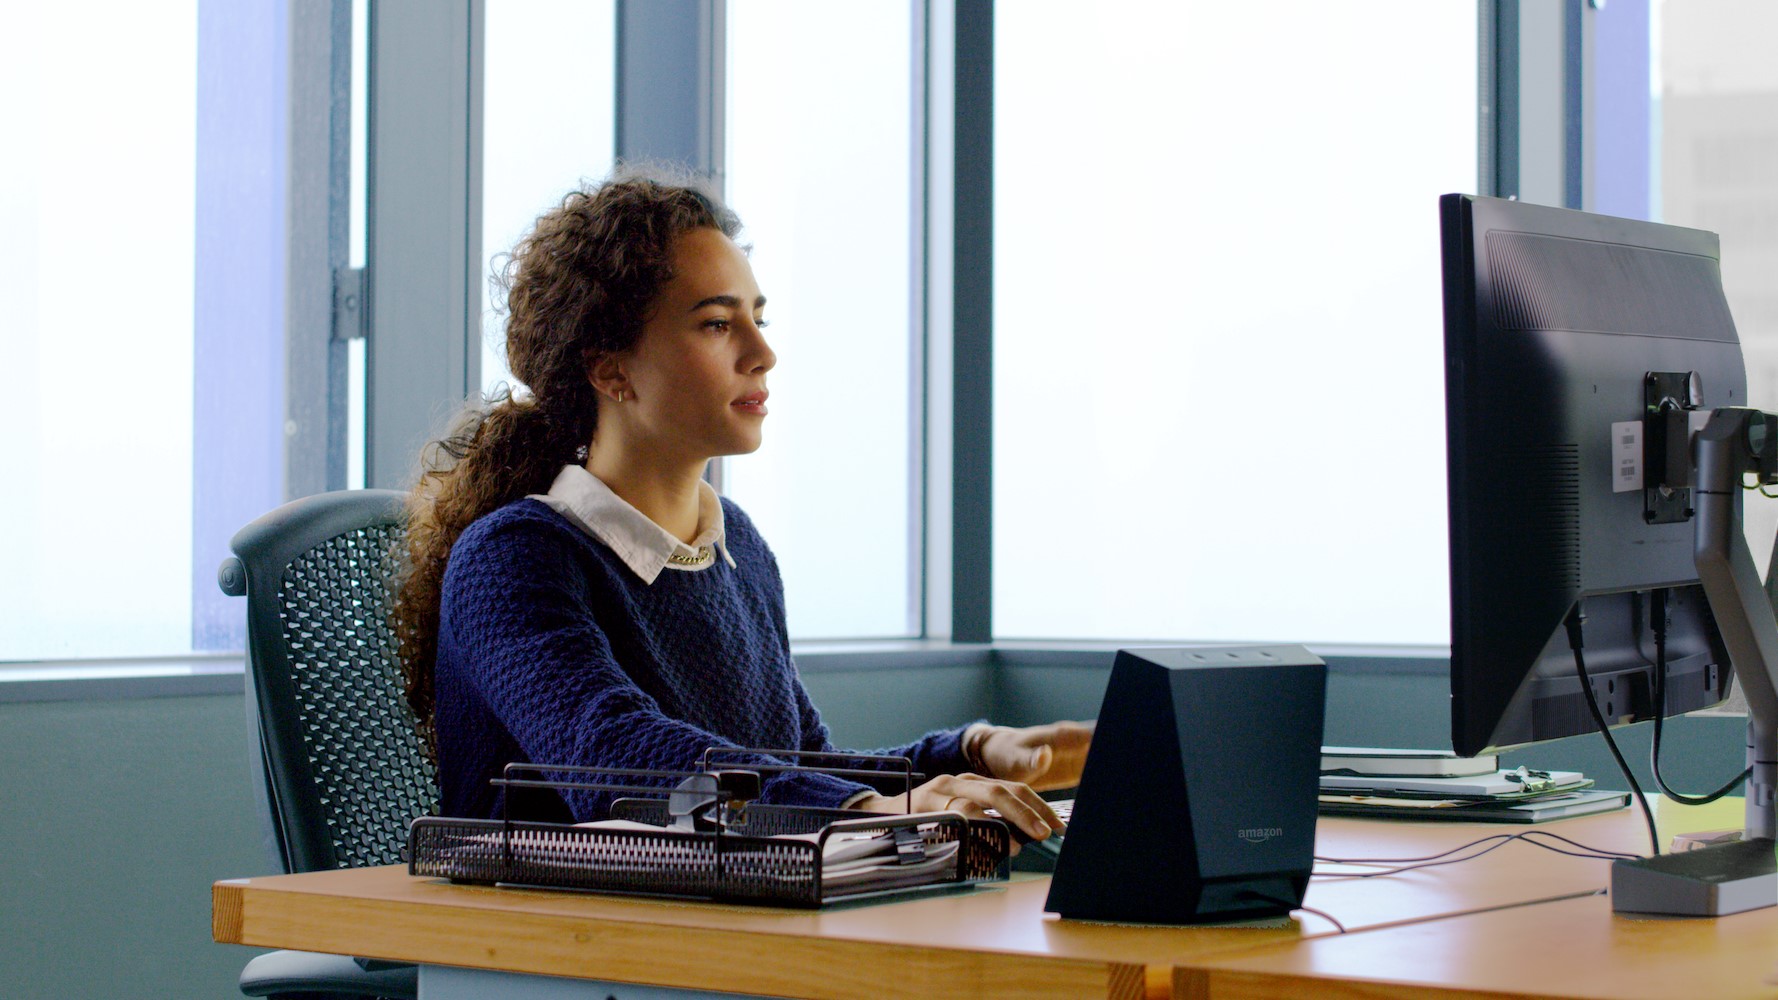
Alexaをデスクに置いて、スケジュール管理などで利用する (上の写真)。「Alexa, what’s my first meeting today?」と尋ねると、Alexaは次の打ち合わせ予定を回答する。また、Alexaに指示して、打ち合わせを設定することもできる。「Alexa, schedule a meeting with sales team at 2 pm on Thursday?」と言えば、販売チームとの打ち合わせをセットしてくれる。

会議室で利用する

会議室ではAlexaがミーティングのアシスタントとして活躍する (下の写真)。テレビ会議を始めるときに、「Alexa, start a sales meeting」と指示すると、Alexaが指定の番号に電話を発信し、モニターに参加者が映し出される。プレゼン中に資料が必要になると、「Alexa, pull up the last month sales」と指示すると、Alexaがディスプレイに先月の売り上げ情報を表示する。

出典: Amazon  

コピー室に設置しておくと

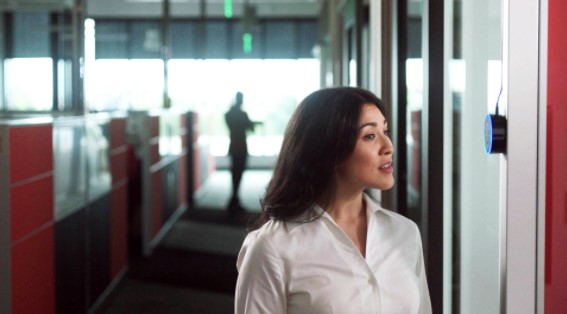
Alexaをオフィスの様々な場所に設置しておくと意外な使い方ができる。オフィス入り口に設置しておくと、Alexaが受付の役割をこなす。「Where is the Tyler’s office?」と尋ねると、オフィスの場所を教えてくれる (下の写真)。

出典: Amazon  

コピー室に設置しておけば、用紙が切れた時に、Alexaに指示すれば発注してくれる。「Alexa, ask the office for more printer paper.」。 Alexaはプリンター用紙を発注するだけでなく、印刷中のタスクについて、「Should I send your job to Printer 3?」と質問し、別のプリンターで印刷するよう取り計らってくれる。

Alexaで会議室を予約する

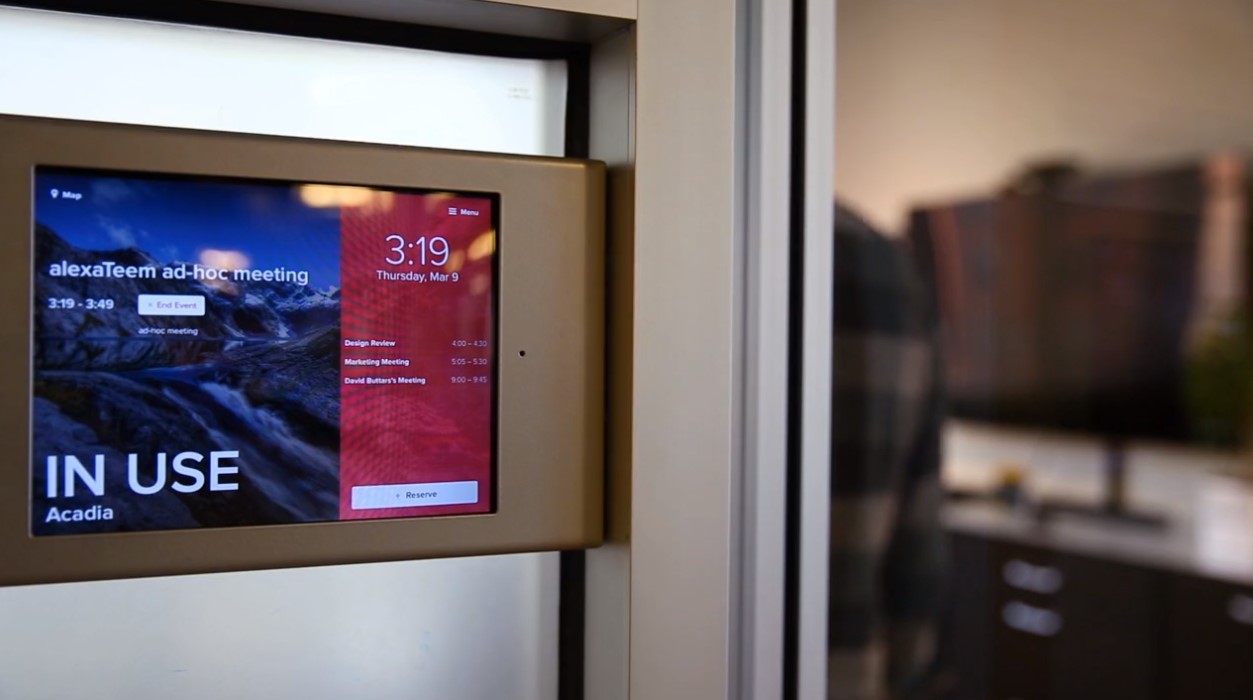
Alexaのビジネスソリューションはパートナー企業により提供される。Teemという新興企業はAlexaと連動し、会議室を管理するスキルを提供する。会議室入り口にディスプレイを設置し、部屋の使用状況を表示する (下の写真)。多くの企業がTeemで会議室を管理しており、Alexaとの統合で、これを言葉で指示できるようになった。

会議室を予約するときは、部屋に設置してあるAlexaに、「Alexa, ask Teem to book this room」と指示する。また、ディスプレイの「Reserve」ボタンにタッチして予約することもできる。会議室を使い始めるときは、「Alexa, ask Teem to check in this room.」と言い、時間を延長する時は、「Alexa, ask Teem to extend this meeting by 15 minutes.」と指示すると、15分間延長できる。

出典: Teem  

ERPとの連携

Acumaticaという新興企業は、Alexaを使って在庫管理システムを音声で提供している。Alexaに言葉で在庫状態を尋ねることができる。「Alexa, ask Acumatica how many laptops do we have in stock?」と質問すると、Alexaはラップトップの在庫量を答えてくれる。在庫がない場合は、Alexaに商品発注を指示できる。「Alexa, ask Acumatica order 10 please.」というと、その商品を10点発注する。

AlexaはAcumaticaのERPシステムに統合され、在庫に関するデータを参照する仕組みとなる。更に、AlexaはERPシステムに商品の発注をリクエストすることができる。ただ、ERPという基幹システムにアクセスするため、Alexaの認証機能を強化することが課題となる。Alexaの認証方式は、4ケタのPINを言葉で語るのが一般的で、PINを聞かれる危険性がある。声紋などバイオメトリックな認証が次のステップとなる。

ホテル客室に導入

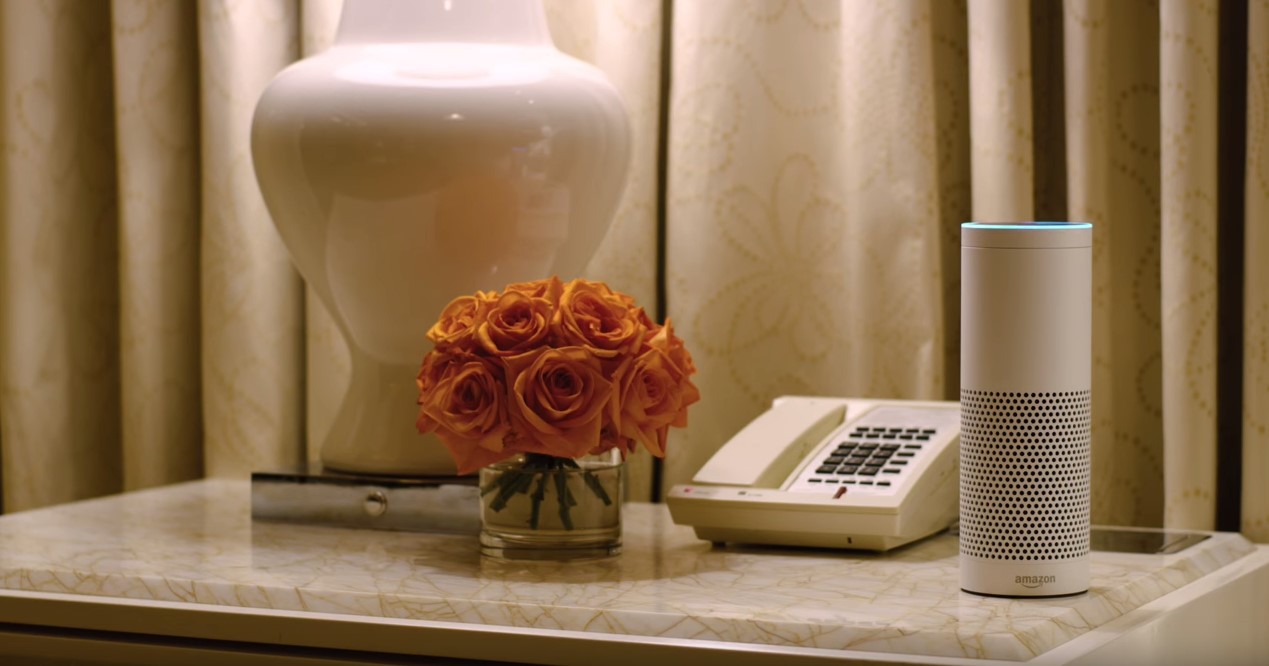
Alexa for Businessに先立ち、Amazon Echoはホテル客室で使われている。Wynn Las Vegasはラスベガスの高級リゾートホテルで、全ての客室にAmazon Echoを導入すると発表。4,748台のAmazon Echoが設置され、宿泊客はホテルや客室情報をEchoに尋ねることができる (下の写真)。

また、宿泊客は音声で部屋の設備をコントロールできる。「Alexa, I am here」と言えば、部屋の電灯が灯り、「Alexa, open the curtains」と言えばカーテンが開く。「Alexa, turn on the news」と言えばテレビがオンとなり、ニュース番組が放送される。Alexaがコンシェルジュとなり、宿泊客をサポートする。ホテル側としては、宿泊客がフロントに電話する回数が減り、コスト削減にもつながるという読みもある。

出典: Wynn Las Vegas

有償のサービス

家庭向けのAlexaは無償で使えるが、企業向けのAlexa for Businessは有償のサービスとなる。サービス料は共有モデルではデバイスごとに月額7ドルで、個人モデルでは利用者あたり月額3ドルとなる。また、企業のIT部門がデバイスや利用者を管理する体制となる。

共有モデルがヒットする

Alexaをデスクに置いて利用する個人モデルでは、会話が周囲に聞こえ迷惑になるだけでなく、内容によるとセキュリティのリスクもある。一方、共有モデルはこの問題は無く、また、役に立つクールなスキルが数多く登場している。家庭でヒットしているAmazon Echoは共有モデルがベースで、会社の中でもこのモデルの普及が予想される。

Generative Adversarial Networks (GAN) とは何か、どんなブレークスルーが期待でき如何なる危険性があるか

Generative Adversarial Networks (GAN) とはGoogle Brain (AI研究部門) のIan Goodfellowが開発したニューラルネットワークで、その潜在能力に期待が高まり研究開発が進んでいる。GANは様々なバリエーションがあり多彩な機能を持っている。GANはDeep Learningが抱える問題を解決する糸口になると見られている。同時に、GANは大きな危険性を内在し注意を要する技法でもある。

出典: Karras et al. (2017)

DCGAN:現実そっくりのイメージをリアルに生成

GANはニューラルネットワークの技法で二つの対峙する (Adversarial) ネットワークがコンテンツ (イメージや音声など) を生成する。GANは技法の総称で多くのバリエーションがある。その代表がDCGAN (Deep Convolutional Generative Adversarial Networks) で、ネットワークが写真そっくりの偽のイメージを生成する。Nvidiaはニューラルネットワークでセレブ画像を生成する技術を公開した。画像は実在の人物ではなくアルゴリズムがセレブというコンセプトを理解して想像でリアルに描く。このネットワークがDCGANにあたる。

DCGANはセレブ以外に様々なオブジェクトを描くことができる。上の写真はDCGANが寝室を描いたものである。これらのイメージは写真ではなく、教育されたデータをもとにDCGANが寝室のあるべき姿を出力したものである。寝室にはベッドがあり、窓があり、テーブルがあり、ランプがあることを把握している。リアルな寝室であるがこれはDCGANが想像したもので、このような寝室は実在しない。DCGANは写真撮影したように架空のセレブやオブジェクトをリアルに描き出す。

DCGANのネットワーク構造

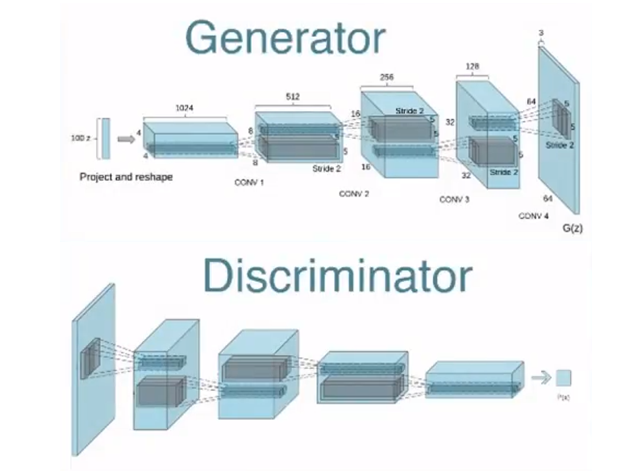
DCGANはGenerator (制作者) とDiscriminator (判定者) から構成される (下の写真)。GeneratorはDe-convolution Network (上段、パラメータから元のイメージを探す処理) で構成され、入力されたノイズ (ランダムなシグナル) からイメージ (例えば寝室) を生成する。

DiscriminatorはConvolution Network (下段、イメージをパラメータに凝縮する処理) で構成され、ここに偽造イメージ (Fake) 又は本物イメージ (Real) を入力する。Discriminatorは入力されたイメージを処理し、それがFakeかRealかを判定 (Logistic Regression) する。このプロセスでDiscriminatorが誤差逆伝播法 (Backpropagation) で教育され勾配 (Gradient、本物と偽物の差異) を得る。

この勾配をGeneratorに入力し本物そっくりの偽物を生成する技術を上げる。両者が揃って成長する仕組みで、このプロセスを何回も繰り返しDiscriminatorが見分けがつかないリアルなフェイクイメージ (先頭の写真) を生成する。

出典: Amazon  

DCGANでイメージを演算する

Generatorはフェイクイメージを生成するだけでなく、生成したイメージを演算操作する機能を持っている。例えば、「眼鏡をかけた男性」ー「眼鏡をかけていない男性」+「眼鏡をかけていない女性」=「眼鏡をかけた女性」となる (下の写真)。演算の結果「眼鏡をかけた女性」が九つ生成される (右端) がその中央が求める解となる。その周囲八つのイメージから外挿 (Extrapolation) して中央のイメージが生成された。この技法を使うとイメージを操作して金髪の女性を黒髪の女性に変えることができる。

出典: Radford et al. (2016)

SRGAN:イメージ解像度をアップ

SRGAN (Super-Resolution Generative Adversarial Networks) とは低解像度のイメージを高解像度のイメージに変換する技法 (下の写真) である。右端がオリジナルイメージで、この解像度を様々な手法で上げる (このケースでは解像度を4倍にする)。多くの技法が使われており、bicubic (左端、二次元のExtrapolation) やSRResNet (左から二番目、Mean Squared Errorで最適化したDeep Residual Network) などがある。左から三番目がSRGANが生成したイメージ。物理的にはノイズ比 (peak signal-to-noise ratio) が高いが (ノイズが乗っているが) 見た目 (Structural SIMilarity) にはオリジナルに一番近い。この技法はImage Super-Resolution (SR) と呼ばれ、低解像度イメージを高解像度ディスプレイ (8Kモニターなど) に表示する技術として注目されている。

出典: Ledig et al. (2016)

StackGAN:テキストをイメージに変換

StackGAN (Stacked Generative Adversarial Networks) とは入力された言葉からイメージを生成する技法 (下の写真) を指す。例えば、「この鳥は青色に白色が混ざり短いくちばしを持つ」というテキストを入力すると、StackGANはこのイメージを生成する (下の写真、左側)。StackGANは二段階構成のネットワークで、Stage-Iは低解像度のイメージ (上段) を、Stage-IIで高解像度のイメージ (下段) を生成する。DCGANと同様に生成されたイメージは実在の鳥ではなくStackGANが想像で生成したもの。リアルそっくりのフェイクの鳥でこのような鳥は世の中に存在しない。言葉で意のままにフェイクイメージを生成できる技術で、応用範囲は広いものの不気味さを感じる技術でもある。

出典: Zhang et al. (2016)

3D-GAN:写真から三次元モデルを生成

MITのAI研究チームは三次元モデルを生成するネットワーク3D-GAN (3D Generative Adversarial Networks) を公開した。例えば、家具の写真で教育すると3D-GANは家具を三次元で描くことができるようになる。ここではIkeaの家具の写真が使われ、それを3D-GANに入力するとその家具を3Dで描写する (下の写真、上段)。入力された写真は不完全なもので家具の全体像が見えていないが、3D-GANはこれを想像で補って3Dイメージを生成する。

3D-GANは3Dモデルイメージを演算操作できる (下の写真、下段)。例えば、「棚付きの低いテーブル」ー「棚無しの高いテーブル」+「高いテーブル」=「棚付きの高いテーブル」となる (一番下の事例)。これは3D-GANが学習した成果を可視化するために出力されたもの。GANは学習した成果をパラメータとしてネットワークに格納するが、これを直接見ることはできない。この研究の目的は隠れた領域 (Latent Spaceと呼ばれる) のパラメータを出力し3D-GANが学習するメカニズムを検証することにある。

出典: Wu et al. (2017)

CycleGAN:イメージのスタイルを変換

入力イメージのスタイルを別のスタイルに変換する手法は一般にStyle Transferと呼ばれる。イメージ間のスタイルをマッピングすることが目的でDeep Neural Networkが使われる。ネットワークが画家のスタイルを習得し、そのタッチで絵を描く技術が発表されている。例えば、写真入力するとネットワークはそれをモネ・スタイルの油絵に変換する。しかし、画家の作品とその風景写真を対にしたデータは殆どなく、ネットワーク教育 (Paired Trainingと呼ばれる) が大きな課題となっている。

出典: Zhang et al. (2016)

これに対しCycleGAN (Cycle-Consistent Adversarial Networks) という方式では対になった教育データ (モネの油絵とその元になった風景写真など) は不要で、それぞれのデータを単独 (モネの油絵と任意の風景写真など) で使いネットワークを教育 (Unpaired Trainingと呼ばれる) できる。教育されたCycleGANは、例えば、モネの作品を入力するとそれを写真に変換する (上の写真、左側上段)。反対に、写真を入力するとモネの油絵に変換する (上の写真、左側下段)。また、シマウマの写真を馬の写真に、馬の写真をシマウマの写真に変換する (上の写真右側、object transfigurationと呼ばれる)。更に、富士山の夏の写真を入力すると、雪の積もった冬の富士山の写真に変換できる (season transferと呼ばれる)。CycleGANはネットワークが自律的に学習するアーキテクチャで教師無し学習 (Unsupervised Learning) につながる技法として期待されている。

DiscoGAN:イメージグループの属性を把握

人間は一つのグループ (例えばバッグ) と別のグループ (例えばシューズ) の関係を把握できる。ニューラルネットワークがこの関係を把握するためにはタグ付きのイメージを大量に入力してアルゴリズムを教育する必要がある。DiscoGANという技法はアルゴリズムが両者の関係を自律的に理解する。最初、DiscoGANに二つのグループのイメージ (例えばバッグとシューズ) をそれぞれ入力しそれぞれの属性を教える。イメージにはタグ (バッグとかシューズなどの名前) はついてないがアルゴリズムが両者の関係を把握する。

出典: Kim et al. (2017)

教育したDiscoGANに、例えば、バッグのイメージを入力するとシューズのイメージを生成する (上の写真)。青色のバッグからは青色のシューズを生成する (左端の事例)。これ以外に、男性の写真を入力すると女性のイメージを生成することもできる。DiscoGANも両者の関係 (バッグとシューズの関係など) を自律的に学習する。両者の関係を定義したデータ (Paired Data) は不要で、それぞれの属性のイメージ (バッグやシューズの写真集など) だけで教育できる。DiscoGANもネットワークが自律的に学習する構造で教師無し学習への道が開ける技法として注目されている。

GANがファッションデザイナー

GANは基礎研究だけでなくビジネスへの応用も始まっている。AmazonはGANを利用したファッション事業の構想を明らかにした。Amazonは自社の研究所Lab126でGANの開発を進めている。GANは流行りのファッションからそのスタイルを学習し、独自のファッションを生成する。GANがファッションデザイナーとなり、人間に代わって新しいデザインをを創り出す。

ファッショントレンドはFacebookやInstagramなどに投稿されている写真から学習する。これらの写真をGANに入力すると、GANがトレンドを学び独自の洋服などをデザインする。また、AmazonはEcho Look (下の写真、カメラ付き小型版Echo) で利用者を撮影しファッションのアドバイスをするサービスを展開している。Echo Lookを通して利用者のファッションの好みを理解し、GANはその個人に特化したデザインを生成することが計画されている。GANが生成したデザインはオンデマンドで洋服に縫製され (On-Demand Clothing) 利用者に配送される仕組みとなる。

出典: Amazon

GANに注目が集まっている理由

このようにGANのバリエーションは数多く研究が幅広く進んでいる。GANに注目が集まっている理由はGANが現行Deep Learningが抱えている問題の多くを解決する切り札になる可能性があると期待されているからだ。特に、教師無し学習 (Unsupervised Learning) とタグ無しデータ (Unlabeled Data) 教育の分野で研究が大きく進む手掛かりになると見られている。上述のCycleGANやDiscoGANがこれらのヒントを示している。また、Nvidiaの研究チームはDCGANという技法で、写真撮影したように鮮明な架空のセレブイメージを生成したが、教育にはタグの付いていないセレブの写真が使われた。アルゴリズムが自律的に学ぶ技術が進化している。

GANの危険性も考慮する必要あり

FacebookのAI研究所所長のYan LeCunは「GANとその派生技術はここ10年におけるMachine Learning研究で最も優れた成果」であると高く評価している。一方、GANに寄せる期待が高まる中でその危険性も指摘されている。今までもフェイク写真が問題となってきたがGANの登場でその危険性が加速される。ニュースに掲載されている写真やビデオを信用できるかという問いが投げかけられている。(GANでフェイクビデオを生成できるのは数年先と見られている。) ソーシャルメディアに掲載されたイメージが証拠写真として使われることが多いが、これからは何が真実か分からない時代となる。AIがそうであるようにGANも諸刃の剣で、先進技術は生活を豊かにするとともに、使い方を間違えるとその危険性も甚大である。