カテゴリー別アーカイブ: 人工知能

Googleは駐車場の込み具合をAIで予測する技術を開発、センサーは不要でアルゴリズムが正確に推定

駐車場管理はInternet of Thingsの得意分野で、設置したセンサーがクルマの有無を捉え混雑状況を把握する。Googleのアプローチはソフトウェアで、クルマの流れをMachine Learningで解析し混雑状況を正確に推定する。駐車場にセンサーを設置することなく、アルゴリズムのパワーで施設を管理する。
出典: VentureClef  

駐車場の混雑情報を表示

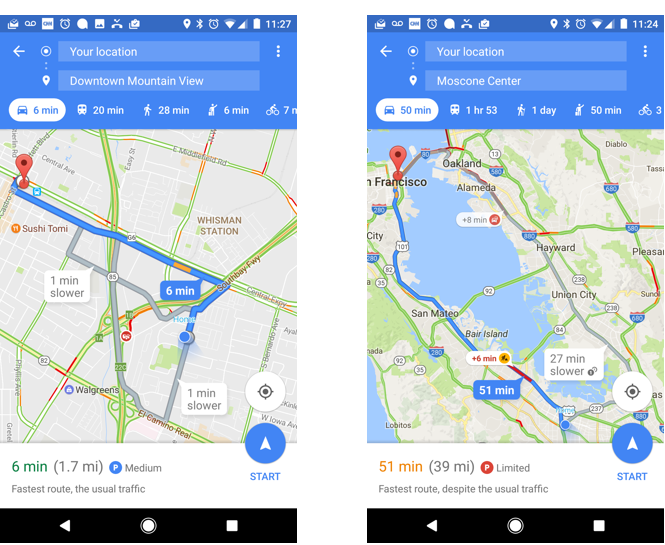
駐車場の混雑状態を表示するサービスが今月から始まった。Google Mapsで目的地までの道順を検索すると、駐車場の込み具合も表示される (上の写真、最下段の分部)。例えば、Mountain View市街に向かうとき、駐車場の込み具合は「Medium」となっている (上の写真左側)。これは「駐車場を探すのは難しくない」という意味で、時間通りに出発できる。込み具合に応じて出発時間を調整することができる。

駐車場が無ければ電車で移動

一方、サンフランシスコのカンファレンス会場への道順を検索すると、駐車場は「Limited」と表示される (上の写真右側)。これは「駐車場は限られている」という意味で、駐車場を探すために時間がかかると注意を促している。駐車が難しいのであれば電車で行くという選択肢も浮上する。事実、Googleによるとこのサービスを始めると、電車で移動するルートの検索件数が急増したとしている。

混雑状況を把握する仕組み

Googleは新サービスの仕組みを「Using Machine Learning to predict parking difficulty」として公表した。これによると、駐車場空きスペースを把握するために、クラウドソーシングとMachine Learningという技法を使っている。クラウドソーシングとはユーザデータを集約して利用することを示す。このケースではGoogle Mapsユーザの位置情報を集約して利用する。Google Mapsユーザに「駐車場を探すまでどのくらいかかりましたか?」という質問を送り、その回答を集約し、駐車場を探す難易度を算定した。Googleはこの手法で信頼度の高いGround Truth (基準データ) を収集した。

店舗やレストランの混雑状況

Googleは早くから利用を許諾したユーザの位置データを使ったサービスを展開している。その代表がGoogle Mapsで表示されるLive Traffic (渋滞情報) でクルマの流れをリアルタイムで表示する。また店舗やレストランのPopular Time (混雑情報) やVisit Duration (滞在時間) を提供している。便利なツールで生活の一部として利用されている。

クラウドソーシングの限界

しかしこの手法だけでは駐車場の込み具合を正確に推定することはできない。クルマを駐車する場合はパターンの数が多く、これらの要因も考慮する必要がある。例えば、クルマが私有地に駐車すると、アルゴリズムは空きスペースがあると誤認する。また、利用者がタクシーやバスで移動したケースも、アルゴリズムは駐車スペースがあると誤認する。駐車スペースを判定するためにはクラウドソーシングの手法では限界がある。
出典: VentureClef  

クルマの移動パターンと駐車場の有無

このためクルマがどんなパターンで移動すると駐車場が無いことを示すのか、その特徴量を見つけることがカギとなる。昼食時間にクルマが街中を周回する動きをすると (下の写真)、これは駐車場が無いためと判断する。一方、利用者が目的地に到着し、そのまま施設に入った場合は駐車場があったと判断する。このような特徴量を把握してアルゴリズムに反映した。

出典: Google    

20のモデルを生成

この他に目的地に特有な条件や駐車場の位置に依存した要因も考慮する必要がある。また、駐車する時間や、駐車する日に依存する条件なども取り入れる。更に、過去の統計情報も利用された。最終的には20のモデルが作られ、これを使ってアルゴリズムが教育された。

Logistic Regressionという手法

前述の通り、このモデルの解析ではMachine Learningが使われた。Machine Learningには様々な手法があるが、その中でもLogistic Regressionという技法が使われた。Logistic Regressionとは統計学の代表的な技法で、変数の間の関係を推定する。アルゴリズムを教育することで、ある変数を入力すると、その結果を推定することができる。つまり、Logistic Regressionはある事象に関する結果を予想する。ここではドライバーの運転データを入力すると、駐車場を探すのが容易であったか、困難であったかを推定する。アルゴリズムは容易か困難かの二つの値を出力し、これはBinary Logistic Modelと呼ばれる。

Deep LearningではなくMachine Learningを採用

Deep Learningで世界をリードするGoogleであるが、敢てMachine Learningの技法を使ったことは興味深い。具体的には、Neural Network (人間の脳を模したネットワーク) ではなくLogistic Regression (統計手法) が使われた。Googleはこの理由として、「Logistic Regressionは技術が確立しており、挙動を理解しやすいためと」述べている。このことは、Neural Networkは中身がブラックボックスでその挙動が分かりにくいということを示す。

今年のAI技法のトレンド

Googleや他の企業でMachine Learningを見直す動きが広がっている。Neural Network全盛時代であるが、長年にわたり培われた技法を改良しうまく利用しようとする試みである。同時に、Neural Networkのブラックボックスを開き、仕組みを解明しようという研究も始まった。AIの観点からは、Machine Learningの改良とNeural Networkの解明が今年の大きなテーマになっている。

サンフランシスコ市街の駐車場

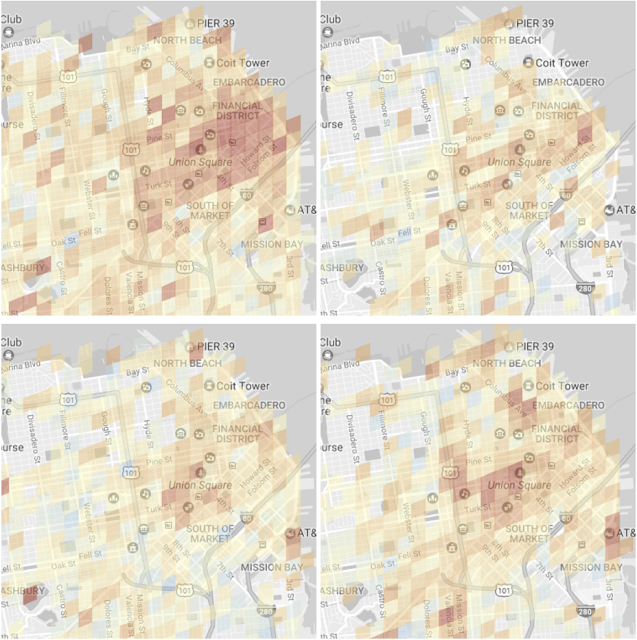
この技法でサンフランシスコ市街の駐車場の混雑を予測すると下の写真の通りとなる。市街地を区画ごとに分け駐車場の込み具合を表示している。色の濃い部分が混雑が激しいことを示す。上段は月曜日で下段は土曜日。左側は午前8時で右側は午後9時の標準的な込み具合を表示している。月曜日の朝はFinancial Districtを中心としたビジネス街の駐車場が混むが、土曜日の夜はUnion Squareを中心とした観光スポットの駐車場が込むことが分かる。
出典: Google    

サンフランシスコ市の取り組み

駐車場管理や混雑情報の発信は行政の責任でもある。事実、サンフランシスコ市は駐車場にIoTを導入し、混雑度を把握する実証実験「SF Park」を進めている。サンフランシスコ市街地では路上駐車スポットにParking Meterが設置され、コインやカードやアプリで駐車料金を支払う (下の写真)。同時に、Parking Meterがセンサーとなり、クルマの有無を検知する。Parking MeterはIoT専用ネットワークSigfoxで結ばれ、駐車スポットの込み具合を集約する。このIoTシステムが完成すると、駐車場混雑情報がリアルタイムで分かることになる。

出典: San Francisco Municipal Transportation Agency

センサー対アルゴリズム

果たしてサンフランシスコ市によるIoT駐車場管理システムは正しく混雑状態を把握できるのか関心が高まっている。Parking Meterで駐車を正しくセンシングできるかという問題である。Parking Meterのある駐車スポットに違法で駐車したり、また、特別許可証を持ったクルマが駐車した場合は空きと判断される恐れがある。また、駐車時間が残っているのにクルマを出す人もあり、このケースでは駐車中と判断される可能性が高い。

スマートシティー開発のモデルケース

リアルタイムで正確な駐車場空き情報を把握するのは難しい作業となる。これに対し、Googleはセンサーは使わないでアルゴリズムが混雑状況を把握する。センサーとアルゴリズムの戦いが始まり、どちらに軍配が上がるのか地元住民だけでなく全米で関心が高まっている。GoogleやSF Parkの取り組みが米国で展開されているスマートシティー開発のモデルケースとして注目されている。

音声操作できない製品はもう売れない!家電、ロボット、クルマが相次いでAmazon AIボイスクラウドを採用

AmazonのAIスピーカーEchoが爆発的に売れている。その理由はAIの適用で会話機能が格段に進化したためだ。自然な会話でEchoを快適に使うことができる。Amazonはこの会話機能をAIボイスクラウドとして一般に公開した。メーカーは相次いでAIボイスクラウドの採用を決めた。Amazonはサーバクラウドの次はAIボイスクラウドで市場を席捲しようとしている。

出典: Amazon

Amazon Echoとは

Amazonは2014年にAIスピーカー「Echo」を発売し、累計で510万台が出荷され、大ヒット商品となった。今では「Echo Tap」(携帯版Echo) と「Echo Dot」(小型版Echo、上の写真) が製品ラインに加わった。製品の背後ではAIボイス機能「Alexa」が稼働し会話を司る。デバイスに話しかけて音楽を再生しニュースを聞く。また、スマートホームのハブとして機能し、家電を言葉で操作できる。

コンセプトは宇宙大作戦

Amazon Alexaの開発は2012年に始まり、クラウド機能をすべて音声で操作するシステムを目指した。このアイディアはテレビ番組「Star Trek」(宇宙大作戦) にあり、宇宙船内の複雑な機器を言葉で操作できるシーンからヒントを得た。Alexaはデバイスに触ることなく言葉だけで情報にアクセスし、家電を操作できる構造となっている。言葉は人間の本質的なコミュニケーション手段で、Amazon開発チームはこれをAlexaに応用した。

Amazon Alexaはプラットフォーム

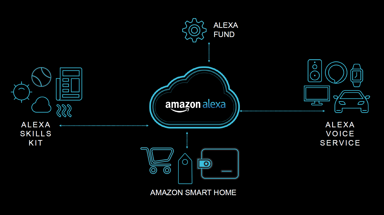
Amazon AlexaはEchoだけでなく一般に公開され、多くの企業にボイスサービスを提供している (下の写真)。つまり、Alexaはプラットフォームとして位置づけられ、ここにエコシステムが形成されている。パートナー企業はこの機能を使い音声で操作するボイスアプリを開発する (下の写真、Alexa Skills Kitの分部)。また、家電や自動車メーカーはそれぞれの製品にボイス機能を組み込むことができる (下の写真、Alexa Voice Serviceの分部)。更に、スマートホーム企業は音声で操作できる機器を開発する (下の写真、Amazon Smart Homeの分部)。

出典: Amazon

ボイスアプリの数が急増

ボイスアプリはAmazonだけでなくパートナー企業により開発されている。ボイスアプリはAmazon Echoで稼働し、出荷当初は10本程度であったが、今では5000本を超えた。人気のボイスアプリは「Amazing Word Master Game」で、Echoとゲームで対戦する。これはしりとりをするゲームで、単語の長さが得点となる。Echoを相手にゲームをする形式で、英語の勉強にもなる。一人で時間を持て余している時にEchoが遊び相手になってくれる。

Alexaでレンタカーを予約

ビジネスと連携したボイスアプリが増えてきた。旅行サイト「Expedia」はAlexaを使って言葉で予約できるサービスを開始した。航空機を予約している人は言葉でフライト内容を確認できる。「Alexa, ask Expedia to get my trip details」と指示すると、Echoは予約状況を読み上げる。「Alexa, ask Expedia to book a car」と指示すればレンタカーを予約できる。ただし、フライトとホテルの予約にはまだ対応していない。

LenovoはAmazon Echo対抗製品を発表

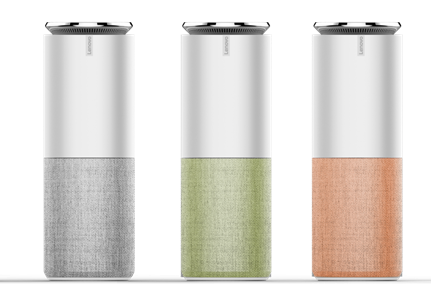
LenovoはAIスピーカー「Smart Assistant」 (下の写真) を発表した。Echoとよく似た形状で、ボイス機能としてAmazon Voice Serviceを使っている。形状だけでなく機能的にもEchoと類似の製品仕立てになっている。Smart AssistantがEchoと異なる点はプレミアムスピーカー「Harman Kardon」を搭載している点。価格は179.99ドルで2017年5月から出荷が始まる。この事例が示すように、Amazonは競合デバイスの開発を歓迎しており、事業の目的はAIボイスクラウドの拡大にある。

出典: Lenovo

Fordはクルマに会話機能を組み込む

Fordは自動車メーカーとして初めてAlexa Voice Serviceの採用を決めた。利用者は家庭のAmazon Echoからクルマを操作できる。「Alexa, ask MyFord Mobile to start my car」と指示するとエンジンがかかる。運転中はナビゲーションパネルから音声でAlexaを利用できる (下の写真)。目的地の検索やガレージドアの開閉などを言葉で指示できる。これはFord「SYNC 3」技術を使ったもので、ドライバーのスマホアプリからクルマにアクセスする構成となる。前者の機能は2017年1月から、後者の機能は夏から利用できる。クルマが自動運転車に向かう中、ドライバーとクルマのインターフェイスはボイスとなる。

出典: Ford

HuaweiはスマホにAlexaを組み込む

Huaweiは最新のスマートフォン「Mate 9」 (下の写真) にAlexaをプレインストールして出荷することを明らかにした。Mate 9はボイスアプリを搭載し、この背後でAlexa Voice Serviceが使われている。利用者は音声で備忘録を作成し、天気予報や渋滞情報を尋ねることができる。また、スマートホームのハブとして家電を操作することもできる。ボイスアプリは2017年初頭から提供される。GoogleはAndroid向けにAI会話機能「Assistant」を提供しており、Alexaと正面から競合することになる。

出典: Huawei  

UBTechはロボットのインターフェイスにAlexaを採用

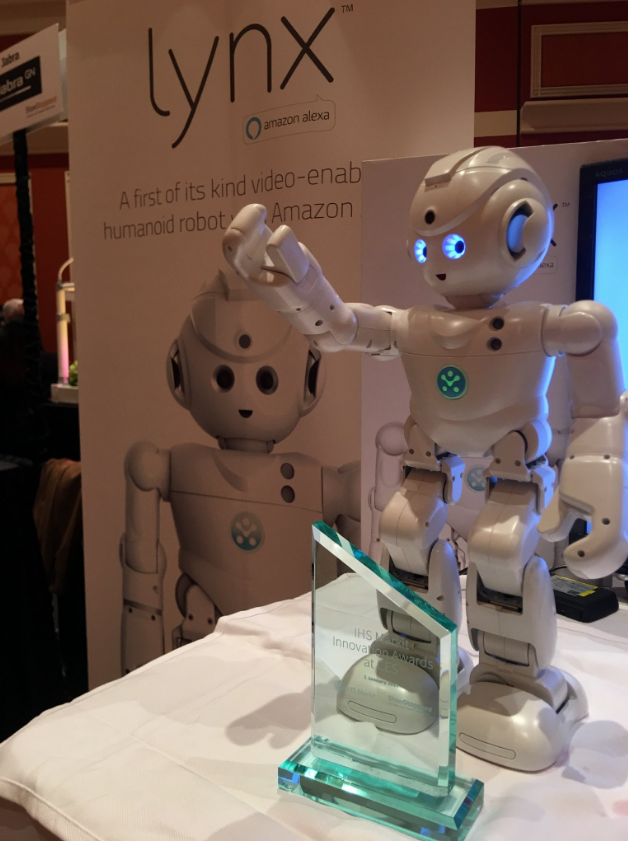
UBTechはShenzhen (中国・深セン) に拠点を置くロボット開発会社で「Lynx」 (下の写真) を発表した。LynxはAlexa Voice Serviceを組み込み、言葉でロボットを操作することができる。音楽再生やメールの読み上げなどを言葉で指示できる。Alexaが提供する機能の他に、Lynxは搭載しているカメラで利用者を識別し、個人に沿った対応ができる。また、カメラをセキュリティモニターとして使えば、Lynxが留守宅を監視する。価格は800ドルから1000ドルで2017年後半に発売される。ロボット開発では会話機能がネックとなるが、Alexa Voice Serviceを使うことで、開発工程が短くなる。手軽にロボットを開発でき、市場への参入障壁が大きく下がる。LynxはAlexaがロボットの標準インターフェイスとして普及する可能性を示唆している。

出典: UBTech  

テレビを音声で操作する

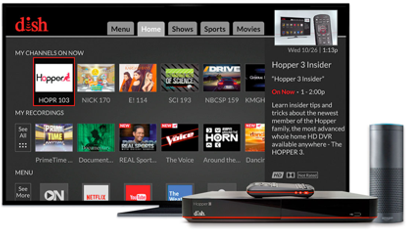
DISHは衛星テレビ会社でテレビ放送やインターネットサービスを提供する。DISHはセットトップボックス「Hopper DVR」をAmazon Echo又はDotとリンクし、テレビを言葉で操作できる機能を提供する (下の写真)。Echoに対し「Alexa, Go to ESPN」と指示すると、テレビはスポーツ番組「ESPN」にチャンネルを変える。番組を検索するときは「Alexa, what channel is the Red Sox game on?」と尋ねる。EchoはRed Soxの試合中継があるチャンネルを回答する。このサービス2017年前半から提供される。これからのテレビはリモコンだけでなく、音声操作が必須のインターフェイスとなる。GoogleはAI会話機能「Assistant」でテレビを音声で操作する機能を提供している。テレビ操作のインターフェイスでもAmazon AlexaとGoogle Assistantが覇権を争うことになる。

出典: DISH  

LGは冷蔵庫にAlexaを搭載

LGはスマート冷蔵庫「Smart InstaView Door-in-Door」 (下の写真) でAlexa Voice Serviceを利用することを発表した。冷蔵庫は29インチのタッチパネルを搭載し (下の写真、右上のパネル) Microsoft Cortanaを音声インターフェイスとして利用してきた。今般、LGはこれをAlexa Voice Serviceに変更する。Alexaが組み込まれることで、音声でレシピを検索し、ショッピングリストを作成できる。また、Amazonでの買い物が音声でできる。冷蔵庫はスマートホームのハブとしても機能する。LGスマート冷蔵庫は音声で操作できない家電は売れなくなることを示唆している。

出典: LG Electronics  

AIを駆使した高度な会話機能

メーカーが相次いでAlexaを採用する理由はAIを駆使した高度な会話機能にある。Alexaを搭載したデバイスは「Alexa」という枕言葉を検出すると、それに続く音声ストリームをクラウドに送信する。一連の会話処理はクラウドで実行される。具体的には音声認識 (Speech Recognition)、自然言語解析 (Natural Language Processing)、音声生成 (Text-to-Speech Synthesis) の処理が実行され、これらのプロセスでAIが使われている。単一のAIではなく、各モジュールに高度なAIが実装されボイスサービスを支えている。

Alexa人気の秘密は教育データ

Amazon Alexaが高度な会話機能を提供できる理由はAIアルゴリズムを最適化する教育データにある。教育データとは喋った言葉 (サウンド) とそれを書き下した文字 (テキスト) の組み合わせを指す。ボイス教育データとしてはコールセンターのオペレータの会話が使われる。しかし、家庭環境での会話 (「ガレージのドアを閉めて」など) をベースにした教育データは存在しない。Amazonは2014年に製品を出荷し、利用者からのフィードバック (下の写真) などを使い、教育データを整備してきた。この蓄積が高度な会話機能を支え、他社の追随を許さない理由になっている。

出典: VentureClef  

日本企業のオプションは

家電メーカー、自動車メーカー、ロボット開発企業はAlexa Voice Serviceを利用することで製品に会話機能を組み込むことができる。自社でAIボイス機能を独自に開発する手間が省ける。Amazon AWSを利用するように、これからはAlexa Voice Serviceが標準ボイスクラウドとなる勢いをみせている。AIの基礎技術であるボイスサービスをAmazonに頼るのか、それとも独自で開発する道を進むのか、日本産業は岐路に差し掛かっている。

ピカソが東京駅を描いたら、AIが画家のスタイルを手本に油絵を制作する

AIが著名画家のスタイルを学び、写真を油絵に変換するアプリが登場した。撮影した写真を入力するとAIがそれを芸術作品に仕上げる。誰でも手軽に絵を描くことができ、アプリの人気が急上昇している。同時に、AIが芸術の価値を下げアーティストの仕事を奪うと懸念の声も聞かれる。

出典: Hugh Welchman

全て油絵で描かれた映画

全て油絵で描かれた映画が公開されようとしている。これは「Loving Vincent」という映画で、ゴッホ (Vincent van Gogh) の生と死を描いている。映画の全シーンは油絵で描かれ、しかも、ゴッホの画風となっている。ゴッホの一生が自身の油絵で表現されている。この映画で使われた油絵の数は65,000枚で、115人の画家が制作に携わってきた。映画は六年に及ぶ制作を終え、今年初頭に封切られる。

動画のフレームをゴッホ流に描写

映画製作では俳優の演技をカメラで撮影し、それぞれのシーンを画家が油絵で描く。画家はゴッホのスタイルを学習し、動画のフレームをゴッホ流に描写していく。ポーランドの男優Robert Gulaczyk (上の写真右側)がゴッホを演じ、油絵として表現される (同中央)。男優はゴッホが描いた自画像「Self Portrait」 (同左側) のタッチで描写される。世界初の油絵映画として封切り前から話題となっている。

AIが画家のスタイルを習得

映画公開を前にGoogleから興味深い論文の発表が相次いだ。GoogleはAIが画家のスタイルを習得し、そのタッチで絵を描く技術を開発した。上述の映画のように、AIが写真を見てそれをゴッホのスタイルに変換する。一般に、芸術家の技法を手本に作成された作品はPasticheと呼ばれる。Loving VincentはPasticheで構成された映画として注目されている。

写真を著名画家の作風で再構成

Googleは絵画に関するPasticheをDeep Neural Networkで実装し、その成果を「A Neural Algorithm of Artistic Style」という論文で発表した。この技法は入力された写真を著名画家の作風で再構成する。

出典: Leon A. Gatys, Alexander S. Ecker, Matthias Bethge

ネットワークに写真 (上の写真左上) を入力すると、写真は三つのスタイルで作画される。左下はゴッホのスタイルに変換したもので、ここでは「The Starry Night (星月夜)」 (左下の小枠) を手本としている。右上はイギリスの画家ターナーによる「The Shipwreck of the Minotaur (マイノーターの難破)」を手本とし、右下はムンクの代表作「The Scream (叫び)」を手本としている。

ネットワークの構造

ネットワークはConvolutional Neural Network (CNN、イメージを認識する機能) を使っている。単一ネットワークが二つの機能を持ち、入力された写真を変換し、同時に、画家のスタイルを習得する。前者のプロセス (下の写真下段、Content Reconstructions) で、入力された写真の細部は切り落とされ、大まかな全体像が生成される。後者のプロセス (下の写真上段、Style Representations) で、画家の作品をネットワークに入力してスタイルを教育する。ネットワークの格段で特徴量を抽出し、絵画のタッチなど画家のスタイルを把握する。最後に写真と絵画を重ね合わせて最終イメージを生成する。

出典: Leon A. Gatys, Alexander S. Ecker, Matthias Bethge

32の異なるスタイルのPasticheを生成

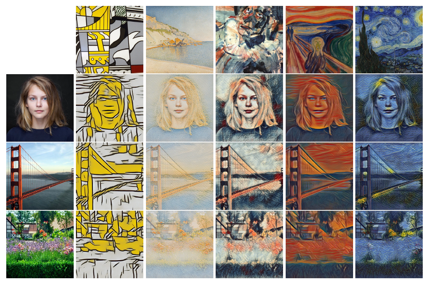
更に、Googleは上述の技法を強化した論文「A Learned Representation for Artistic Style」を発表した。単一ネットワークが32の異なるスタイルのPasticheを生成できる技術を開発した。下の写真がその事例で、写真 (左端) を入力すると、写真は五つの異なるスタイル (最上段) で変換される。前述の技法は一つのスタイルに限定されていたが、この技法では32のスタイルで絵を描くことができる。

出典: Vincent Dumoulin & Jonathon Shlens & Manjunath Kudlur

静止画だけでなくビデオを生成

更にこのネットワークは入力イメージの再構築をリアルタイムで実行する。つまりビデオを入力することができ、再構築されたビデオが出力される。Googleはこの技術を開発した理由を新しい芸術の門を開くためとしている。また、画家のスタイルを学習したネットワークはスマホアプリとしても利用できるとしている。

写真をアートにするアプリ

事実、ベンチャー企業からPasticheアプリが出荷されている。その中で注目のアプリは「Prisma」で、2016年夏にリリースされ5000万回ダウンロードされている。Prismaに写真を入力するとそれを著名な画家のスタイルで再構築する。Prismaは写真をフィルタリングしたり編集するアプリとは仕組みが根本的に異なる。前述の技法を使っており、AIが写真を分解し、学習した著名画家のスタイルで再構築する。写真が作画されたようにアートに生まれ変わる。

出典: VentureClef

モンドリアンが東京駅を描くと

Prismaに撮影した写真を入力する (上の写真左側) と、アプリは写真の下に、著名画家の作画スタイル (上の写真右側下段) を示す。希望のスタイルを選択すると写真がそのイメージに変換される。例えばモンドリアン (Piet Mondrian) のスタイルを選択すると、写真が縦横に分割され、赤青黄の三原色で再構築される (上の写真右側上段)。モンドリアンが蘇り東京駅を描くと、このような作品になるのかもしれないと、このアプリは想像を掻き立てる。この他にピカソ (Pablo Picasso) や葛飾北斎の「冨嶽三十六景」などのタッチも用意されている。

芸術の新分野を形作

アプリの普及とともにPasticheファンが増えている。写真サイトInstagramにはPrismaで生成したPasticheがたくさん掲載されている (下の写真)。どの写真を変換してもアートになるわけではなく、ここには見栄えのするPasticheが数多く掲載され、芸術の新分野を形作っている。Instagramには元々魅力的な写真が多いが、Prismaの登場でこれらが絵画になり写真の楽しみ方が豊かになった。

出典: Instagram  

AIが芸術家の仕事を奪う

同時に、AIが芸術家の仕事を奪うのではとの懸念の声も広がってきた。AIが動画のPasticheを生成できるので、Loving Vincentのような映画制作では芸術家が不要となる可能性も指摘される。一方、芸術家はPastiche制作という機械的な仕事から解放され、独自の創作活動に打ち込めるという考え方もある。AIは必ず手本を必要とし、独自の手法を生み出すわけではない。AIはコピーの域を抜け出すことはできず、芸術は人間の独創性から生まれる。

AIのビジネスチャンス

Pasticheを生成するAIは新しいビジネスを生むきっかけとなる。人間の芸術家が手作業でPasticheを作るより、これをAIに任せることで製作時間が大幅に短縮できる。特に、AIはアニメ制作で大きな可能性を秘めている。著名アニメアーティストのスタイルをAIが学習し、人間に代わりアニメ映画の製作などが期待される。事実、Prismaはアニメスタイルに変換するオプションを備えている。人間は創作活動に打ち込み、AIが作業を代行するという区分けができつつある。

人工知能は信用できるのか、AIのブラックボックスを開きそのロジックを解明する

AIの実力が高く評価されDeep Learningを応用したシステムが社会に広がっている。同時に、AIの問題点が顕著になってきた。AIは統計学の手法で入力されたデータから特徴量を高精度で検出する。メディカルイメージからガンの兆候を医師より正確に検知する。しかし、AIはなぜ癌細胞と判断したのか、その理由を語らない。

自動運転車は人間より遥かに安全に走行するが、その運転テクニックは開発者ではなくAIだけが知っている。我々はAIを信用できるのかという大きな課題に直面している。AIに生命を託すことができるのかの議論が起こっている。疑問に対する答えはAIの内部にある。AIのブラックボックスを開けて、そのロジックを解明しようとする研究が始まった。

出典: Xiaolin Wu, Xi Zhang

顔の特徴で犯罪者を特定

AIが抱える本質的な課題が様々な形で露呈している。中国のAI研究者は顔の特徴で犯罪者を特定する技法を発表した。これはShanghai Jiao Tong University (上海交通大学) で研究されたもので、「Automated Inference on Criminality using Face Images」として公開された。この論文によるとアルゴリズムは89%の精度で犯罪者を特定できる。つまり、顔写真をこのアルゴリズムに入力すると、この人物は犯罪者かどうかが分かる。

犯罪者には三つの特徴がある

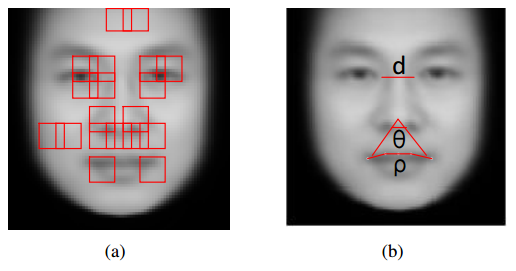
この研究ではDeep Learningなど顔を認識するAI技術が使われた。アルゴリズムを教育するために、男性の顔写真1856人分が使われ、そのうち730人は犯罪者である。また、この論文は犯罪者の顔の特性についても言及している (上の写真)。犯罪者には三つの特徴があり、一つは上唇のカーブが普通の人に比べ急なこと (上の写真右側、ρの分部)。また、両目の間隔が狭く、鼻と口元でつくられる角度が狭いことをあげている (上の写真右側、dとθの分部)。但し、この論文は公開されたばかりでピアレビュー (専門家による評価) は終わっていない。

背後にロジックがない

いまこの論文が議論を呼んでいる。人物の挙動から犯罪者を特定する手法は監視カメラなどで使われている。しかし、顔の特性から犯罪者を特定するAIは信頼できるのかという疑問が寄せられている。AIは学習データをもとに統計処理するが、顔の形状と犯罪者を結び付けるロジックはない。仮にこのAIが犯罪捜査で使われると、一般市民は理由が分からないまま容疑者とされる恐れもある。Deep Learningが社会問題となる火種が随所で生まれている。

GoogleのAIが女性を差別

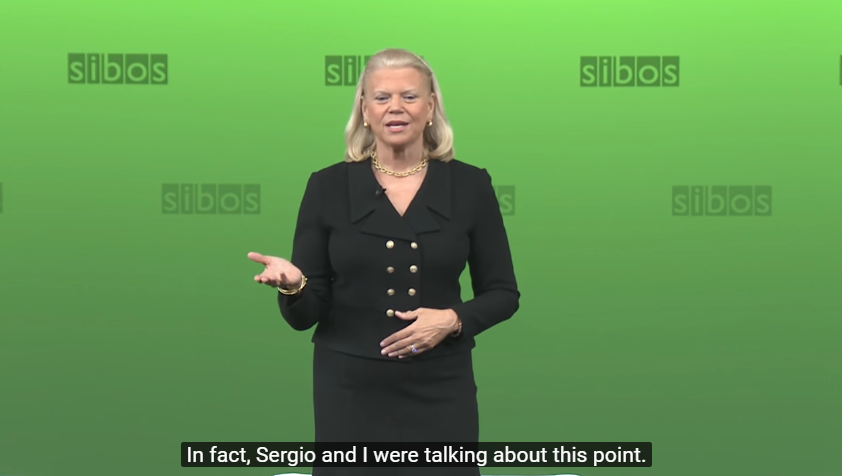
世界の最先端のAI技術を持つGoogleだが、AIに起因する問題点を指摘されている。YouTubeは聴覚障害者のためにキャプションを表示する機能がある (下の写真)。キャプションは発言を文字に置き換えるたもので、Googleの音声認識技術が使われる。その際に、男性が話す言葉と女性が話す言葉でキャプションの精度は異なるのか、調査が実施された。(National Science Foundation (アメリカ国立科学財団) のRachael Tatmanによる研究。)

出典: YouTube

YouTubeは女性の声を正しく認識しない

その結果、YouTubeは男性の声を女性の声より正しく認識することが判明した。具体的には、音声認識精度は男性の声だと60%で、女性だと47%に下がる。つまり、女性は音声認識精度において差別を受けていることが分かった。この差がなぜ生まれるかについては、システムを詳しく検証する必要がある。しかし、Tatmanは教育データセットが男性にバイアスしているのではと推測する。音声サンプルは均等ではなく男性に偏っていることを意味する。AIの性能は教育データの品質に敏感に左右される。AIによる女性差別や人種差別が顕在化しているが、学習データが公正であることが問われている。

AIが乳がんを判定する

AIの中心技法であるDeep Learningは乳がん検査の判定で成果を上げている。検体のイメージをDeep Learningのネットワークに入力すると、AIはがんを発症する組織を高精度に検出する。今ではAIの検知精度が人間を上回り、多くの病院でこのシステムの採用が始まった。同時に、健康に見える組織がAIによりがん発症の可能性が高いと判定されたとき、医師と被験者はどう対応すべきかが議論になっている。AIの判定を信頼し、手術を行うかどうかの判断を迫られる。

AIはその理由を説明できない

遺伝子検査でも同様な問題が議論されている。乳がん発症を促進する遺伝子変異「BRCA」が検出されたとき、手術に踏み切るかどうかが問題となる。女優Angelina Jolieは「BRCA1」キャリアで手術を受けたことを公表した。しかし、AI検診のケースはこれとは異なる。AIは統計的手法で乳がんと判断するが、その組織が何故がんを発症するのかは説明できない。AIは時に人工無能と揶揄されるが、科学的根拠のない判定をどう解釈すべきか医学的な検証が始まっている。

銀行は与信審査でAIを使う

銀行やフィンテックベンチャーはローン審査でDeep Learningを使い始めた。ローン応募者のデータをアルゴリズムに入力すると瞬時にリスクを査定できる。高精度に短時間でローン審査ができることから、この手法が注目を集めている。一方、米国では州政府の多くは銀行にローン申し込みで不合格になった人にその理由を説明をすることを義務付けている。

応募者に十分な説明ができない

しかし、Deep Learningはブラックボックスで、銀行は応募者に十分な説明ができない。更に、ローン審査の基準を変えるときは、学習データを使ってアルゴリズムを再教育することとなる。ソフトウェアのロジックを変更するようにはいかず、大量のデータを読み込んでDeep Learningのパラメータを再設定する。金融業界でAIを導入することの是非が議論されている。

出典: Mahmood Sharif et al.

AIは眼鏡で騙される

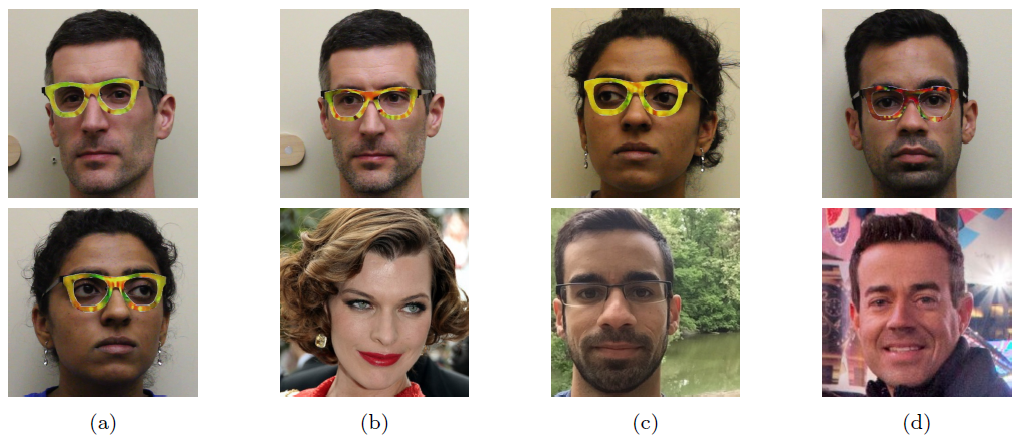
Carnegie Mellon UniversityのMahmood Sharifらは、眼鏡で顔認証システムが誤作動することを突き止めた。これは「Accessorize to a Crime: Real and Stealthy Attacks on State-of-the-Art Face Recognition」として公開された。フレームの幅が少し広い眼鏡 (上の写真(a)の列) をかけると、システムはこれらの写真を顔として認識できない。つまり、街中に設置されている防犯カメラの監視システムをかいくぐることができる。

眼鏡で別人に成りすます

また、フレームのプリントパターンを変えると、顔認識システムは別の人物と間違って認識する。上の写真(b)から(d)の列がその事例で、上段の人物が眼鏡をかけることで、顔認識システムは下段の人物と誤認識する。(b)のケースでは、上段の男性が眼鏡をかけるとシステムは米国の女優Milla Jovovichと誤認した。顔認識システムはDeep Learningの手法で顔の特徴を把握するが、この事例から、目元のイメージが判定で使われていると推定できる。しかし、AIが実際にどういうロジックで顔認証をしているかは謎のままである。これが解明されない限り、顔認証システムを不正にすり抜ける犯罪を防ぐことはできない。

ニューラルネットワークと脳の類似性

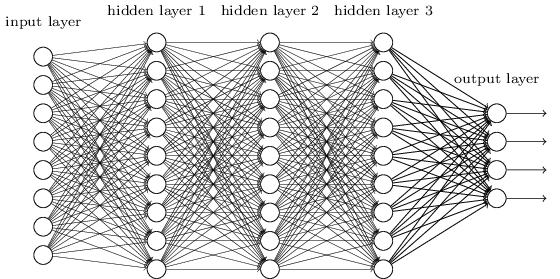
AIの基礎をなすNeural Network (下の写真) でイメージを判定する時は、写真とそのタグ (名前などの種別) をネットワークに入力し、出力が正しく種別を判定できるよう教育する。教育過程ではネットワーク各層 (下の写真、縦方向の円の並び) 間の接続強度 (Weight) を調整する。この教育過程は脳が学習するとき、ニューロンの接続強度を調整する動きに似ているといわれる。

出典: Neural Networks and Deep Learning

ネットワークの中に分散して情報を格納

学習で得た接続強度は各ニューロン (上の写真の白丸の分部) に格納される。つまり、Neural Networkが学習するメカニズムの特徴はネットワークの中に分散して学習データを格納することにある。プログラムのようにデータを一か所に纏めて格納する訳ではない。人間の脳も同じメカニズムである。脳が電話番号を覚えるときには、最初の番号は多数のシナプスの中に散在して格納される。二番目の番号も同様に散在して格納されるが、一番目の番号と近い位置に格納されるといわれる。人間の脳を模したNeural Networkはデータ格納でも同じ方式となる。

知識がネットワークに焼き付いている

問題はこの格納メカニズムが解明されていないことにある。脳の構造を模したNeural Networkも同様に、情報が格納されるメカニズムの解明が進んでいない。Deep Learningの問題点を凝縮すると、知識がネットワークに焼き付いていることに起因する。ニューロンの数は数千万個に及び、ここに知識が散在して格納されている。知識はシステムを開発した人間ではなく、ネットワークが習得することが問題の本質となる。

自動運転車のアルゴリズム

Carnegie Mellon Universityは1990年代から自動運転技術の基礎研究を進めていた (下の写真はその当時の自動運転車)。当時、研究員であったDean Pomerleauは、カメラで捉えた映像で自動運転アルゴリズムを教育した。走行試験では、数分間アルゴリズムを教育し、その後でクルマを自動走行させる試験を繰り返した。試験はうまく進んだが、橋に近づいたときクルマは道路からそれる動きをした。しかし、アルゴリズムはブラックボックスでPomerleauはその原因が分からなかった。

出典: Dean Pomerleau et al.

試験を繰り返し問題点を特定

ソフトウェアをデバッグする要領でロジックを修正することができない。このためPomerleauは路上試験を繰り返すことで問題点を解明した。様々な状況で自動運転を繰り返し、経験的に問題点を突き止めた。それによると、クルマは路肩の外側に生えている草の部分を基準にして走行路を判定していることが分かった。橋に近づくと草の部分がなくなり、クルマは判断基準を失い、正常に走行できなくなる。自動運転技術をAIで実装するとクルマが正しく動くのか確信が持てなくなる。

大規模な走行試験で安全性確認

現在でも同じ問題を抱えている。自動運転車は無人で公道を走ることになるが、我々はAI技術を信用していいのかが問われている。AIの運転ロジックが分からない中、どう安全基準を作ればいいのか試行錯誤が続いている。その一つに、定められた距離を無事故で走行できれば安全とみなすという考え方がある。シンクタンクRand Corpによると、人間がクルマを1億マイル運転すると死亡事故は1.09回発生する。自動運転車が人間と同じくらい安全であることを証明するためには2.75億マイルを無事故で走る必要がある。人間レベルの安全性を証明するためには大規模な走行試験が必要となる。自動運転車の安全基準を設定する作業は難航している。

Deep Learningを使った運転技術

この問題を技術的に解明しようとする動きも始まった。NvidiaはDeep Learningを使った運転技術を開発している。自動運転システムは「DAVE-2」と呼ばれ、Neural Networkで構成される。人間がアルゴリズムに走行ルールを教えるのではなく、システムはNeural Networkで画像を処理し安全な経路を把握する。システムはカーブしている道路のイメージを読むと、そこから運転に必要な道路の特徴を把握する。

AIがルールを学習する

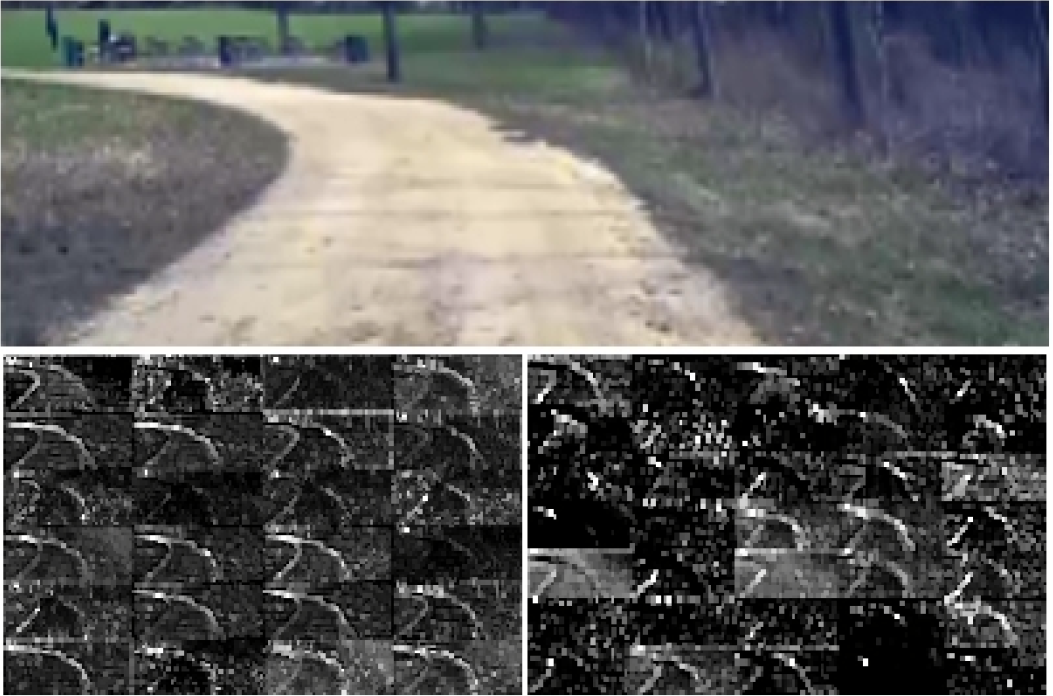
NvidiaはAIがどういう基準で意思決定しているのかの研究を進めている。今までブラックボックスであったAIの中身を解明する試みだ。下の写真が研究成果の一端で、AIが道路をどう理解しているかを示している。上段はカメラが捉えた画像で、下段はCNN (画像認識するNeural Network) がこれを読み込み、そこから道路の特徴を示している。特徴量は曲線が殆どで、CNNは道路の境界部分を目安に運転していることが分かる。この画面からAIが習得したドライブテクニックを人間がビジュアルに理解できる。

出典: Nvidia

2017年はAIロジックの解明が進む年

自動運転車を含む自立系システムはDeep Reinforcement Learning (深層強化学習) という手法を使い、アルゴリズムが試行錯誤を繰り返してポリシーを学習する。この技法は囲碁チャンピオンを破ったGoogle AlphaGoでも使われている。Deep Reinforcement Learningの中身もブラックボックスで、これからこの解明も進むことになる。AIは目覚ましい成果を上げ世界を変え続けるが、2017年はAIのブラックボックスを開けそのロジックの解明が進む年となる。

Facebookで虚偽ニュースが増幅し大統領選挙が混乱、AIで記事の真偽を判定する試みが始まる

アメリカ大統領選挙では偽りのニュースが飛び交い、有権者が大きな影響を受けた。ニュースの題名は衝撃的なものが多く、記事は著者の主張が論理的に展開され疑問を挟む余地はない。偽のニュースはFacebookに表示され、口コミで広がり大きな社会問題となった。Obama大統領が名指しで問題点を指摘し、Facebookは虚偽ニュース対応に乗り出した。

出典: Snopes.com  

虚偽ニュースによりTrump氏が勝利した

Facebookが表示するニュースに虚偽情報が含まれていることは早くから問題となっていた。大統領選挙では虚偽ニュースによりTrump氏が勝利したとまで言われ、この件が一気に政治問題に発展した。FacebookはTrump氏を推す虚偽ニュースをNews Feedに掲載し、口コミでTrump支援者が増えたとされる。CEOのMark Zuckerbergはこれが勝敗に影響したという解釈を否定しているが、偽ニュースを抑止する対策をとることを表明した。

ローマ法王がTrump氏を大統領に推奨する

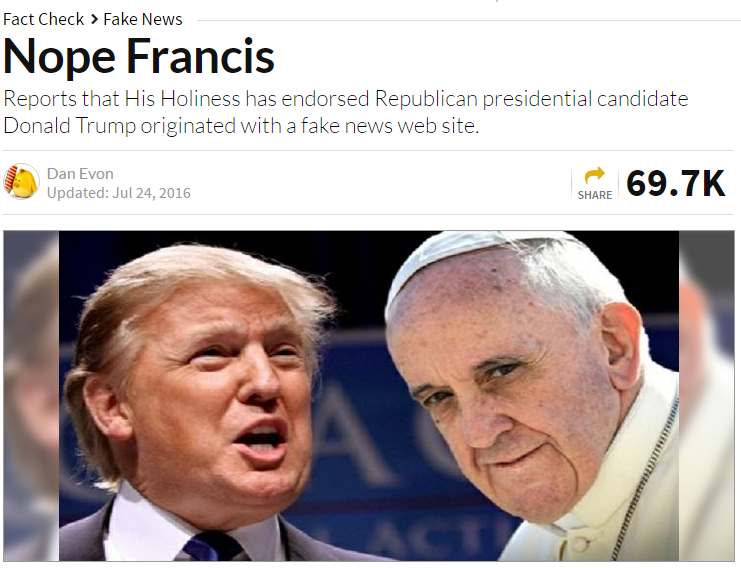
大統領選挙では数多くの虚偽ニュースが飛び交った。ニュースはセンセーショナルで人目を引くものが多い。その事例として、WTOE 5 Newsというサイトは「ローマ法王がTrump氏を大統領に推奨する」という偽りの記事を発信した。これに対し、ニュースを検証するサイトはこの記事は偽りと注意を喚起した (上の写真)。これに先立ち、「ローマ法王がClinton氏を大統領に推奨する」という記事も発信された。選挙が終わり、「ローマ法王は選挙結果に失望した」という記事も掲載された。

Clinton氏が米国国歌を見直すべきと提案

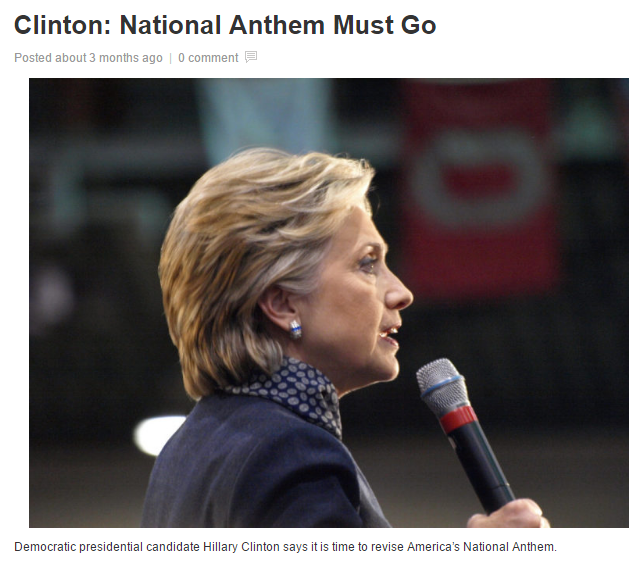
また、National Reportというサイトは「Clinton氏が米国国歌を見直すべきと提案した」という偽りの記事を掲載した (下の写真)。更に、Clinton氏はその理由を「歌詞が拳銃などによる暴力につながる」とし、「国歌は宗教と国家の分離原則に抵触する」と述べたとしている。

出典: National Report

虚偽であると判断するのは難しい

このニュースは事実ではなく虚偽の内容である。しかし、怪しいとは感じるものの、一読してこれらが虚偽であると判断するのは難しい。ニュースサイトの名前や外観やURLは本物のように見える。記事のタイトルからも不正を感じさせるものはない。記事を読み始めると、考え方に共感するところもあり、最後まで読んでしまう。ところどころ違和感を感じるが、記事が虚偽であることは見抜けない。むしろ、興味深い内容に惹かれる。

偽ニュースを発信するサイトとは

このNational Reportは名前から権威あるニュースサイトのように思える。同社はホームページで中立ニュースを発信するとうたっている。しかし、National Reportが掲載するニュースは事実ではなく、虚偽ニュースだけを発信する。この目的は魅力的な虚偽のニュースでページビューをあげ、サイトに掲載する広告で収入を得ることにある。ページビューが高いニュースは一件で1万ドルの広告収入があるとされる。但し、今ではGoogleなどが虚偽ニュースサイトへの広告掲示を停止し、National Reportサイトでの広告収入は激減した。

ソーシャルメディアが偽ニュースを増幅

National Reportは虚偽ニュースを発信してきたが、同社だけでは社会的な影響は限られている。しかし、Facebookなどソーシャルメディアに記事が表示され、賛同者の数が増え、記事へのリンクが転載されることで、この記事の出現回数が爆発的に増える。Facebookは人気記事をTrendingとして示し、ここに虚偽ニュースが掲載されると全国規模で広がる。このようにFacebookなどのソーシャル機能が悪用され、虚偽ニュースが世論を動かす力となった。

Trump陣営が虚偽のニュースを引用

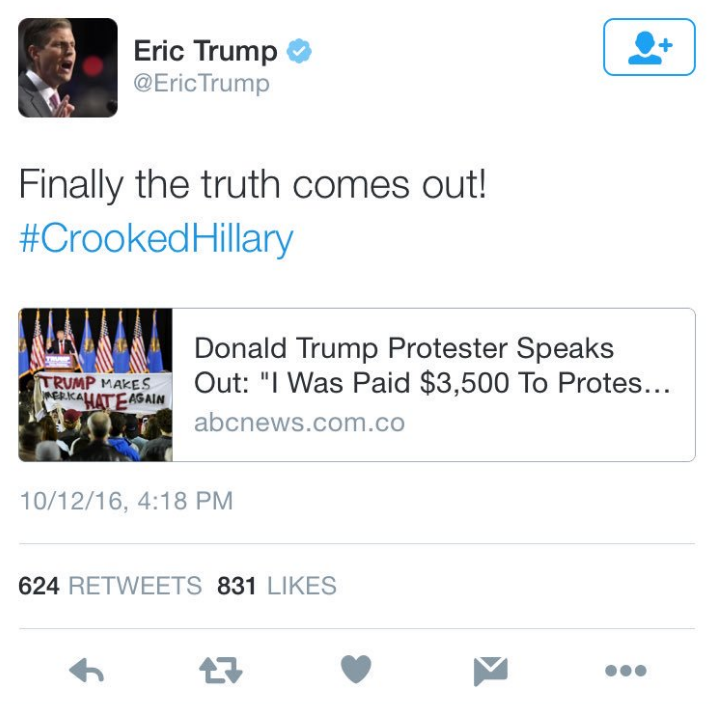
大統領選挙ではTrump陣営が虚偽ニュースを引用してClinton候補を攻撃する場面もあった。Eric Trump氏は偽ニュースだとは思わず、記事の内容を根拠に論戦を展開した。ツイートで「Trump講演会で反対運動をする活動家はClinton陣営から3500ドル貰っている」という記事を引用した (下の写真)。しかし、このニュース記事は真実ではなかった。ツイートは削除されたが、そのコピーが今でも多くのサイトに掲載されている。選挙戦当事者も偽ニュースを見分けるのに時間がかかった。

出典: Eric Trump

Facebookの偽ニュース対策

Facebookは早くから偽ニュース (Hoaxes) への対策をとっている。2015年1月には会員が偽ニュース記事を報告できる仕組みを導入した。これはスパムメールを申告するように、News Feedに表示されたニュースが真実ではない場合にはその旨を申告できる。読者からの申告で偽ニュースがNews Feedに表示される回数が減らされる。クラウドソーシングの手法での対応策を始めた。

サイトに誘導する記事や偽記事を抑制

Facebookは2016年8月には、News Feedから「Clickbait」記事を削除する対策を打ち出した。Clickbaitとは意図的に内容を伏せてサイトに誘導する手法を指す。例えば記事の導入部分で「信じられないことに、昨夜レッドカーペットの上でセレブ同士が喧嘩になった。それは誰なのか。。。」と書くと、気になってリンクをクリックして続きを読む。これはサイトに誘導する常套手法であるがFacebook利用者にはたいへん不評。FacebookはClickbaitがNews Feedに出現する回数を抑制した。

出典: Celeb Style Weekly

Machine Learningの手法で偽ニュースを特定

Clickbaitには読者をミスリードする記事も含まれ、偽ニュースを抑制する対策も取っている。Clickbait記事対策ではアルゴリズムを開発し、検出プロセスを自動化した。Facebookはサイトに誘導する記事やミスリーディングな題名の事例を集めClickbaitのデータセットを作成した。これら事例を通常ニュースの題名と比較し、Clickbaitに特有なシグナルを特定した。Clickbaitを検出するアルゴリズムを開発し、これをMachine Learningの手法で教育した。アルゴリズムは学習を重ね検出精度を上げていく。これはスパムメールを検出する方式に似ており、News Feedから虚偽ニュースを排除できると期待されてきた。

大統領選挙では偽ニュースを防げなかった

このような対策をとっているにも拘わらず偽ニュースは増え続け、大統領選挙では有権者を混乱させる原因となった。Facebookが開発したアルゴリズムはニュースタイトルを基準に判定するので偽ニュースを見分ける精度が十分とは言えない。本格的に対応するにはタイトルに加え、本文に踏み込んだ判定が必要となる。

記事を虚偽と判定するのは人間でも難しい

前述の通り記事を虚偽と判定するのは人間でも難しい。明らかな偽りを判定するのは容易だが、記事の内容を把握し、事実関係の検証が求められる。(下の写真は明らかに虚偽ニュースと分かる事例。大統領選挙でTrump氏の勝利が決まった直後、「Obama大統領は大統領令を発令し選挙結果を検証する」という記事が発行された。)

出典: ABCNews.com.co

事実を検証する作業が求められる

多くのケースでニュース記事を読んだだけではそれが真実かどうかを判断するのが難しい。記事で述べられる主張を裏付ける事実を確認する作業が必要になる。主張の出典を探し事実関係を確認する。また、主張を裏付ける事実が確認できたとしても、記事の中で事実を誇張したり、拡大解釈するケースは少なくない。記事検証ではこれらのステップを踏み、内容が正しいかどうかの判定を下す。

真実を突き止めるには限界がある

記事検証では真偽を判定するのが目的であるが、判定できないケースも多々ある。Trump氏が大統領に選ばれたことに抗議して#NotMyPresidentというデモが全米各地で起こった。デモ参加者はClinton支持者で、Trump氏は我々の大統領ではないと抗議の意思を表示した。記事は「デモ参加者は投票所には行っておらず、Clinton氏に投票していない」と分析する (下の写真)。しかし、この事実関係は確認できず、この記事の真偽は判定できない。真実を突き止めるには限界があるのも事実。

出典: ZeroHedge

Facebook記事の真偽を判定するソフト

この問題に大学生たちが挑んでいる。Facebookに掲載される記事の真偽を判定する技法を開発した。大学生たちはAIを最大限に活用し、Facebook記事を解析するソフトウェア「FiB」を開発した。FiBはブラウザーのプラグインとして実装され、Facebook記事を読みその内容を判定する。記事が虚偽であると「Not Verified」と表示する。一方、真実であると「Verified」と表示する。(下の写真はNot Verifiedと判定された事例。「大麻ががん細胞を破壊する」という記事を解析し、これは虚偽であると判定した。)

AIクラウドを使って真偽を判断

FiBはAIを使って真偽を判断する。投稿された記事に掲載されている写真を認識し、それをテキストに変換する。また記事からはキーワードを抽出する。検索エンジンでこれらの出典を調べ、事実かどうかを確認する。更に、Twitter記事のスクリーンショットが掲載されている場合は、その出典をTwitterで検索する。Twitterスクリーンショットが偽でないことを確認する。

Facebookより先にソリューションを開発

学生たちは公開されているAIクラウドのAPIを最大限に活用してシステムを作った。具体的には、Microsoft Cognitive Services、Twitter Search API、Google Safe Browsing APIなどを使っている。記事判定の精度の検証はこれからであるが、世界最先端のAI技術を持つFacebookより先にソリューションを開発したことは特筆に値する。

出典: FiB Project

ファクトチェックサイトが注意を喚起

アルゴリズム開発とは別に、多くの団体が人手で記事の真偽を判定している。これらはファクトチェックサイトと呼ばれ、大統領選挙では有権者に偽ニュースに誘導されないよう注意を喚起した。その代表がFactCheck.orgという独立の非営利団体 (下の写真)。University of Pennsylvaniaの研究機関として活動を開始し、政治問題に関し政治家の主張の真偽を詳細に検証する。また、読者に偽ニュースを見分ける方法などを指導する。

(下の写真はFactCheck.orgが政治家の主張を分析した事例。下院議長Paul Ryanは米国医療制度Medicareはオバマケアーにより破たんしたと主張する。しかし、FactCheck.orgはこの主張は間違いと結論付けた。)

人気のファクトチェックサイト

人気のファクトチェックサイトはSnopes.com (先頭の写真) で1995年に設立された。このサイトはメールやフォーラムを対象に記事の真偽を判定する目的で設立された。大統領選挙では政治ニュースに焦点を当て、問題点を指摘し有権者に注意を喚起した。分かりやすい表現で多くの人に利用されている。また政治問題だけでなく、ビジネス、エンターテイメント、健康、宗教、テクノロジーなど幅広い分野をカバーする。

Fake Newsは後を絶たない

大統領選挙が終了した後も偽ニュースは後を絶たない。民間人に贈られる最高位の勲章「Presidential Medal of Freedom」授与式が11月22日、ホワイトハウスで執り行われた。映画俳優Robert De NiroらにObama大統領からメダルが授与された。一方、Clint EastwoodのTwitterにメダル授与を拒否したとのコメントが掲載された。その理由としてObama氏は私の大統領ではないと述べている。これは真実ではなく、Eastwoodになりすました人物が発信したもので、ソーシャルメディアから偽りのニュースが流れ続けている。

出典: FactCheck.org

Facebookは米国最大のメディア企業

ソーシャルメディアが生活に浸透し、ニュースの読み方が大きく変わってきた。Pew Researchによると米国の成人の62%がソーシャルメディアでニュースを読む。これをメディア別に分類すると、米国の成人の44%がFacebookでニュースを読んでいる。YouTubeやTwitterがこれに続くが、Facebookがニュース配信メディアとしてトップの位置にいる。

Facebookの責任論

ZuckerbergはFacebookはメディア企業ではなく、記事の真偽を自社で判定すべきでないとの立場をとってきた。記事の真偽の判断は読者に委ねてきた。しかし、Facebookが米国最大のニュース配信企業となっている事実を勘案すると、掲示するニュースの品質についてFacebookが責任を負うべきという議論が主流となっている。同様に、GoogleやTwitterも対策を求められている。Googleは既に、偽ニュースサイトへの広告配信を停止した。

Facebookが対策に乗り出す

偽ニュースが国民的な問題となり、Facebook社内で問題意識を持つ社員が集い、自主的に問題解決に向け動き始めたとも伝えられる。Zuckerbergもポジションを変え、対策に乗り出すと表明した。今頃はAIを駆使したソリューションが開発されているのかもしれない。メールからスパムがフィルターされたように、News Feedから偽ニュースが消えることを期待する。