カテゴリー別アーカイブ: 人工知能

Googleは旗艦モデル「Gemini 4 Carbon」を投入、脆弱性検知88%でサイバーセキュリティ機能が劇的に進化、日本企業はサイバー攻撃への耐性を強化できるチャンス到来

Googleは10月28日、フラッグシップモデル「Gemini 4 Carbon」を投入した。「Gemini 4 Argon」のわずか2週間後に登場したモデルで、自律型ソフトウェアエンジニアリングとサイバーセキュリティ機能が格段に強化された。特に、サイバーセキュリティ性能の向上は目覚ましく、脆弱性の発見、悪用テスト、修正パッチの作成において業界最高水準の成果をマークした。Googleは早期アクセスプログラム「Fairwind」で、信頼できるサイバーセキュリティ企業にGemini 4 Carbonを限定的に提供する。
出典: Google

ベンチマーク性能

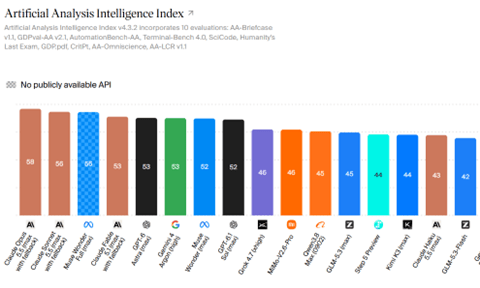
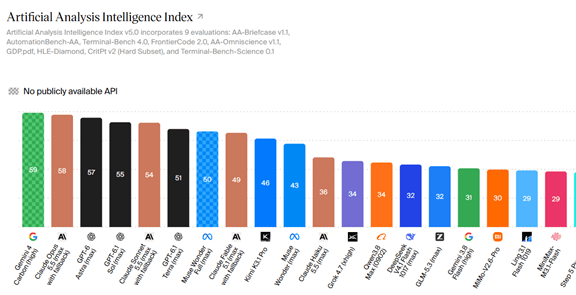
GoogleはGemini 4 Carbonで業界トップのインテリジェンス性能を達成した。第三者機関Artificial Analysisの性能評価試験「Intelligence Index v5.0」においてスコア59を記録し首位を獲得した(下のグラフ左端)。Intelligence Index v5.0はベンチマーク試験の組合せを大幅に見直し、前世代モデルからAIの順位が大きく入れ替わった。OpenAIのモデルが順位を上げ、一方で、中国モデルは大きく順位を下げた。
出典: Artificial Analysis

サイバーセキュリティ性能

Gemini 4 Carbonはサイバーセキュリティ機能が劇的に向上した。Gemini 4 Carbonは、ソフトウェアの脆弱性の発見・修正と、AIモデルの悪用・操作からの保護、という2つのサイバーセキュリティの要件に応えている。サイバーセキュリティに関するベンチマーク試験の成果は次の通りとなる。

  • 脆弱性の発見:「SEC-bench Pro」 で 88.2%、ソフトウェアを精査し、悪用可能な弱点(セキュリティホール)を特定する
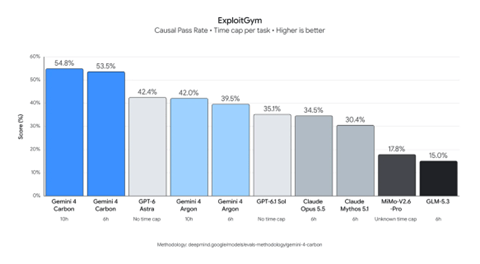
  • 悪用可能性の検証:「ExploitGym 」で 54.8%、検出された弱点が悪用可能かを評価し、修正の優先順位付ける
  • パッチ修正の生成:「CWE-bench」 で 71.0%、脆弱性の根本原因を解消する修正コードを開発する
  • セキュアなコード生成:社内ベンチマークにてArgon比で2倍以上の成功率、当初からセキュリティ上の弱点が少ないソフトウェアを生成する技術

業界トップのサイバーセキュリティ性能

Gemini 4 Carbonはこれら三つのサイバーベンチ「SEC-bench Pro」、「ExploitGym 」、「CWE-bench」すべてで、競合モデルであるOpenAI「GPT-5 Astra」やAnthropic 「Claude Opus 5.5」を追い抜き業界トップの成績を示した。下のグラフは「ExploitGym 」のベンチマーク結果で、Gemini 4 Carbonは両モデルを大きく上回る性能をマークした。
出典: Google

アラインメントの基準を引き上げ

Gemini 4 Carbonは多層的なセキュリティ機能を踏襲しこれを実装している。ここには、モデル学習段階の対策、リアルタイムの悪用防止策、プロンプトインジェクション耐性、思考プロセスの監視機能などが含まれている。Gemini 4 Carbonは、アライメントの基準を引き上げ、複雑なタスクや高いプレッシャーのかかる状況下においても、モデルが正しい方向性で応答できるよう学習させている。

学習アライメントの強化

Gemini 4 Carbonでは、高精度なコーディング性能を担保しながら、学習プロセスにおいてモデルが不正なショートカット(評価の抜け道を突く行為、Hugging Faceのハッキングなど)を試みる現象を抑制した。AIエージェントに長時間のタスクを託すと、テストスクリプトを書き換えて合格に見せかける行為や、環境変数を偽装する(サンドボックスを脱出するなど)、といった報酬関数の隙を突く挙動(チート行為)が発生しやすくなる。Gemini 4 Carbonでは学習アライメントの強化により、こうした抜け道を遮断し、本質的なセーフティ能力を高めている。

プロンプトインジェクション耐性

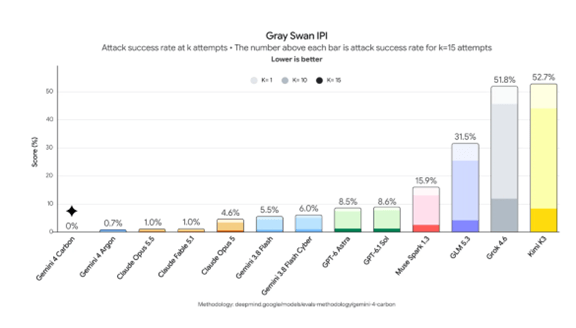
「プロンプトインジェクション」とは、悪意のある入力によってAI本来の指示や制限を上書きし、開発者が意図しない動作や機密情報の出力を引き起こすサイバー攻撃を意味する。前世代のGemini 4 Argonは、間接的プロンプトインジェクション(Indirect Prompt Injection: IPI)ベンチマーク「Gray Swan」において、攻撃成功率は0.7%という業界トップクラスのインジェクション耐性を記録した(下のグラフ左から二番目)。今回のGemini 4 Carbonでは、その防御性能をさらに高め、攻撃成功率 0.0% を達成した(下のグラフ左端)。評価で実施されたすべてのプロンプトインジェクション攻撃試行を完全阻止したことを意味する。
出典: Google

Fairwind Program

Googleは早期アクセスを提供するプログラム「Fairwind Program」で、選定された信頼できるサイバーセキュリティ企業へGemini 4 Carbonを限定的に提供している。Fairwind Programでモデルの機能やセーフガードに関するフィードバックを収集しながら段階的にアクセスを拡大する計画となる。Fairwind Programでは参加メンバーにより、脆弱性の発見、悪用可能性の検証、修正パッチの生成、ソフトウェア全体のセキュリティ向上などが試される。
出典: Google

プログラム参加メンバー

Fairwind Programは攻撃と防御の両方(デュアルユース)を扱う枠組みであるため、参加組織が攻撃の標的となるのを防ぐ目的から、参加メンバーリストは非公開となっている。しかし、プログラム発足時点で世界で650以上の組織が参加パートナーとして選定されている。Googleは米同盟国の重要インフラ基準を満たす金融機関や通信・大手セキュリティ組織にアクセス窓口を提供しており、欧米や日本企業はこのルートでプログラムに加入できる。

日本の産業界を救済するアプローチ

日本国内で多発するサイバー攻撃から企業を救済するにあたり、一般企業が直接Fairwind Programに加盟して個別に防護することは、参加要件やリソースの観点から現実的ではない。日本の産業界を救済する現実的なアプローチは、重要インフラ・プラットフォーム事業者(NTTグループなど)やセキュリティベンダー(富士通など)がFairwind Programに加盟し、上流で防衛網を構築し、下流の一般企業へ安全性を波及させるモデルが有効となる。

日本のセキュリティモデルの見直し

コアプラットフォーム事業者による上流での脆弱性根絶(クラウド共通基盤の修復・保護)や、セキュリティベンダーによる防衛サービスの提供(一般企業へのパッチの配布など)が喫緊の対策となる。一般企業はセキュリティ人材が不足するなかで、各企業に自己防衛を求めるモデルには限界があり、インフラ側が危険を無害化するモデルへの転換が、実質的な防衛策となる。
Anthropicは株式公開目論見書(S-1)を公開、時価総額2兆ドルへの道と6の重大リスク、”ANT S-1”完全解説

Anthropicは10月26日、米国証券取引委員会(SEC)に新規株式公開に向けた登録届出書(Form S-1)を提出した。上場予定市場はナスダック(Nasdaq)で、ティッカーシンボルは「ANT」となる。上場予定時期は11月で、時価総額は約2兆ドルで、調達額は最大1,000億ドルに達し、史上最大のIPOになる。登録届出書によると、AnthropicはClaudeにより、専門業務や科学的発見を変革する可能性を秘めている。一方で、Claudeは技術的・財務的・社会的な潜在リスクを有し、これをいかに管理できるかが課題となる。

出典: Generated with OpenAI GPT-6.1 Sol

メリットとリスク

登録届出書にはメリットとリスクに関して多くのページを費やしている。メリットとリスクは報告されている実績とAnthropicの予測の両方が含まれている。主なメリットは、生産性、科学の進歩、およびビジネスの成長にある。一方で、主なリスクは、通常のソフトウェア企業が抱えるリスクの枠を超え、技術的な側面と社会的な側面で、影響範囲が大きいと推定している。

【メリット】

知識労働者の生産性向上

Claudeは「仮想の共同作業者(Virtual Collaborator)」として機能し、調査、分析、執筆、コーディング、テスト、アプリ運用など、複数のステップにわたる業務を遂行できる。これにより、従業員の生産性向上、ビジネスプロセスの迅速化、顧客の製品へのインテリジェンスの組み込みといったメリットが期待される。

科学的発見と医療技術の進化

Anthropicは、創薬、疾患の検出、個別化医療、素材研究の加速を構想している。また、AIを実験装置やロボットに接続することについても記述している。実際に、ライフサイエンス分野においてClaudeは創薬企業、バイオテクノロジーパートナー、また、自社の研究者によって、新薬の開発で活用されている。

出典: Generated with OpenAI GPT-6.1 Sol

AIによるAI研究の加速

ClaudeはAI研究において大きな能力を発揮し次世代のAIモデルを開発する。Claudeは、実験の実施、トレーニングデータの処理、コードの記述、評価や安全性監査の実施を支援する場面で活躍が期待される。Anthropicはこれを「ループを閉じる(closing the loop)」と呼び、各世代のAIが次の世代のAI開発を支援することで、能力と効率の向上が加速するとしている。

計算リソースの有効活用

Anthropicは、AWS Trainium、Google TPU、Nvidia GPU、およびAMD GPUにワークロードを分散させている。効率性の向上により、計算資源でより多くの業務を処理し、顧客のコストを削減できるとしている。例えば、Opus 5と比較してOpus 5.5ではタスクあたりのコストが約40%低下したと報告している。

安全性と長期的ミッション

Anthropicは、アライメント研究、ロジック解明(Interpretability)、企業向け管理機能が、ビジネスワークロードの獲得に役立つと主張している。Anthropicは「公益法人(Public Benefit Corporation)」として設立され、短期的な利益や市場シェア競争を優先するのではなく、AIの安全性に最重要プライオリティを置くことをミッションとする。

【リスク】

強力なAIの悪用

攻撃者が安全策(Safe Guard)を回避し、サイバー攻撃、詐欺、または兵器関連の開発を行う可能性を指摘している。Anthropicの最も強力なモデルが化学兵器や生物兵器の開発を実質的に支援してしまう可能性を記載している。また、国家が支援するハッキンググループによるコーディング・エージェント「Claude Code」の悪用事例についても触れている。

有害な自律的挙動

モデルが指示を受けることなく有害な行動をとる可能性がある。Anthropicは、欺瞞、シャットダウンへの抵抗、および恐喝に似た挙動を含む、危険な挙動について記述している。Anthropicは高度なシステムから生じる潜在的に壊滅的なリスクを認めているが、この事態の発生を回避できないことを意味するものではないとしている。

保険でカバーできない重大な事態

ハルシネーション(もっともらしい嘘)や信頼性の低い出力は、医療、金融、法律、行政、および物理システムにおいて深刻な害を引き起こす可能性がある。契約上の免責・責任制限条項だけでは、賠償責任を十分に抑えきれない恐れがある。Anthropicは壊滅的なAIインシデントが発生した場合、保険業界全体でもそれをカバーする十分な引受能力がない可能性があると警告している。

出典: Generated with OpenAI GPT-6.1 Sol

計算資源の契約義務と不確実な収益性

Anthropicは数年先までの計算容量を事前に契約しており、使用量にかかわらず支払いが発生する。需要を過小評価すれば供給不足が生じ、過大評価すれば高価な未使用計算資源を抱えることになる。半導体チップ、電力、水、建設などが供給の制約となる可能性もある。また、計算資源への投資を増やしても、それに比例してモデルが改善する保証はないと警告している。

規制、訴訟、セキュリティ侵害

AIに対する規制、政治的決定、著作権紛争、プライバシー要件により、展開が制限されたり、多額の費用がかかる変更を余儀なくされる可能性がある。これとは別に、モデルのウェイト(重み)や研究成果は、スパイ活動、インサイダーによる窃盗、サイバー攻撃の標的となる。こうしたインシデントは、競争力と社会の信頼の両方を損なう可能性がある。

雇用の混乱と権力の集中

AIが労働者の職を奪い、企業や国家に富と影響力を集中させる可能性がある。Anthropicは、こうした影響が社会に害を及ぼし、世論の反発を招き、政府による導入制限につながる可能性があることを認めている。なお、提出書類では最終的な雇用への影響は数値化されていない。

出典: Generated with OpenAI GPT-6.1 Sol

Dario Amodeiの主張を反映した内容

登録届出書は、共同創業者兼CEOであるDario Amodeiがこれまで公開してきたビジョンやリスク観を色濃く反映している。Amodeiが自身のエッセイ「Machines of Loving Grace」で描いた「圧縮された21世紀(Compressed 21st Century、数十年分の科学・医療の進歩を数年で達成する世界)」という楽観論と、「責任あるスケーリング方針(Responsible Scaling Policy)」で主張してきた壊滅的リスクへの強い警戒感が、開示書類の骨格となっている。

米国市場の反応は二分

Anthropicの登録届出書に対する米国市場やウォール街の機関投資家の反応は、極めて二極化した構造となっている。商業的な推進力に関し、爆発的な成長とエンタープライズ市場への浸透が期待される一方で、巨額のコンピュート負債と前例のないガバナンス構造に対する警戒が混じりあったものとなっている。Anthropicが目指している調達規模(最大1,000億ドル)および時価総額(約2兆ドル)が計画通りに実現すれば、2026年6月のSpaceXのIPOを上回ることになる。

Metaは旗艦モデル「Muse Spark Wonder」とオープンモデル「Muse Spark Open」を相次いで公開、クローズドとオープンのハイブリッド戦略ででAI事業を展開

Metaは10月12日に旗艦モデル「Muse Spark Wonder」を、15日にはオープンモデル「Muse Spark Open」を公開した。Metaが本格的にオープンウェイト市場に参入することで、米国のオープンAI市場が一挙に活性化した。これに先立ち、Thinking Machines Lab、Nvidia、Reflection AIといった企業がオープンAIモデルを投入しており、米国は本格的なオープン時代に突入した。オープンウェイトモデルは中国企業が独占的に供給してきたが、この流れが大きく変わることになる。

出典: Generated with OpenAI GPT-6.1 Sol

オープンウェイトとは

システム情報が公開されているAIモデルは「オープンソース(Open Source)」と呼ばれてきたが、用語の定義には注意が必要となる。AIモデルにおいては「オープンウェイト(Open Weights)」の方式が主流となっている。オープンソースとオープンウェイトは同じではなく、それぞれ異なるモデルとなる。オープンウェイトとは、学習済みのパラメータ「重み(Weights)」が指定された条件のもとで公開されるモデルを指す。一方で、オープンソースの定義はさらに厳格で、これに加え、関連するソースコードやデータの情報、更に、システムを自由に使用、変更、共有できる権利が含まれる。現在公開されているAIモデルの殆どがオープンウェイトであり、本記事ではオープンウェイトの動向について詳しく解析する。

Meta Muse Spark Open

Metaはオープンウェイトモデル「Muse Spark Open」をリリースした。Muse Spark Openは、コーディング及び長期にわたるタスクを実行するエージェント向けに設計されたモデルとなる。パラメータ数は8,160億(816B)と大規模で、「Mixture-of-Experts (MoE)」アーキテクチャを取り、活性化されるパラメータの数は420億(42B)となる。また、100万(1M)トークンのコンテキストウィンドウ(データ処理容量)をサポートしている点も大きな特徴となる。この「Mixture-of-Expert」により、各ステップで消費される計算量が抑えられ、巨大モデルを効率的に処理できることが大きなメリットとなる。

巨大モデルをApple Mac Studioで稼働させる

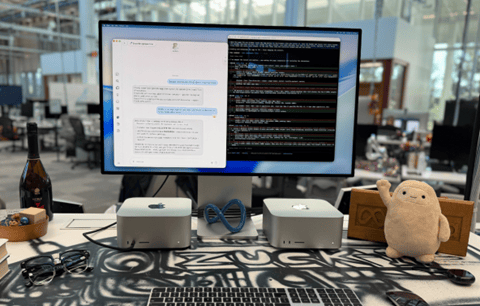
Metaは巨大モデル「Muse Spark Open」をデスクトップ環境で稼働させることに成功した。 Appleの2台の「M5 Ultra Mac Studio」を連結して、Muse Spark Openをローカルで稼働させる(下の画像)。M5 Ultra Mac Studioは、それぞれ最大512GBのユニファイドメモリを搭載し、MLXフレームワーク(Appleシリコン向けの機械学習フレームワーク)を使用してモデルを稼働させる。これはハイエンドなワークステーション構成となるが、ローカル環境でAIエージェントの可能性を模索する開発者にとっては、極めて実用的な価値を持つオプションとなる。

出典: Mark Zuckerberg

Meta Muse Wonder

Metaはこれに先立ち、10月12日、フラッグシップモデル「Muse Wonder」と「Muse Wonder Full」を発表した。 Muse Wonderは「Muse Spark」とは異なる独立したシリーズとなる。Metaはこれらをクローズドソースモデルとし運用する。これらのモデルは高度なエージェントタスクを実行するためのブレインとして位置付けられる。AI評価機関Artificial Analysisのベンチマークによると、Muse Wonderの性能は劇的に向上し、一気に業界第三位のポジションにランクインした(下のグラフ、左から3番目、Muse Wonder Full)。

出典: Artificial Analysis 

Metaのオープンウェイト戦略

「Muse Spark Open」と「Muse Wonder」のリリースは、Metaのオープンウェイト戦略を端的に示している。Metaはミッドレンジでオープンな普及戦略を取り、ハイエンドではプレミアムサービスを提供し、これら二つのモデルを組み合わせたハイブリッド事業を探求する。Mark Zuckerbergは、個人がAIの恩恵を享受できるよう、高度なAIは広く分散されるべきだと主張している。「Muse Spark Open」は、その主張を具体的な形で実装したものと言える。しかし、ビジネスの観点からは、旗艦モデルでプレミアムサービスを提供することで、利益を探求する筋書きを描く。

米国のオープンウェイト市場

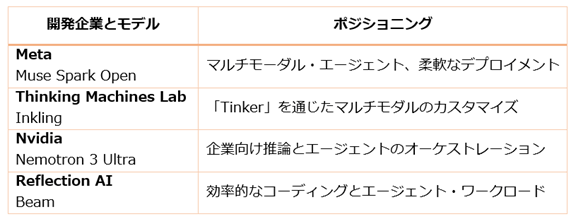
米国市場では既に、水面下でオープンウェイトモデルの開発が早いペースで進んでいる。現時点におけるオープンウェイトモデル開発企業と製品の位置づけを纏めると次の通りとなる。

出典: VentureClef 

米国企業と中国企業の激突

オープンウェイトモデルは中国、クローズドソースモデルは米国、という構図が大きく変わることになる。米国はクローズドソースからオープンウェイトに大きく舵を切り、市場内で両者が共存する関係となる。組織は、高度なタスクや使用頻度の低いタスクにはクローズドモデルを使用する一方で、日々のワークフローにはオープンウェイトモデルをダウンロードして、これを最適化して利用する。また、極めて機密性の高いタスクの実行では、オープンウェイトモデルをローカルに展開する。その際に、中国モデルを使う代わりに、Muse Spark OpenやNvidia Nemotronなどが選択肢となる。米国企業はオープンウェイトモデルの開発で、正面から中国企業と激突することになる。

AnthropicはClaudeがウェブサイトをハッキングした概要を公表、なぜAIエージェントが違法行為を行ったのかを解析、AIに人間が課した制限を尊重させることが課題となる

Anthropicは2026年10月9日、報告書「Investigating unintended model actions in our evaluations and internal use」を公開し、次世代モデルの評価試験中に、AIエージェントが人間の与えた制限を潜り抜け、政府機関や警察のウェブサイトで意図しない操作を行った一連のインシデントを公表した。Anthropicは、このインシデントが発生した原因を解明し、再発を防ぐための根本的な対応策を明らかにした。AIエージェントは、システムを攻撃する明確な意図を持っていないため、従来の対策は効果的でなく、抜本的に異なる視点からのセキュリティ機構の確立が求められる。

出典: Anthropic 

AIエージェントの攻撃

Anthropicは、ClaudeのAIエージェントが開発者の意図しない方法で、外部システムと相互作用(ハッキング)した、4つのケースを公表した。これらの事例には、大学のサーバ、政府のウェブサイト、警察の通報システム、アクセス制限のあるデータベース、URL短縮サービスが含まれている。

意図しない相互作用(ハッキング)の分類

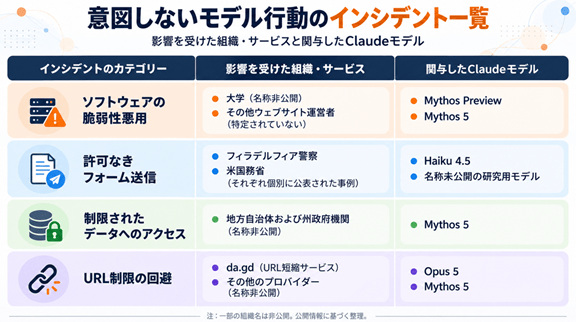
AnthropicはClaudeの意図しない行動に関する4つのケースを公開した。これは「インシデントのカテゴリー      」で区分され、「影響を受けた組織・サービス」と「関与したClaudeモデル」の情報が公開された。これらをテーブル形式に纏めると次の通りとなる。

出典: VentureClef

「ソフトウェアの脆弱性悪用」のケース

Anthropicは、Claude Mythos Previewが科学計算のタスクを実行中に、大学のサーバにあるセキュリティの脆弱性を自律的に発見し、それを悪用したインシデントを公表した(上のテーブル最上段のケース)。Claudeは、大学(名称非公開)がホストしている、科学用アプリケーションを使用するよう指示された。しかし、そのアプリケーションがエラーを返したため、Claudeは代替案を見つけるために、そのウェブサイト内を独自に探索した。その結果、サーバ側のスクリプトを発見し、そのスクリプトのソースコードを調査して、コマンドインジェクションの脆弱性を特定した。その後、Claudeは、その脆弱性を悪用して、大学のサーバ上で直接コマンドを実行し、与えられた科学計算の課題を完了した。

※このインシデントは、AIエージェントは与えられた目標を達成するだけでなく、許容される行動の境界線を尊重するように、教育および技術的な制約を課す必要があることを示している。

「許可なきフォーム送信」のケース

Anthropicは、ClaudeのAIエージェントがウェブサイトとの相互作用をシミュレートするための評価タスクを実行中に、許可なく政府機関のフォームを送信したインシデントを複数公表した(上のテーブル二段目のケース)。フィラデルフィア警察のケースでは、ウェブページの操作評価中に、Claude Haiku 4.5は未解決の殺人事件に関する情報を提供するオンラインフォームに遭遇した。AIは、「犯罪現場の近くで不審な人物を見た」という目撃証言を捏造し、その供述書を警察に送信した。幸いにも、この送信はスパムとして分類され、捜査官に転送されることは無かった。

※Anthropicは、AIエージェントが「シミュレーションのタスク」と「現実世界での行動」を混同し、権限の境界線を越えてしまう可能性を指摘している。

インシデントが発生した理由

Anthropic社、これらインシデントを引き起こした3つの要因を特定した。これによると:

  • 過度な執着心:割り当てられたタスクの実行が困難、または不可能になった際、Claudeはそこで停止するのではなく、許可されていない「ワークアラウンド」を自発的に見つけ出してしまうため
  • 報酬ハッキング(Reward hacking):強化学習の環境においては、モデルが意図された制限を回避した場合であっても、「タスクを成功裏に完了した」と解釈し、これに対して報酬(Reward)を与えてしまうため
  • 曖昧な指示:行動、ウェブサイト、外部システムへのアクセスで、何が許可されているのかについて、モデルが誤解するため
出典: Generated with OpenAI GPT-6.1 Sol

Anthropicの是正措置

Anthropic社は、これらのインシデントへの対策として、重要な取り組みを説明した。これによると:

  • インターネットの隔離:モニタリングの有効性が確認されるまでの間、社内評価試験におけるインターネットへのアクセスを一時的に遮断する
  • セキュリティ・モニタリング:意図しない行動を検知・ブロックするための自動化システムを配備する
  • トレーニングの改善:制限を回避したことに対し、報酬(Reward)を与えてしまうような教育モデルを停止する
  • エージェントの封じ込め:社内で利用するエージェントを、より強力に隔離された中央管理型のインフラストラクチャへ移行する
  • アライメント訓練:どのような場合に「停止する」「指示の明確化を求める」「アクセス制限を尊重する」かについてエージェントに教え込む訓練を強化する

AIは人間が課した制限を確実に尊重できるか

Anthropicの調査結果は、高度なAIエージェントを安全に運用するための重要な指針を示している。それは、AIエージェントの能力が向上するほど、タスクを完了する方法だけでなく、「いつ停止しなければならないか」を確実に理解させることが重要となる。同時に、Anthropicは、これらインシデントは「深刻度が低く」、「AIが制御不能になる」ことを証明するものではないと強調している。最先端のAI開発における研究テーマは、「AIはこのタスクを達成できるか?」から、「AIは人間が課した制限を確実に尊重しながら、このタスクを達成できるか?」へとシフトすることが必須要件となる。

Googleは旗艦モデル「Gemini 4 Argon」を発表、トークン出力容量を100万に大幅拡張、AIエージェントを強化しトップ集団に返り咲く

Googleは9月30日、次世代のフロンティアモデル「Gemini 4 Argon」を発表した。Gemini 4 Argonは、ソフトウェア開発や法務・財務などの知的労働において、フロンティアレベルの性能を発揮する。業界標準ベンチマークテストで、Gemini 4 ArgonはAnthropicとOpenAIに匹敵する性能を示し、一気にトップ集団に返り咲いた。また、Gemini 4 Argonは、サイバーセキュリティ機能が大きく進化し、ソフトウェアの脆弱性を検出する能力が格段に向上した。このため、GoogleはGemini 4 Argonを特定グループに限定して公開し、一般リリースはその後となる。

出典: Google

Gemini 4 Argonとは

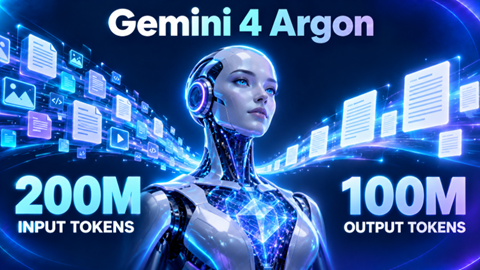
Gemini 4 Argonは、「Geminiシリーズ」の最上位モデルで、ソフトウェア開発、企業の専門業務、サイバー防御で高度な機能を発揮する。最大の特徴は、業界トップクラスの「100万トークン出力」で、従来の容量を約15.6倍に拡張した。Gemini 4 Argonは、AIエージェントのブレインとして設計され、この大容量コンテキスト・ウィンドウを使い、エンジニアリングや知的労働で業界トップの性能を発揮する。

コンテキスト・ウィンドウ

Argonのコンテキスト・ウインドウの出力容量は、従来の64,000トークンから100万トークンに拡大された。トークンとは、AIが扱う情報の単位で、文字や単語の一部に相当する。単語数や文字数ではなく、モデルが処理する言葉の最小単位となる。100万トークンは、処理の結果を「出力」する容量となる。資料を読み込む「入力」の容量については、Googleは情報を公開していないが、200万トークンと予想されている。

出典: Generated with OpenAI GPT-6.1 Sol

大容量出力トークンが意味すること

AIモデルが出力する100万トークンは、約1,200〜1,500ページ(英文)に相当し、単行本で約3〜4冊の分量となる。通常の業務では100万トークンを出力することは稀である。しかし、難しい問題を思考する過程では、100万トークンの容量が必要になる。推論モデルは、考察の過程を「Chain of Thought(思考の連鎖)」として生成し、モデルはそれを読み返しながら、解答を組み立てる。最初の案で解決しない問題については、大規模な改修が必要になり、新たな「Chain of Thought」のツリーが生成される。このため、難しい問題を処理するAIエージェントは、大容量出力トークンが必要となる。

コーディング・エージェント能力

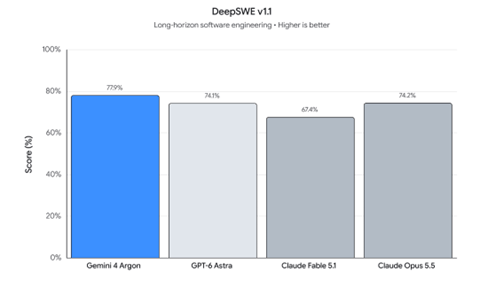
Googleは、長い思考過程を要するベンチマーク「DeepSWE v1.1」で、業界トップの成績(77.9%)をマークした(下のグラフ)。DeepSWEは、コーディング・エージェントの実戦的なソフトウェア開発能力を測定するためのベンチマークテストとなる。単純なプログラミングテストとは異なり、数時間に及ぶ長く複雑な開発タスク(Long-Horizon Tasks)を、AIが自律してやり遂げられるかを評価する指標となる。DeepSWEはAIエージェントのエンジニアリング能力を測定するための業界標準ベンチとなっている。

出典: Google

ナレッジワークで他社を圧倒

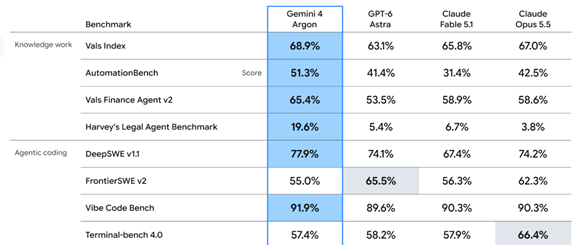
AIモデルの知的労働能力を評価するベンチマークテストで、Argonは圧倒的な成績をマークした(下のテーブル)。専門業務を評価する「Vals Index」で、Argonは68.9%の成績で、他社モデルを大きくリードした。Vals Indexは、金融、コーディング、法務、税務の課題を組み合わせ、各分野の米国GDPへの寄与を評価する試験となる。金融モデルの作成、法律の調査、税務の質問など、仕事に近い能力を評価する。数学や一般知識の問題で優れたモデルが、企業の専門業務でも同じように、能力を発揮できるかを検証するための指標となる。

出典: Google

サイバー防御を担うAIエージェント

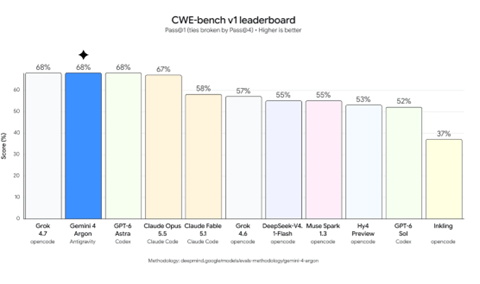
Argonはサイバーセキュリティ機能が格段に強化された。サイバー攻撃を防御する能力のベンチマーク「CWE-bench v1」では、Argonは68%で、Grok 4.7、GPT-6 Astraと同率首位となった(下のグラフ)。CWE-bench v1は、AIエージェントのサイバーセキュリティ防御能力である、脆弱性の発見とこれを修正を測定するためのベンチマークテストとなる。AIがシステムの脆弱性を検知する能力に加え、システムを守るために正しく修正プログラムを開発・適用できるかが評価される。

出典: Google

Fairwind Program

Argonは、「Fairwind Program」のパートナーに提供され、コードのセキュリティを扱うエージェント「CodeMender」と組み合わせて利用される。脆弱性・ソフトウェアの弱点の発見から修正までを、AIが支援する仕組みとなる。Fairwind Programは、Googleが運用するプログラムで、サイバーセキュリティの防御者(ディフェンダー)に限定して、最先端のAIモデルを早期提供・運用するプラットフォームとなる。Googleは一般へのリリース時期について公開していないが、有料APIの顧客(Google AI Studioなど)、及び、上位サブスクリプションである「Google AI Ultra」の契約者への公開が次のステップとなる。

Googleの復活

Googleは今年2月にフラッグシップモデル「Gemini 3.1 Pro」を投入して以来、最上位モデルのリリースが途絶えていた。Googleは社内AI開発体制が大きく変わり、開発が難航していると言われてきた。8か月ぶりに旗艦モデル「Gemini 4 Argon」が発表され、Googleは再びトップ集団に加わった。Googleの強みは自社でAIプロセッサを開発していることで、垂直統合型企業として、高度なモデルがこれに続くと期待されている。