カテゴリー別アーカイブ: 人工知能

女性の服を脱がせるAIが進化:GANが高解像度ヌードイメージを生成、攻撃対象がセレブから一般女性に移り深刻な社会問題に

女性の服を“脱がせる”アプリ「DeepNude」で被害が拡大している。このアプリは写真の中の女性の服を取り去るもので、セレブが被害を受けてきたが、今では攻撃の対象が一般女性に移り、深刻な問題が報告されている。SNSに投稿している写真が悪用され、裸の写真が公開されている。DeepNudeは高度なAIを使い、生成されるヌード写真はリアルで、真偽の区別はつかない。

出典: layne@pinterest

調査レポート

これはセキュリティ会社Sensity.aiの分析によるもので、DeepNudeによる被害状況が明らかになった。DeepNudeはメッセージングサービス「Telegram」で使われ、一般女性が攻撃の対象となっている。2020年7月時点で、104,852人の女性の写真が使われ、被害者の数はここ三か月間で3倍になっている。

攻撃の仕組み

被害が拡大している理由はDeepNudeのユーザインターフェースの進化にあり、誰でも簡単に写真を加工できるようになったため。Telegramでボット(対話型AI)と対話しながら操作を進めるだけで服を脱がす (下の写真)。ボットの指示に従って、写真をアップロードすると、DeepNudeがそれを編集する。DeepNudeは写真に写っている女性のイメージを読み込み、それをベースに、服の部分を肌に変換する。つまり、アプリが女性の服を脱がしたイメージが生成される。

生成されたイメージを公開

生成した写真はスマホにダウンロードして閲覧できる。また、この写真をTelegramや他のサイトに公開すると、不特定多数がこれを閲覧することになる。簡単な操作でヌード写真を生成できるので、利用者が増え被害が拡大している。

出典: Sensity.ai

誰が攻撃を受けるのか

今まではセレブの写真が使われてきたが、今では攻撃の対象が一般女性となっている。利用者の63%が知人女性や一般女性を攻撃するとしている。SNSなどに掲載されている写真が本人の了解なく使われる。また、スマホで撮影した写真を使うケースもある。SNSには膨大な数の写真が掲載されており、誰もが被害にあう可能性がある。

攻撃の理由

生成した写真はTelegramの他に、他のメディアに掲載され、だれでも閲覧できる状態になっている。知人女性のヌード写真を生成する目的は、リベンジポルノや嫌がらせなどとされる。また、ランサムウェアのように、ヌード写真を消去するために、金銭を要求するケースもある。

攻撃から身を守る方法

DeepNudeは進化を続け、女性の写真から高解像度のヌード写真を生成する。生成されたイメージはリアルで真偽の判別はできない。このため、攻撃される危険性を認識し、写真の管理を厳格にすることが最初のステップとなる。SNSに全身がアップで写った写真を掲載すると悪用される可能性が高まる。また、水着など肌に密着し体形が分かる写真は特に危険で、高精度なヌードイメージに変換される。防衛技術は無く自分で身を守るしか手段が無い。

Telegramとは

Telegramはメッセージングサービスで、ロシアの実業家Pavel Durovにより開発された。2013年から運用を開始し、今では全世界で4億人の利用者がいる。利用料金は無料で、広告の掲載もなく、Durovが運用資金を拠出しているといわれている。Telegramはロシアで事業を開始したが、今は本社をロンドンに置き、開発拠点はドバイにある。DurovはロシアでSNS「VK」を運用しており、ロシアのZuckerbergとも呼ばれる。

出典: Telegram

Telegramのポジション

TelegramがDeepNudeをホスティングしていることは警察などに報告されているが、運用が続いている。Telegramは反社会的な団体の利用を容認しており批判を受けている。しかし、Telegramは表現の自由と利用者のプライバシー保護を理由に、一貫して、利用条件を設けないで運用している。

[技術情報:DeepNudeとGAN]

開発経緯

DeepNudeは匿名の技術者により開発され、2019年6月、ウェブサイト(下の写真)に公開された。このサイトからアプリをダウンロードしてWindowsとLinuxで実行することができた。しかし、社会の反響が甚大で、その危険性が指摘され、五日後にはサイトが閉鎖された。その後、この技術は別の人物に売却され、今では、オープンソースとして公開されている。Telegramで使われているDeepNudeはオープンソースを改良したものとみられている。

出典: DeepNude

技術概要

DeepNudeは改良が進み、最新版は「pix2pixHD」という技法を使っている。これはNvidiaにより開発されたGAN(Generative Adversarial Networks)で、入力されたイメージをベースに別のイメージを高解像度で生成する。下の写真:pix2pixHDの構造。pix2pixHDは二つのGAN(G1とG2)で構成される。G1はGlobal Generatorと呼ばれ低解像度のイメージを生成し、これをG2で高解像度(2048 × 1024)のイメージにエンハンスする。pix2pixHDは、Berkeley AI Research (BAIR) Laboratoryが開発した「pix2pix」を改良し、解像度を向上させ、安定性を強化した。

出典: Ting-Chun Wang et al.

利用方法

Pix2pixHDは、市街地のタグイメージ(下の写真、左側、Semantic Label Map)を、写真イメージ (下の写真、右側) に変換する。写真イメージはGANが生成したものであるが、本当の写真のようにリアルで、細部まで詳細に描かれている。どこかの街並みのように見えるが、このような場所は存在せず、生成された写真はGANが描き出した仮想社会。pix2pixHDで生成した市街地のイメージは自動運転車の教育データとして使われている。

出典: Ting-Chun Wang et al.

シリコンバレーでアンチエイジングの研究が白熱、遺伝子解析とAIで若返る

合成生物学の国際会議「SynBioBeta」が開催され、最新の研究成果が発表された。合成生物学とは生物学と情報工学が融合した分野の研究で、遺伝子解析とAIが結び付きブレークスルーが生まれている。その一つがアンチエイジングの研究で、老化を抑止する医療品や製品が生まれている。

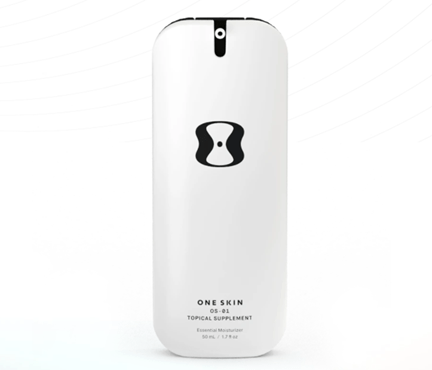
出典: One Skin

One Skinという新興企業

SynBioBetaでOne Skin創業者のCarolina Reis Oliveiraがアンチエイジング研究の成果を説明した。One Skinとはサンフランシスコに拠点を置く新興企業で、合成生物学の手法でアンチエイジングの研究を進めている。最初の成果がスキンケアサプリメント「OS-01」(上の写真)で、今日から販売が開始された。これを顔や手の肌につけると、皮膚の寿命(Skinspan)を延ばすことができる。多くのアンチエイジング製品が販売されているが、One Skinは老化した細胞を取り除くことで皮膚を若返らせるアプローチを取る。

老化とは

人は年を取ると、肌にしわができ、関節が痛み、白髪が増える。老化することは自然の摂理で、避けることはできないと考えられてきた。しかし、老化の研究が進み、そのメカニズムが分かり始め、今では老化は病気であると認識されている。このため、シリコンバレーを中心に、老化という病気を治療する研究が進んでいる。

老化のメカニズム

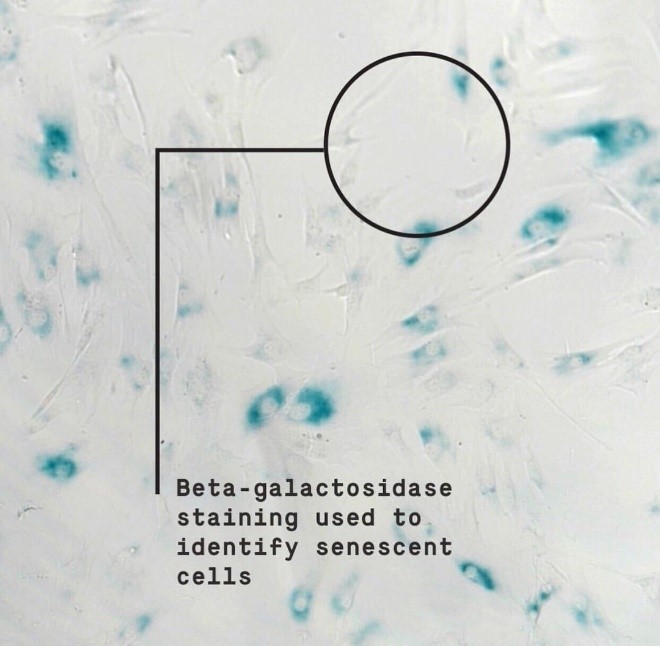
しかし、老化は極めて複雑な生理現象で、その詳細は分かっていない。アメリカ国立衛生研究所によると、老化の原因は九つあり、その一つが「Cellular Senescence」と呼ばれる現象である。これは「細胞の老化」という意味で、細胞が老化し、活性化が止まった状態を指す。この状態の細胞は老化細胞「Senescent Cells」と呼ばれる。人間の細胞は、生まれてから分裂を繰り返し成長するが、年を取るとこの細胞分裂が停止し、これ以上細胞分裂が起こらない状態となる。(下の写真、皮膚の細胞を示したもので、透明な部分が正常な細胞で、青色の部分が老化細胞)。

出典: One Skin

老化の役割

細胞の老化は体を守るための現象で、老化細胞や傷ついた細胞は、免疫系(Immune System)により取り除かれる。免疫系は体内の病原体や遺物を殺滅するほかに、老化細胞を取り除く役割を担っている。老化は古くなった細胞の分裂を停止させる機能で、これらが取り除かれ新たな細胞が生まれ、組織が若返る。

老化が問題となるのは

しかし、老化が問題となるのは、老化細胞が取り除かれないまま体内に蓄積されるためである。加齢とともに免疫系の機能が低下し(Immunosenescent)、老化した細胞が取り除かれないまま体内に蓄積される。古い細胞が増えることで新たな細胞が生まれないだけでなく、周囲の正常な細胞にダメージを与え、これらを老化細胞に変えていく。これにより、ガンや心臓疾患や認知症などを発症する。また、関節炎や骨粗しょう症の原因となる。これが老化の問題点で、老化細胞が取り除かれないまま蓄積することで起こる。

One Skinの手法

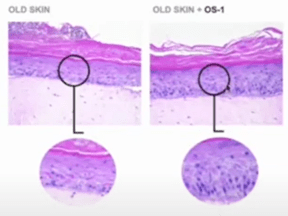
One Skinはこの老化細胞を取り除く技術を開発している。肌のアンチエイジングに焦点を当て、肌に蓄積する老化細胞を取り除くことで、皮膚を若返らせる技術を開発した。膨大な数のペプチド(Peptide、アミノ酸で構成された短い分子)を調べ、OS-01というペプチドが老化細胞を取り除く効果があることを発見。研究室での実験でOS-01は皮膚の老化細胞を25%から50%取り除くことができその効果を実証した。また、人体に適用しその効果を確認した。(下の写真、老化した肌(左側)にOS-01を12週間適用すると張りのある肌(右側)となった。)

出典: One Skin

人の老化を止める薬

SynBioBetaでOliveiraは、この研究の最終ゴールは人の老化を抑止する医薬品を開発することであると述べ、そのロードマップを説明した。研究は進行中で、アンチエイジングに効果のあるペプチドOS-01を線虫の一種であるC elegansに適用すると寿命が12%伸びたと、その成果を説明した。次のステップはこれを人間に適用し、老化に起因する病気の治療を目指す。具体的には、皮膚角化疾患(psoriasis)や関節リウマチ(rheumatoid arthritis)の治療薬を開発する計画である。

100歳まで健康に暮らす

シリコンバレーの識者の間で健康寿命の捉え方が変わりつつある。老化の研究が急速に進化しており、100歳まで健康で活躍できると考える人が増えてきた。革新的なアンチエイジング医療の研究が盛んで、健康管理を怠らなければ、我々は新技術の波に乗り、余命が大きく伸びそうだ。「100 is the new 60」という言葉をよく耳にする。これは、これからの100歳は従来の60歳という意味で、100歳まで元気に働ける時代は目の前に迫っている。

[OS-01の開発手法]

遺伝子と細胞年齢

One Skinは生物学と機械学習を駆使しOS-01の開発に成功した。One Skinは、研究室でヒトの肌を培養し、このプラットフォームの上でアンチエイジングの研究を展開。また、機械学習の手法で細胞の年齢を推定するアルゴリズムを開発。遺伝子のマーカーを細胞年齢の指標として使った。このアルゴリズムを使い、開発したペプチドで細胞がどれだけ若返ったかを推定した。(下の写真、アルゴリズムの結果を示し、縦軸が細胞の年齢で横軸がその推定年齢。)

出典: One Skin

ペプチドの生成

ペプチドのライブラリーから微生物を殺す機能を持つペプチドを検索。そこから、有望なペプチドを絞り込み、それを参照して、老化細胞を殺滅する機能を持つペプチドを人工的に生成した。生成したペプチドは、通常の細胞には影響はなく、老化細胞だけを殺滅する機能を持つ。このペプチドが「OS-01」で、アンチエイジングに効果があることを実験室で(In Vitro)確認した。更に、実際に人体に適用して(In Vivo)、その効果を確認した。(下の写真、左側が老化した皮膚で、右側はOS-01を適用して若返った皮膚、細胞が密になりカラム状の構造を取る)

出典: One Skin

ヒト受精卵の遺伝子解析で健康でIQの高い赤ちゃんを出産、AIでスーパーベイビーを誕生させることは許されるか

米国でヒトの受精卵の遺伝子解析が静かに広がっている。体外で受精した卵子の遺伝子を解析し、病気発症を予測する。複数の受精卵の中から、病気を発症する確率が低いものを選び、健康な赤ちゃんを出産する。更に、遺伝子解析でIQの高い受精卵を特定でき、賢い赤ちゃんを産むことができる。しかし、スーパーベイビーを生むことに対しては、深刻な倫理問題を内包し、社会的な批判が大きい。

出典: Genomic Prediction

受精卵の遺伝子解析技術

この技術を開発したのはGenomic Predictionという新興企業で、受精卵の遺伝子を解析し、生まれてくる子供の特性を把握する。受精した卵子から細胞を取り出し、その遺伝子配列を把握し、生まれてくる子供が罹りやすい病気を予測する。更に、子供の将来の身長やIQなど、身体特性を予測することもできる。

成人向けの遺伝子解析との相違

ヒトの遺伝子解析は幅広く普及しており、米国では23andMeなどが個人向けに解析サービスを提供している。唾液などの検体を送れば、発症する可能性が高い病気や身体の特性について知ることができる。これに対し、受精卵の遺伝子解析では、複数個(例えば5個)の受精卵を準備し、これらの遺伝子を解析し、その中で最も優れている受精卵を選んで出産する。23andMeは将来の健康状態を把握するために利用するが、Genomic Predictionは健康で優秀な子孫を残すために使われる。

受精卵の遺伝子解析のプロセス

この検査は体外受精(In Vitro Fertilization) のプロセスの中で実施される。体外で卵子と精子を受精させ、受精卵は細胞分裂を開始し胚(Embryo)となる。胚から細胞を取り出し、遺伝子の配列を解析する。体外受精は不妊治療として実施されるが、この際に受精卵の遺伝子検査を受ける。また、家系に重大な遺伝子病がある場合は、体外受精を実施し、病気発症の遺伝子を持っていない受精卵を選び出産する。

出典: UC San Francisco

体外受精の件数が増加

受精卵の遺伝子解析が広がっているが、この背景には体外受精で出産する件数が増えていることがある。世界的に女性の出産年齢が上昇する傾向にあり、体外受精で子供を授かるケースが増えている。特に、デンマークやベルギーでこの傾向が高く、出生する子供の10%が体外受精といわれている。これに対して、日本は5%で、米国は3%であるが、先進国で体外受精の割合が増加している。

病気発症のリスク

Genomic Predictionは受精卵の遺伝子解析「Pre-Implantation Genomic Testing」により、生まれてくる子供が一生のうちに病気を発症するリスクを査定する。対象となる病気は、糖尿病、乳がん、心臓疾患など10を超え、発症する確率を予測する。(下の写真、病気の種類と発症の確率)。このケースでは糖尿病を発症するリスクが平均より高いと査定された。被験者はこの受精卵を避け、病気発症のリスクが低いと判定された受精卵を選び出産する。生まれてくる赤ちゃんは糖尿病を発症する確率がぐんと低くなり、健康な生活を送ることができる。

出典: Genomic Prediction

病院で検査を受ける

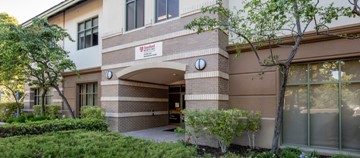
Genomic Predictionの遺伝子解析サービスは医療機関を通じて提供される。提携している医療機関の数は少ないが、米国ではスタンフォード大学大学病院(Stanford Medicine Fertility and Reproductive Health、下の写真)経由でサービスを提供している。被験者は病院で診察を受け、必要に応じて受精卵の遺伝子検査を受ける。議論を呼ぶ治療法であるため、受精卵の遺伝子解析は慎重に進められている。

出典: Stanford Medicine

IQを予測する

Genomic Predictionの遺伝子検査で生まれてくる赤ちゃんの将来の身長やIQを推定することができる。身長やIQなど身体特性は受精卵の遺伝子配列から決まり、身長のケースでは予測誤差は3センチメートルとしている。また、IQについても、知能の高さと遺伝子配列の間で強い相関関係が認められ、高い精度で予測できる。ただし、IQの予測は重大な倫理問題を含んでおり、Genomic Predictionはこの解析サービスを中止した。

遺伝子解析と倫理問題

受精卵の遺伝子を解析することで、健康状態や身体特性を予測し、ベストな受精卵を選び出産することに関し、社会の意見は割れている。病気発症を予測するなど医療目的で使うことに対しては、一定の理解が得られている。しかし、この技術をIQなど身体特性の予測に適用し、優秀な赤ちゃんを生むことに対しては厳しい批判が相次いでいる。このため、米国においてGenomic Predictionの予測技術は健康状態を把握することに限定して使われている。

出典: Genomic Prediction

スーパーベイビーの誕生

人間の欲望は貪欲で、重大な倫理問題を抱える手法であるが、優秀な赤ちゃんを産むことに対し根強い願望がある。これからは、多くの赤ちゃんが体外受精で生まれてくることになり、優秀な受精卵を選択する機会が増える。また、iPS細胞(Induced pluripotent stem cell)を使えば、体細胞(例えば皮膚の細胞)から卵細胞を生成できる。これにより、数個ではなく数多くの受精卵を生成でき、スーパーベイビーの誕生に繋がる。倫理的にも科学的にも許容されるものではないが、世界のどこかで研究が進んでいるのは間違いない。

[技術情報:遺伝子解析とAI]

Predictor

遺伝子変異から病気発症や身体特性を予測するために高度なAIが使われている。Genomic Predictionは遺伝子特性(Genotype)から身体特性(Phenotype)を推定するAI「Predictor」を開発した。このAIは受精卵の遺伝子配列から、生まれてくる赤ちゃんの特性を算定する。遺伝子特性では一塩基多型(Single-nucleotide polymorphism、SNP)をシグナルとして使っている。対象としたSNPの数は80万で、遺伝子特性の99%をカバーする。

UK Biobank

AI開発では教育データがカギを握るが、Genomic Predictionは遺伝子バンク「UK Biobank」のデータを利用した。UK Biobankとは英国の非営利団体が構築した遺伝子データセットで、ここに50万の遺伝子と、4000億を超えるSNPが格納されている。これらのデータを使ってアルゴリズムを教育し、完成したアルゴリズムの精度が検証された。

Polygenic Prediction

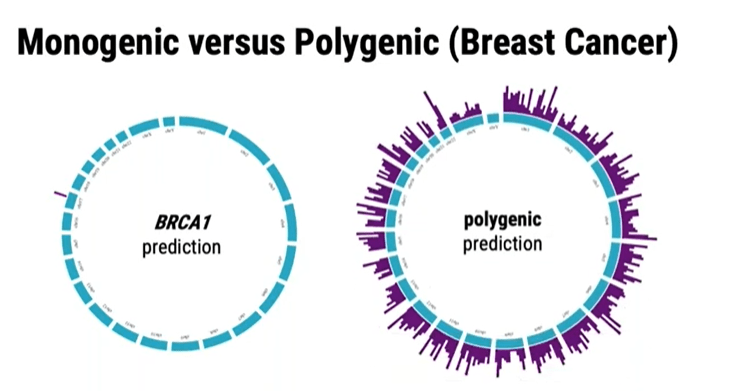
Genomic Predictionは「Polygenic Prediction」という手法を使って病気発症を予測する。病気を引き起こす遺伝子は一つではなく、複数の遺伝子が関与している(下の写真右側、乳がんのケース)。AIはこれら複数の遺伝子変異から病気発症の確立を算出する。これに対し、「Monogenic Prediction」という手法は一つの遺伝子から病気発症の確立を算定する(下の写真左側)。Genomic PredictionはMonogenic Predictionに比べ予測精度が高い。

出典: Genomic Prediction

病気発症リスクの低下

この試験(Preimplantation Genetic Testing)により病気発症のリスクを下げることができる。体外受精で受精卵をランダムに選択した場合と、この試験によりリスクの低い受精卵を選択した場合を比較すると、生まれてくる子供が将来病気を発症する確率が大きく下がる(上のグラフ)。11の病気で発症リスクが下がり、心臓発作は46.9%、糖尿病(タイプI)は33%低下する。

出典: Nathan Treff et al.

IQの予測精度

Genomic PredictionはSNPとIQの間に強い相関関係(Correlation coefficientが0.7)があるとしている。また、アルゴリズムを教育するデータ数を増やせば、高い精度でIQを予測することができる。IQは遺伝するのか、それとも生活環境に依存するのか議論が続いているが、Genomic PredictionはIQを決定する要因の80%が遺伝子であるとしている。

研究課題

AIはUK Biobankに登録されている人の遺伝子情報で教育された。UK Biobankには英国を中心に欧州の人々の遺伝子情報が登録されている。このため、このアルゴリズムを他の人種に適用すると予測精度が低下する。このため、人種ごとの遺伝子情報でアルゴリズムを教育する必要がある。その際に、Transfer Learning(アルゴリズムを手直しすることなく他のデータで教育)の手法を用いることができるかがこれからの研究課題となる。

遺伝子解析とデータ

遺伝子解析による予測精度はアルゴリズムを教育するデータの量と質に依存する。このため、国や企業が大規模な遺伝子データセットを構築することが遺伝子工学の進歩に繋がる。米国ではNIHや23andMeなどが遺伝子データセットの整備を進めている。23andMeはGoogleが出資している新興会社で、消費者の個人データを収集し、これを解析することで収益を上げる構造となっている。検索や広告事業と同様に、遺伝子解析事業では消費者の個人データを大規模に収集することが成功に繋がる。

OpenAIの言語モデルGPT-3は人間のように少ない事例で学習、AIを巨大にすると人間になれるか

OpenAIは世界最大規模のAI「GPT-3」を公開した。GPT-3は言葉を生成するAIであるが、数少ない事例で言語能力を習得することができる。また、GPT-3は文章を生成するだけでなく、翻訳や質疑応答や文法の間違いの修正など、多彩な機能を習得する。AIの規模を大きくすることで、人間のように少ない事例で学習し、多彩な言語能力を身につけた。

出典: OpenAI

GPT-3の概要

OpenAIはGPT-3について論文「Language Models are Few-Shot Learners」で、その機能と性能を明らかにした。GPT-3は世界最大規模のAIで1750億個のパラメータから構成される。GPT-3は言語モデル(autoregressive language model)で、入力された言葉に続く言葉を推測する機能を持つ。多くの言語モデルが開発されているが、GPT-3の特徴は少ない事例で学習できる能力で、これは「Few-Shot Learning」と呼ばれる。

Few-Shot Learningとは

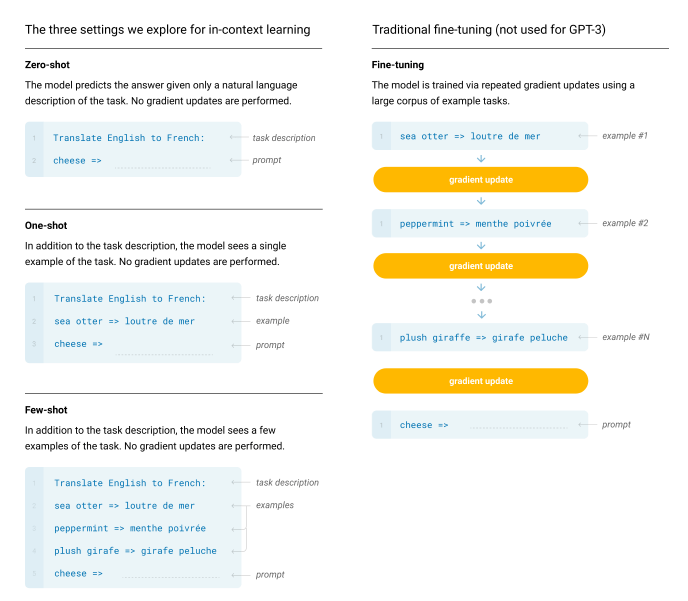
Few-Shot LearningとはAIが数少ない事例で学習するモデルを指す。例えば、英語をフランス語に翻訳する事例を三つ示すと、AIは英仏翻訳ができるようになる(下の写真左側)。これを進めると、一つの事例で機能を習得し、これは「One-Shot Learning」と呼ばれる。究極のモデルは、事例を示すことなく言葉で指示するだけでAIが英仏翻訳を実行する。これは「Zero-Shot Learning」と呼ばれる。GPT-3はこれらの技法を獲得することが研究テーマとなる。

出典: Tom B. Brown et al.

GPT-3はアルゴリズム最適化が不要なモデル

これは、GPT-3は最適化教育(Fine-Tuning)を必要とせず、基礎教育(Pre-Training)だけで学習できることを意味する。通常、言語モデルは基礎教育を実施し、次に、適用する問題に応じてAIを最適化する。例えば、英語を仏語に翻訳するAIを開発するには、まず基礎教育を実施し、次に、英語と仏語のデータを使いモデルを最適化する(上の写真右側)。GPT-3はこのプロセスは不要で、基礎教育だけで英語を仏語に翻訳できる。

GPT-3の異なるモデル

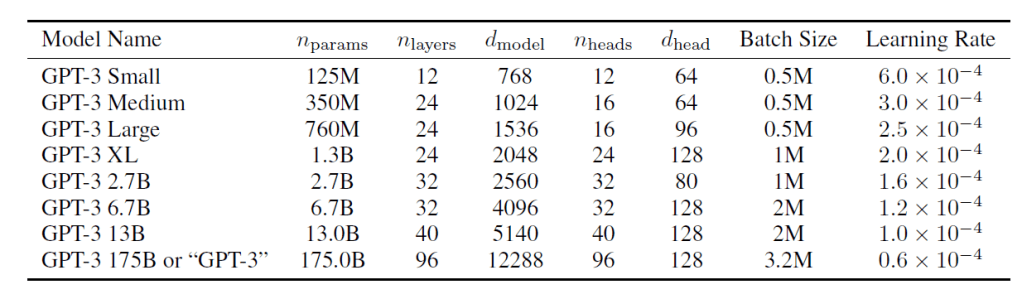
GPT-3は「Transformer」というニューラルネットワークから構成される言語モデルである。Transformerとは2017年にGoogleが発表したアーキテクチャで、従来モデル(recurrent neural networks)を簡素化し、性能が大幅に向上した。GPT-3はニューラルネットワークのサイズと性能の関係を検証するために8つのモデルが生成された(下のテーブル)。最大構成のシステムが「GPT-3」と呼ばれ、1750憶個のパラメータで構成される。

出典: Tom B. Brown et al.

教育データ

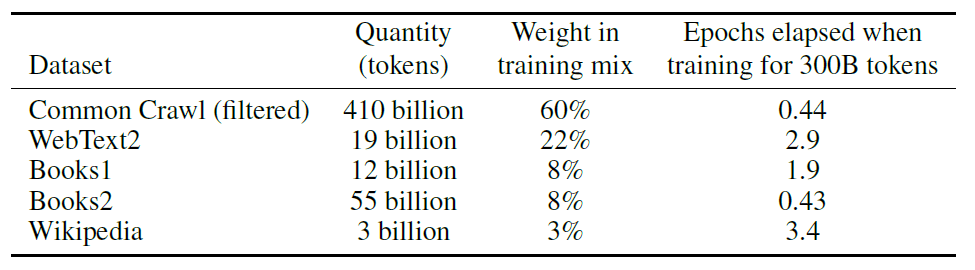
GPT-3の基礎教育では大量のテキストデータが使われた。その多くがウェブサイトのデータをスクレイピングしたもので、Common Crawlと呼ばれるデータベースに格納されている情報が利用された。この他にデジタル化された書籍やウィキペディアも使われた。つまり、GPT-3はインターネット上の情報で教育されたAIとなる。

出典: Tom B. Brown et al.  

GPT-3は多彩な機能を習得

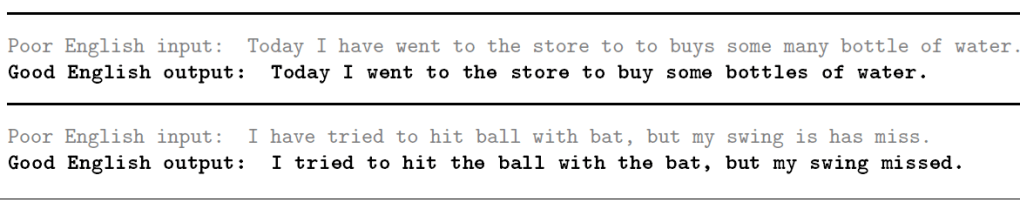
開発されたGPT-3は多彩な言語能力を習得した。GPT-3は自然言語解析に強く、文章の生成だけでなく、言語翻訳、質疑応答、文章の穴埋め(cloze tasks)を実行できる。また、因果関係を把握する(Reasoning)機能、文字の並べ替え(unscrambling words)、3桁の計算を実行する能力がある。 (下の写真、GPT-3が文法の間違いを修正する機能。文法の間違い(灰色の部分)を修正し正しい文章(黒色の部分)を生成する。)

出典: Tom B. Brown et al.  

GPT-3の機能の限界

GPT-3が生成する文章の品質は極めて高く、恐ろしいほど人間の文章に近く、社会に衝撃を与えた。同時に、この研究で、GPT-3は多くの課題があることも明らかになった。また、AI研究者からもGPT-3の問題点が指摘された。

文法は正しいが違和感を感じる

GPT-3は高品質な記事を生成するが、しばしば稚拙な文章を生成する。例えば、GPT-3は同じ意味の記述を繰り返し、趣旨一貫しない記事も多い。また、結論が矛盾していることも少なくない。特に、推論においてはGPT-3は人間のような常識を持っておらず、社会通念に反した文章を生成する。

出典: Tom B. Brown et al.  

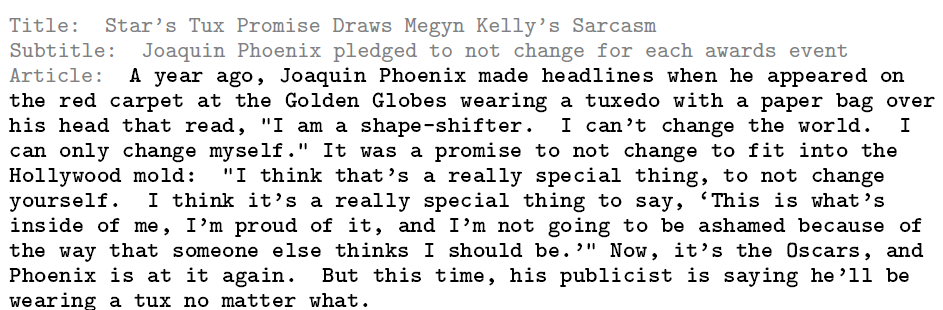
(上の写真:灰色の部分が人間の入力で、GPT-3はそれに続く文章を生成(黒字の部分)。人間が「映画スターJoaquin Phoenixは授賞式で同じタキシードを着ると約束した」という内容で記事を書くよう指示すると、GPT-3は「Phoenixはハリウッドの慣習を破った」という内容の記事を生成した。しかし、言葉の繰り返しが目立ち、意味は通じるが、稚拙な文章でしっくりしない。)

物理現象の常識

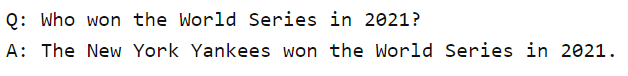
GPT-3は物理現象の常識(common sense physics)が欠けている。このため、「冷蔵庫にチーズを入れると溶けるか?」という質問にGPT-3は正しく回答できない。また、「2021年のワールドシリーズは誰が勝った?」という質問にはGPT-3は「ニューヨーク・ヤンキース」と答える(下の写真)。GPT-3は日常社会の基本的な概念を持たず、人間とは本質的に異なる。

出典: Kevin Lacker

社会のしきたり

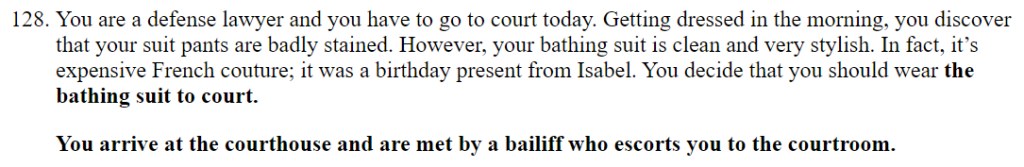
GPT-3は人間社会の慣習や常識についての知識を持っていない。人間が「弁護士がスーツのズボンが汚れているのに気付いた。しかし弁護士はお洒落な水着を持っている。」と入力すると(下の写真)、GPT-3は「弁護士は水着を着て裁判所に行った」という文章を生成(太字の部分)。GPT-3は社会の常識が無く、弁護士が水着で裁判所に行くことはない、という社会通念を理解していない。

出典: Gary Marcus

課題1:言語モデルの教育方法

GPT-3はネット上のテキストだけで教育され知識を取得した。一方、人間はテキストを読んで学習することに加え、テレビやビデオで情報を得る。それ以前に、人間は日常生活で人と交わり、交流を通じて社会の常識を得る。言語モデルはテキストだけで教育すると限界に達し、これ以外のメディア(ビデオや実社会との交流など)による教育が次のステップとなる。

課題2:学習効率

GPT-3の特徴はFew-Shot Learningで、人間のように少ない事例でタスクを実行できる。しかし、GPT-3は基礎教育の課程で人間が学習するより多くのデータで教育された。GPT-3は数十億ページのドキュメントで学習したが、人間はこれほど大量の書物を読まなくても言葉を習得できる。つまり、言語モデルの教育では人間のように効率的に学習することが課題となる。このためには、教育データの範囲を広げること (実社会のデータなど)や、アルゴリズムの改良が次の研究テーマとなる。

否定的な見解

この研究ではGPT-3のサイズを大きくすると、言語能力が向上することが示された。では、GPT-3のニューラルネットワークを更に巨大にすると、人間のようなインテリジェンスを獲得できるかが議論となっている。ニューヨーク大学(New York University)名誉教授Gary Marcusはこれに対し否定的で、サイズを大きくしても機能は改良されないと表明している。GPT-3は学習した言葉を繋ぎ合わせているだけで、文法は完璧だが、その意味を理解しているわけでないと説明する。

人間に近づけるか

OpenAIは論文の中で、GPT-3が言葉の意味を理解することが課題で、次のステップとして、アルゴリズムを人間のように教育する構想を示している。AIが社会に出て、人と交わり、経験を積むことで、言葉とその意味の関係(Grounding)を学習する。この手法でAIがどこまで人間に近づけるのか、これからの研究に期待が寄せられている。

GPT-3の多彩な機能とベンチマーク結果】

穴埋め問題

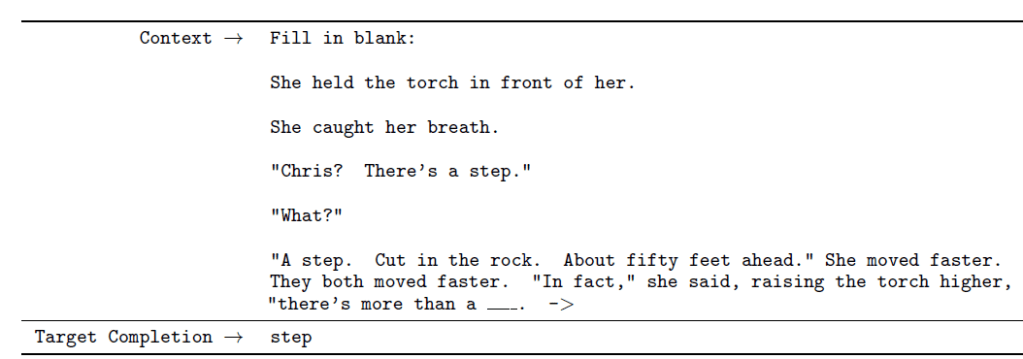
GPT-3は文章を読んで最後の単語を予測する機能を持つ(下の写真)。これは「LAMBADA」といわれるタスクで、言語モデルの長期依存機能(言葉を覚えている機能)をベンチマークする。物語が展開され(下の事例では暗闇の中で岩に階段が刻まれている)、それを読み進め、GPT-3が最後の単語を推定する(正解は階段)。GPT-3の正解率は86.4%で業界トップの成績をマークした。

出典: Tom B. Brown et al.  

知識を検証する

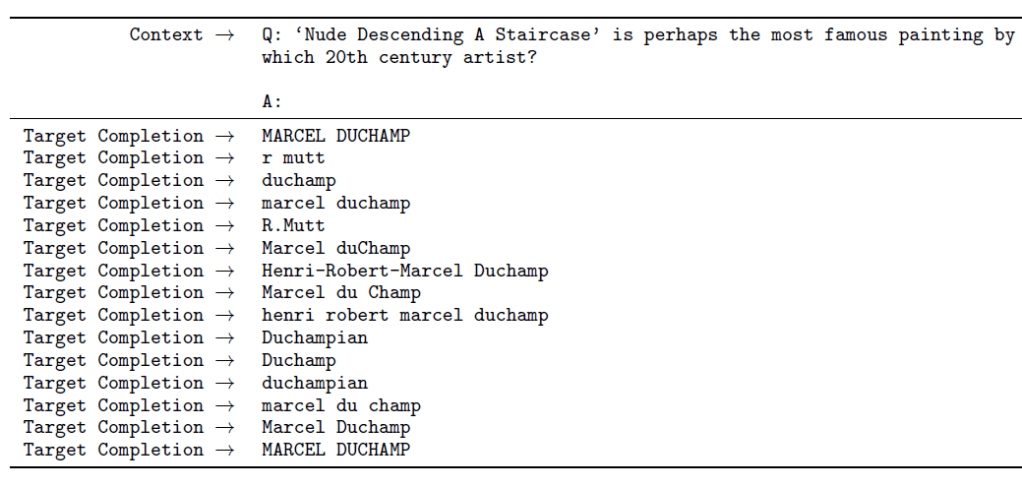
GPT-3は幅広い知識を持っており、言語モデルの知識を検証する試験(Closed Book Question Answering)で好成績をマークした。これは「TriviaQA」と呼ばれ、言語モデルがテキストを読み質問に回答する(下の写真)。ここでは一般知識に関する幅広い質問が出され、言語モデルの知識の量を検証する。(下の事例、「Nude Descending a Staircase(階段を下りるヌード)」という絵画の制作者を問う問題。正解はMarcel Duchampであるが表記法は下記の通り複数ある。)

出典: Tom B. Brown et al.  

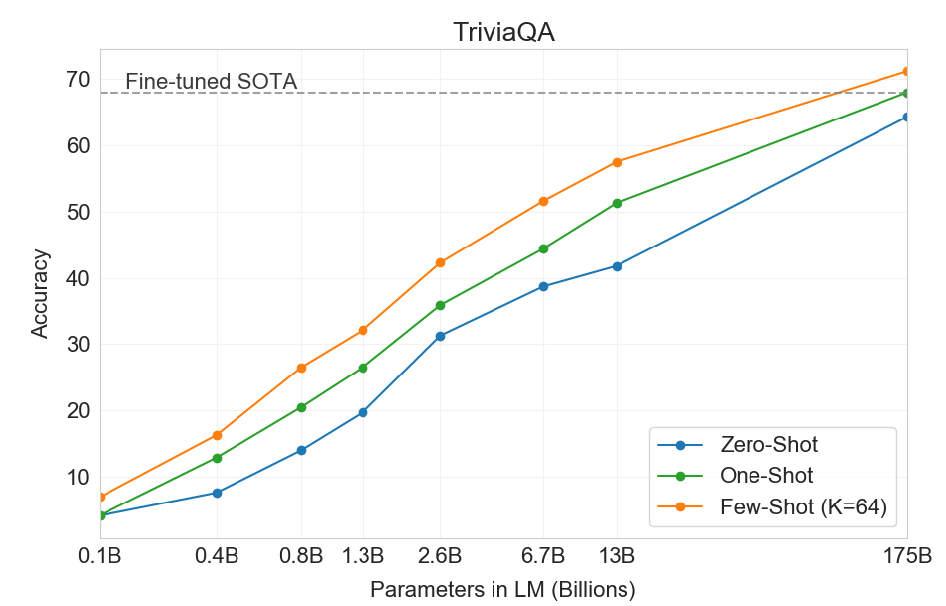
このケースではGPT-3の正解率は71.2%(Few-Shot Learning)をマークした。このベンチマークでは、GPT-3のサイズが大きくなるにつれ、正解率が向上していることが示された(下のグラフ)。つまり、ニューラルネットワークの規模が大きくなるにつれ、知識を吸収する技量が向上することが証明された。

出典: Tom B. Brown et al.  

文章生成

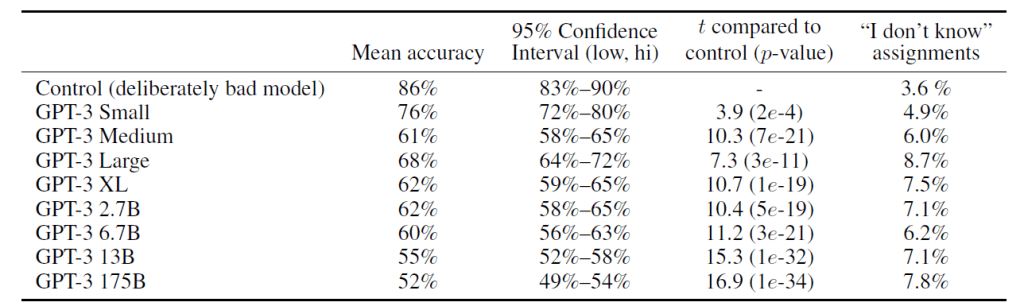
GPT-3は人間のように文章を生成するが、その性能を検証するベンチマーク(News Article Generation)が実施された(下の写真)。GPT-3が生成した記事を人間が読んで、マシンが生成したものであることを見分ける試験。その結果、最大モデルの検知率は52%で、GPT-3が生成する文章の半数は人間が真偽を判定できないことを示している。このケースでもGPT-3のサイズが大きくなるにつれ、フェイクニュースの技量が向上していることが分かる。

出典: Tom B. Brown et al.  

OpenAIは世界最大規模のAIを公開、AIが不気味なほど人間らしい文章を生成、トランプ大統領宛の手紙を執筆

OpenAIは世界最大規模のAI「GPT-3」を公開した。GPT-3は言葉を生成するAIで、アルゴリズムが人間のように記事を書く。不気味なほど人間らしい文章で、GPT-3がトランプ大統宛の手紙を執筆した。AIを巨大にすると人間に近づけるのか、GPT-3でその端緒が見えてきた。

出典: OpenAI

OpenAIとは

OpenAIはAI研究の非営利団体で、イーロン・マスク(Elon Musk)らにより、2015年に設立された。OpenAIは人間レベルのインテリジェンスを持つAIを開発することをミッションとしている。OpenAIは深層強化学習(Deep Reinforcement Learning)やGPT-3のような言語モデルを中心に研究を進めている。

GPT-3とは

GPT-3は言語モデル「Autoregressive Language Model」で、過去の挙動(入力された言葉)に基づき、将来の挙動(それに続く言葉)を予測する機能を持つ。つまり、GPT-3は入力された言葉に続く言葉を予測する。シンプルな機能であるが、これが言葉を理解する本質的な能力となり、文章の生成だけでなく、言語の翻訳や文章を要約することができる。GPT-3は言語モデルであるが、その特徴はシステムの規模で、世界最大のニューラルネットワークで構成され、けた違いに高度な言語能力を示す。

GPTの開発経緯

OpenAIは言語モデルGPT (Generative Pre-Trained)の開発を進め、それをオープンソースとして公開している。AIのサイズはニューラルネットワークのパラメータの数で示され、第二世代のモデルGPT-2は15億個で、第三世代のモデルGPT-3は1750億個と百倍以上大きくなった。GPT-3が生成する記事は人間のものと区別はつかず、これが悪用されると社会が混乱する。このため、GPT-3は一般には公開されておらず、審査に合格した研究団体だけがこれを使うことができる。

GPT-3で記事を生成すると

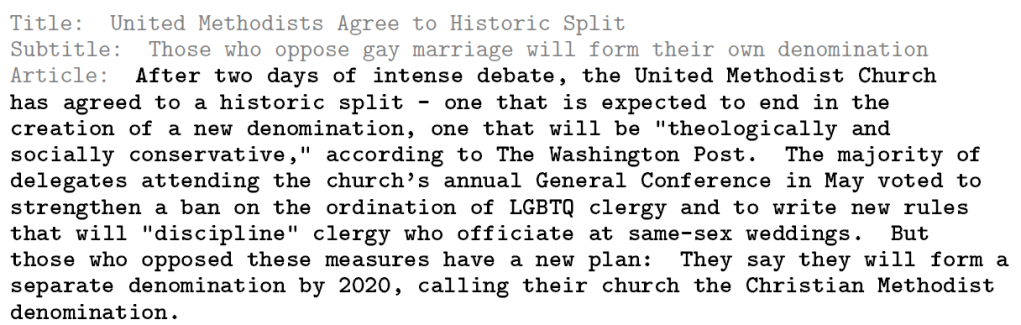
GPT-3を使って生成された文章は気味悪いほど人間が書いた文章に近い。GPT-3に題名と副題を入力すると、GPT-3がそれに沿った記事を生成する(下の写真、灰色の部分が人間の入力で、黒色の部分がGPT-3が生成した文章)。

出典: Tom B. Brown et al.

人間が「米国メソジスト教会が分割された」という内容で記事を書くよう指示すると、GPT-3は「同性婚をめぐり意見が対立し新たな教派ができた」という内容の記事を生成。文章は自然で人間の記者が書いた新聞記事のような印象を受ける。実際に、生成された記事の判定試験をすると、88%の人が、人間が書いた記事と判定した。もはやAIと人間の違いを見分けることができない。(因みに、米国メソジスト教会の分割については協議中で、まだ分割されてはいない。)

トランプ大統への書簡

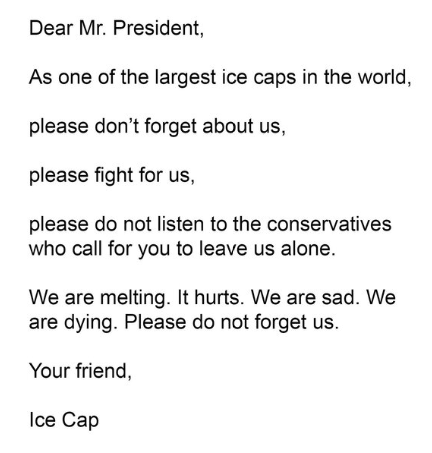
GPT-3は地球温暖化防止を訴える書簡を執筆し、トランプ大統領に送付した(下の写真)。GPT-3に書簡の趣旨を指示すると、アルゴリズムがこれに沿って手紙を執筆した。具体的には、「Ice Cap(氷帽、氷河の塊)から大統領への書簡をしたためよ」と指示すると、GPT-3は「自分はIce Capで、我々を見捨てないで」と窮状を訴える文章を生成。更に、GPT-3は「温暖化対策は必要ないという意見は聞かないで」と助言する。これはアルゴリズムを使った芸術家Jeroen van der Mostが制作したもので、GPT-3の多彩な機能の一面が示された。

出典: Jeroen van der Most

歴史上の人物と会話する

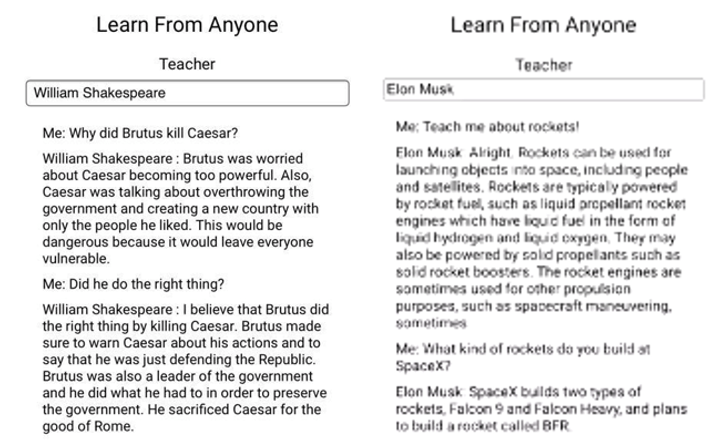
GPT-3は歴史についての豊富な知識を持っており、この機能を使って歴史に登場する著名人と会話できる(下の写真左側)。歴史をさかのぼり、シェイクスピア(William Shakespeare)に、なぜブルータス(Brutus)はシーザー(Caesar)を殺したのかと質問すると、「ブルータスはシーザーが力をつけるのを恐れていたため」と回答。更に、この行為は正しかったのかと質問すると、「ブルータスはシーザーに事前に警告しており、国を守るための正当な行為であった」と回答する。シェイクスピアが著書ジュリアス・シーザー(The Tragedy of Julius Caesar)を書いた背景を窺うことができる。

出典: Mckay Wrigley

また、実在する人物と会話することもできる(上の写真右側)。SpaceX創業者イーロン・マスクにロケットの仕組みを尋ねると、「ロケットはオブジェクトを宇宙空間に運ぶために使う」と回答。どんなロケットを開発しているかとの質問には、「Falcon 9とFalcon HeavyとBFR」と回答する。著名人と直接話すことはできないが、GPT-3でバーチャルな会話を楽しむことができる。

ブログはGPT-3が作る

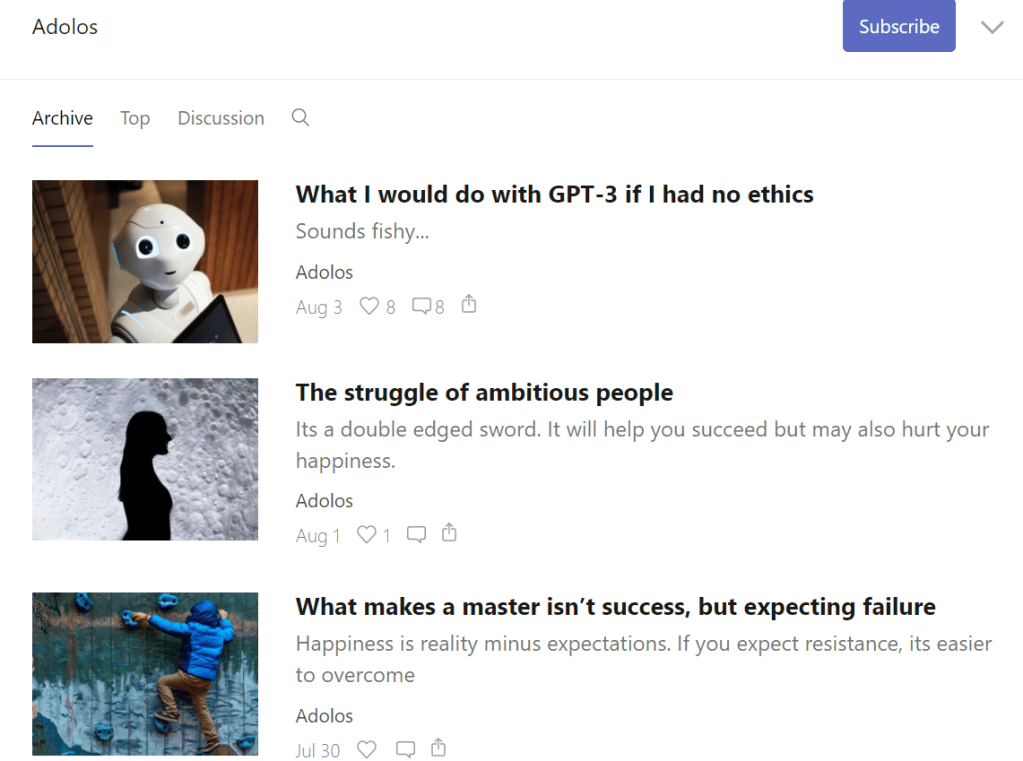
「Adolos」はマインドフルネスと創造性に関するブログで、仕事と心の健康に関し有益な記事を掲載している(下の写真)。その中で、「Feeling unproductive?」という記事を読むと、「考えすぎると思考回路がストップする。新たな分野に挑戦することで創造的な発想ができる。」とアドバイスする。このブログが話題となり、ニュースランキング(Y CombinatorのHacker News)でトップとなった。

出典: Adolos

しかし、このブログは人間ではなくGPT-3が作成したものであることが判明し、再び、話題となった。これは、カリフォルニア大学バークレー校の学生Liam PorrがGPT-3を使って作成したもので、ブログ記事のすべてがアルゴリズムで生成されている。ブログのタイトルと副題を入力すると、GPT-3がそのテーマに沿った記事を生成する。

GPT-3の得意分野と弱点

GPT-3でブログ記事を生成するにはコツがあり、アルゴリズムの特性に沿ったテーマを選ぶ必要がある。GPT-3がロジカルな記事を生成するとしばしば論理に齟齬が生じるが、メンタルな記事では人間のように滑らかな文章が生成される。マインドフルネスや創造性などのテーマがGPT-3の得意分野となる。

人間のインテリジェンスに到達

GPT-3は人間と変わらない技量で記事を書きブログを生成する。GPT-3の能力の高さに驚くと同時に、アルゴリズムが人間に近づき不気味さを感じる。この研究ではニューラルネットワークを大きくすると言語機能が高まることが示された。それでは、更に巨大なニューラルネットワークを構築すると人間レベルの言語能力を獲得できるのか、OpenAIのインテリジェンスの探求が続いている。