カテゴリー別アーカイブ: 人工知能

公開されているAIを悪用した攻撃が急増!!GANで高品質なフェイクメディアが量産され国家安全保障の危機

セキュリティの国際会議Black Hat 2020が開催され、最新の攻撃手法が報告された。今年は米国大統領選挙の年で、AIを使った攻撃が議論の中心となった。オープンソースとして公開されているAIを使うと、誰でも簡単に高品質のフェイクメディアを生成でき、情報操作の件数が急増している。

出典: FireEye

FireEyeのレポート

セキュリティ企業FireEyeはオープンソースのAIが悪用されている実態を報告した。これを使うと、誰でも簡単に高精度なフェイクイメージを生成でき、敵対する国家が米国などを標的に情報操作を展開している。FireEyeはシリコンバレーに拠点を置く企業でサイバー攻撃を防ぐ技術を開発している。

攻撃の概要

インターネット上にはオープンソースAI(ソースコードや教育済みのニューラルネットワーク)が公開されており、誰でも自由に使える状態になっている。これは研究開発を支援するための仕組みであり、オープンソースAIを改造して技術開発を進める。一方、この仕組みを悪用すると、簡単にフェイクメディア(偽のイメージや音声やテキスト)を生成できる。敵対国家は生成したフェイクメディアで西側諸国の世論を分断し社会を不安定にする。この情報操作は「Information Operations」と呼ばれ、米国で大統領選挙に向けて件数が急増している。

フェイクイメージ生成:StyleGAN2

情報操作で使われる手法は様々であるが、フェイクイメージを生成するために「StyleGAN2」が使われる。StyleGAN2とはNvidiaのKarrasらにより開発されたAIで、StyleGANの改良版となる。StyleGAN2はリアルなイメージを生成するだけではなく、アルゴリズムがオブジェクト(例えば顔)のパーツ(例えば目や鼻など)を把握し、異なるスタイルで対象物を描くことができる。

出典: NVIDIA Research Projects

StyleGAN2はGitHubにソースコードが公開されており、これを再教育することで目的のイメージを生成できる。オリジナルのStyleGANと比べて、StyleGAN2はエラー(Artifacts)が無くなり、イメージの品質が格段に向上した。(上の写真:StyleGAN2で生成した人間の顔のイメージ。このような人物は存在せず、攻撃者は架空の人物になりすまし、SNSで情報操作を展開する。)

StyleGAN2クラウド

アルゴリズムを再教育し実行するにはそれなりの技量がいるが、StyleGAN2のクラウドを使うと簡単にフェイクイメージを入手できる。その代表が「thispersondoesnotexist」で、StyleGAN2クラウドとしてAIが顔イメージを生成する(下の写真左端)。また、「thisartworkdoesnotexist」は抽象画を生成(下の写真中央)し、「thiscatdoesnotexist」は猫のイメージを生成する(下の写真右側)。これらはどこにも存在しない架空の人物や芸術や猫で、オンリーワンのオブジェクトとして希少価値がある。しかし、これらが悪用されると、真偽の区別がつかず、社会が混乱することになる。
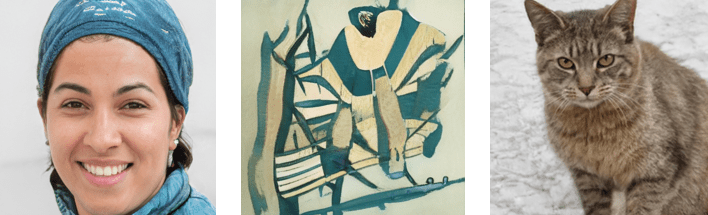
出典: thispersondoesnotexist / thisartworkdoesnotexist / thiscatdoesnotexist

偽のトム・ハンクスを生成

このStyleGAN2に俳優トム・ハンクス(Tom Hanks)の写真を入力し、アルゴリズムを再教育すると、AIが本物そっくりのトム・ハンクスを生成する。(先頭の写真、左下が入力された写真で、右端が生成された偽のトム・ハンクス。)生成された顔写真はトム・ハンクスと瓜二つで、真偽の区別はできない。攻撃者はStyleGAN2を使って異なるシーン(表情や年齢やヘアスタイルなど)のトム・ハンクスを生成し、これら架空の顔写真で本人を攻撃したり、世論を操作することが懸念される。もはや、ネット上のセレブの写真は本物であるという保証はない。

フェイクボイス生成:SV2TTS

この他に、「SV2TTS」という技法を使うと、フェイクボイスを生成できる。SV2TTSとは、テキストを音声に変換する技術(text-to-speech)であるが、AIが特定人物の声を学習する(下の写真)。例えば、SV2TTSに文章を入力すると、トム・ハンクスがそれを読み上げているフェイクボイスを生成できる。この技術はGoogleのYe Jiaなどによって開発され、GitHubにソースコードが公開されている。
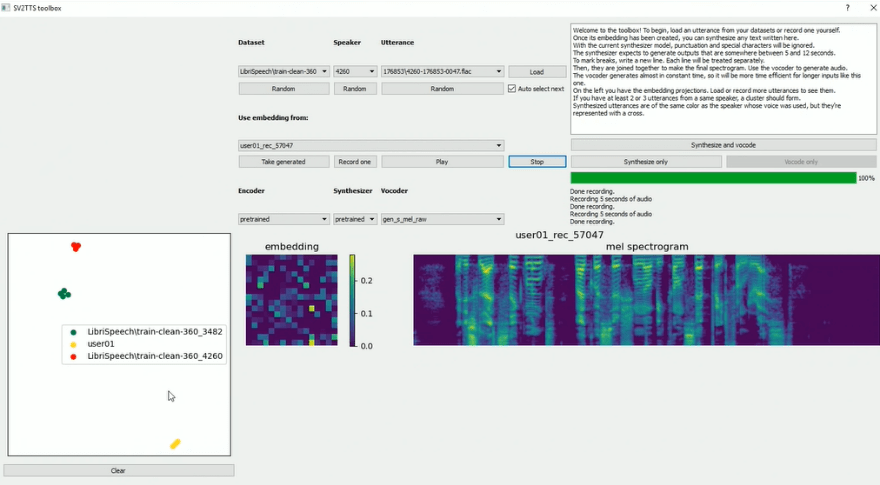
出典: Corentin Jemine

フェイクテキスト生成:GPT-2

更に、「GPT-2」を使うと、AIが人間のように文章を生成する。生成された文章はごく自然で、人間が作成したものと区別はつかない。GPT-2はAI研究非営利団体OpenAIにより開発され、その危険性を認識して、ソースコードは公開されていなかった。しかし、AIコミュニティが研究開発を進めるためはソースコードが必須で、OpenAIはこの方針を撤回し、GitHubにGPT-2を公開した。

GPT-2がツイートを生成

このため、テキスト生成の研究が進むと同時に、GPT-2を悪用した攻撃も始まった。GPT-2をソーシャルメディアのテキストで教育すると、AIがリアルなツイートを生成する。更に、情報操作のために発信されたツイートで教育すると、人間に代わりGPT-2が世論を操作するツイートを生成する。実際に、ロシアの情報操作機関Internet Research Agencyが発信したツイートで教育され、GPT-2が米国の世論を分断するツイートを自動で生成する。

出典: FireEye

(上の写真:GPT-2が情報操作のためのツイートを生成した事例。GPT-2は「It’s disgraceful that they are deciding to completely ban us! #Immigrants #WakeUpAmerica」と、トランプ大統領の移民禁止政策に反対するツイートを生成。GPT-2が生成するツイートは短く簡潔で、ツイッター独自の言い回しで、しばしば間違った文法の文章を生成。文章の最後にはハッシュタグを挿入。人間が生成したものとの見分けはつかず、AIが人間に代わり社会を攻撃する。)

Twitter Botsによる偽情報

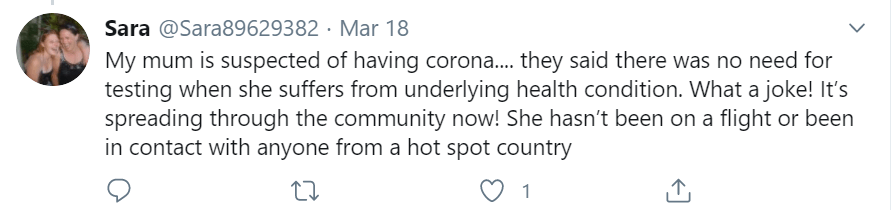
いま、ツイッターにはコロナウイルスに関するツイートが数多く掲載されているが、このうち半数がAI(Twitter Botsと呼ばれる)により生成されたものである。これらツイートは社会を混乱させることを目的とし、「既往症があればコロナウイルスのPCR検査は不要」などと主張する(下の写真)。もはや、フェイクとリアルの見分けはつかず、読者は状況を総合的に判断して理解する必要がある。また、AI開発ではソースコードの公開が必須であるが、AI開発者はフェイクを見分ける技術の開発も求められている。
出典: “Sara”

米国大統領選挙への介入

今年11月には米国大統領選挙が行われ、既に、ロシアや中国やイランが情報操作作戦を展開している。国家情報局・防諜部門(National Counterintelligence and Security Center)によると、ロシアはトランプ大統領再選を目指し、中国とイランはバイデン候補を支援する情報操作を展開していると報告している。また、Black Hatセキュリティ国際会議で、ロシアの情報操作技術が他国に比べ圧倒的に高く、最も警戒すべき国家であると報告された。米国や西側諸国はAIを悪用した攻撃に対する防衛能力が試されている。
AIのブラックボックスを開く、GANがフェイクイメージを生成するメカニズムが明らかになる

AI・機械学習の最大の学会であるInternational Conference on Machine Learning(ICML)が開催され、ワークショップでは研究テーマごとに最新技法が議論された。今年はAIのブラックボックスを解明する技法の研究が進み、フェイクイメージが生成されるメカニズムが見えてきた。

出典: Bolei Zhou et al.

Explainable AI

AIはブラックボックスでアルゴリズムの判定ロジックが分からないという問題を抱えている。AIが判定理由を説明する機能は「Explainable AI」と呼ばれ重要な研究テーマとなっている。イメージ判定の分野で研究が進み、AIは判定理由をヒートマップで示す。(下の写真左側:AIは写真を歯磨きをしているシーンと判定したが、その根拠をヒートマップで示している。歯ブラシとそれを持つ手から歯磨きと判定した。右側:木を切っているシーンではチェーンソーと人間の頭部が決め手となった。)

出典: Bolei Zhou et al.

Extending Explainable AI

今年のテーマはこれを拡張した技法の研究で「Extending Explainable AI(XXAI)」と呼ばれる。ワークショップでExtending Explainable AIの研究成果が発表され、Chinese University of Hong KongのBolei Zhou助教授が、GAN(Generative Adversarial Networks)がフェイクイメージを生成する仕組みについて講演した。

GANとは

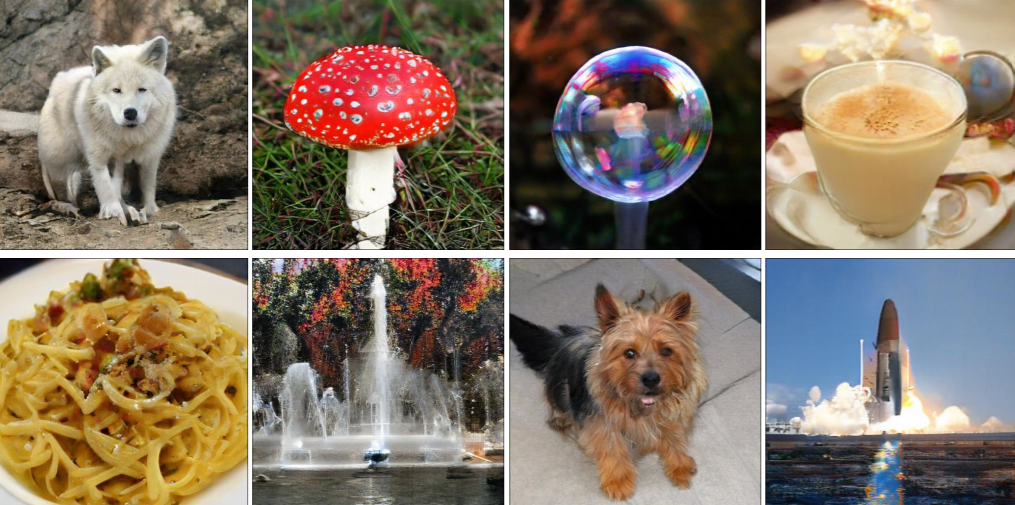
GANとは二つのAIが競い合ってフェイクイメージを生成する技法を指す。作画AI(Generator)がフェイクイメージを生成し、これを判定AI(Discriminator)が真偽を判定する。作画AIの技量が上がると、完璧なフェイクイメージを生成し、判定AIは騙され、これを本物と認定する。今では高解像度のフェイクイメージが生成され、本物との見分けはつかない(下の写真、BigGANという手法で生成された高精度イメージ)。

出典: Andrew Brocket al.  

GANがフェイクイメージを生成する仕組み

GANはGeneratorが生成したイメージをDiscriminatorが真偽を判定し精度を上げるが、この研究ではGeneratorに着目し、入力データをイメージに変換するプロセスを解明した。GANは入力されたデータ(ランダムな値)を各ノードで処理して最終イメージを生成するが、各ノードはイメージ生成で特定の役割を担っている。

(下の写真、GANのGenerator(左側のネットワーク)のノードは役割が決まっている。黄色のノードは雲を生成する。青色のノードは草を、肌色のノードはドアを生成する。生成されたイメージ(右側:generated image)は教会の周りに草木が茂り背後には空が見える写真となる。)

出典: Bolei Zhou

入力データとイメージの関係

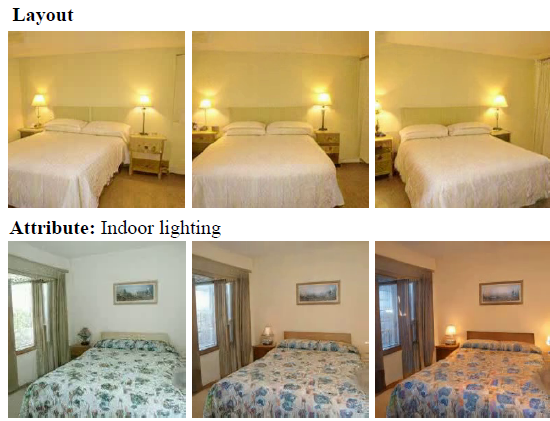
今年は、上述の研究をもう一歩進め、入力データがイメージ生成にどのように関わっているかを解析した。入力データはランダムなベクトルで構成されLatent Spaceと呼ばれる。つまり、教育済みのGANにランダムな数字を入力すると寝室などを描き出す(先頭の写真)。ここで、入力する数字を変えると、寝室の内容が変わる。(先頭の写真上段:寝室を見る視点が変わる。下段:寝室のランプの輝度が変わる)。

データの役割を見つけ出す手法

入力データの数字を変えることで寝室のランプの輝度が増し部屋が明るくなるが、どのデータがこれに関与しているかは、生成されたイメージを分類することで特定する(下の写真)。具体的には、イメージフィルター(attribute classifier、F()の部分)で生成したイメージを区分けし、更に、イメージフィルターを入力データ(Latent Space Zの部分)で教育することで、どのデータがイメージ特性に寄与しているかが分かる。

出典: Bolei Zhou et al.

InterFace GAN

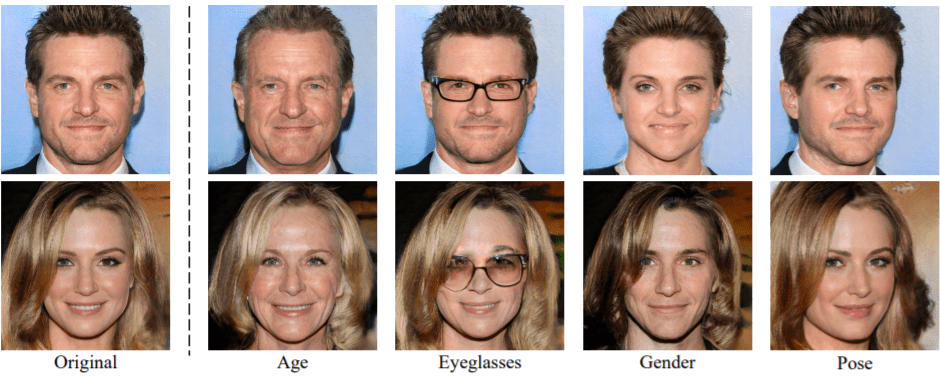
この仕組みを人の顔に適用すると入力データを操作することで顔の特性を変えることができる。この手法はInterFaceGANと呼ばれ、入力データの意味(Latent Space Semantic)を理解して、データを操作し、顔写真を編集することができる。Latent Space Semanticは年齢、メガネの着装、性別、顔の向き、表情などの意味を持ち、これらのデータを編集することで、顔写真を編集できる。(下の写真:左端の人物が、年を取り、メガネをかけ、性別を転換し、顔の向きを変えたケース。) 

出典: Bolei Zhou et al.  

GANのメカニズムの解明が進む

今年のメインテーマは説明責任のあるAIの拡張版Extending Explainable AIで、イメージ判定(Convolutional Neural Networks)だけでなく、ランダムフォレスト(Random Forrest)や強化学習(Reinforcement Learning)やGANなどに対象が拡張された。上述の事例がGANのケースでアルゴリズムがイメージを生成するメカニズムが分かってきた。これにより、データを操作するだけでイメージを編集できGANの応用分野が広がってきた。

もうスパコンは要らない!?AIが物理学を学習し物質の動きをシミュレーション、DeepMindの最新研究成果から

先々週、AI・機械学習の学会International Conference on Machine Learning(ICML)が開催され最新の研究成果が発表された。今年はコロナ感染拡大のためデジタル学会となり、欧米及びアジア諸国の研究者がオンラインで参加し、Zoomで講演する形式となった。

出典: Alvaro Sanchez-Gonzalez et al.

DeepMindの研究概要

この中でDeepMindはAIをシミュレータとして使う技法を発表した。シミュレータは物理現象をグラフィカルに表示する機能を持ち、水槽に水を注ぐと、AIがその動きを予測し、水の動きをビデオで表現する(上の写真右側)。実際の水の動き(上の写真左側)と比べると、複雑な動きをAIが正しく予測していることが分かる。

ニューラルネットワークでシミュレーション

これは「Graph Network-based Simulators」と呼ばれ、ニューラルネットワークでシミュレータを構築する。上の事例は、ニューラルネットワークが水槽に注がれた水の動きを予測したもので、初期条件を入力すると、ニューラルネットワークがその後の動きを計算する。つまり、ニューラルネットワークで水を表現し、それを動かすと、その後の挙動を推測する。

汎用のシミュレータ

Graph Network-based Simulatorsは、水のような液体だけでなく、砂やゼリーなど物理特性の異なる物質の動きを予測できる。水槽に水の塊を落とすと、その後の水の動きを予測する(下の写真上段)。同じニューラルネットワークが、ゼリーの塊を重ねると、それが崩れる動きを計算する(下の写真中段)。また、砂の塊を落とすと、それがタンク内に広がる動きを予測する(下の写真下段)。

出典: Alvaro Sanchez-Gonzalez et al.  

ニューラルネットワークの教育

ニューラルネットワークは実際の物質の動きを見て物理法則を学習する。教育の過程で、物質の動きを1ステップだけ教えると、ニューラルネットワークは数千ステップ先まで予測する。つまり、AIは物理法則を習得し、水槽に水の塊を落とすと、水が波打ちそれが鎮まるまで、遠い先の動きまで予測する。

シミュレーションの規模

更に、少量の物質(例えば水の分子2000個)を使ってニューラルネットワークを構成すると、ネットワークは大量の物質(水の分子85,000個)の動きを予測する。このため、少量の水で流れ方を教えると(下の写真、右上の箱)、ニューラルネットワークは大量の水の流れ方を学習する(下の写真、全体部分)。

出典: Alvaro Sanchez-Gonzalez et al.  

スパコンによるシミュレーション

物理現象のシミュレーションにはスパコンが使われる。スパコンは物質の動きをシミュレーションするために開発されたといっても過言ではない。事実、米国国立研究所Oak Ridge National LabはIBMのスパコン「Summit」を使って様々なシミュレーションを実行している。原子炉内部をスパコンでシミュレーションし、原子炉の耐用期間を延長する研究を展開している。

AIがスパコンを置き換える

スパコンによるシミュレーションで社会は多大な恩恵を受けているが、そのための対価が大きいのも事実である。IBM Summitのコストは2憶ドルといわれ、また、シミュレーショアプリの開発では数多くの研究者が必要となる。これに対し、Graph Network-based Simulatorsは汎用シミュレータで安価なAIプロセッサ(Google Cloud TPU)で動き、幅広い分野に適用できる。今すぐにSummitを置き換えることはできないが、AI開発が進むことでスパコンの一部をニューラルネットワークで代行できると期待されている。

【技術情報:Graph Network-based Simulators】

ニューラルネットワークの構成

Graph Network-based Simulatorsはニューラルネットワークで構成され、ネットワークのニューロンに物質の最小単位(例えば水の分子)を割り当てる。更に、ニューロン間の物理状態(分子の位置や速度、物質の特性、重力など)を指定する。これを実際の物理現象で教育すると、ニューラルネットワークは物質の動きを理解する。完成したニューラルネットワークに初期条件(水槽に水を灌ぐなど)を入力すると、その後の動きを予測する。

ニューラルネットワークの機能

Graph Network-based Simulatorsは物質の分子をEncodeし、これをProcessorで実行し、その結果をDecodeする(下のグラフィックス)。Encodeとは物質の状態(位置や速度や特性など)を凝縮しベクトルで表示する処理を指す。Processorは入力された分子の状態を元に、次の動きを予測する。Processorはこのプロセスを繰り返し、将来の動き(Mステップ先)まで予測する。DecodeとはProcessorの予測結果(ベクトル)を物質の状態に戻す処理をする。

出典: Alvaro Sanchez-Gonzalez et al.  

Message Passingという手法

Graph Network-based Simulatorsは物質の分子をネットワークのニューロンに割り当てるが、これら分子間の相互作用をメッセージ交換(Message Passing)として表現する(下のグラフィックス、中央)。メッセージを交換することで、分子は次の状態に移る。このプロセスを繰り返し分子の動きをMステップ先まで予測する。メッセージは分子の特性(物質の特性や重力など)と隣の分子との相互関係(距離や速度など)で構成される。

出典: Alvaro Sanchez-Gonzalez et al.  

Teslaは完全自動運転車を年内に投入すると表明、AIがクルマを運転する仕組みと解決すべき課題も判明

Tesla CEOのElon Muskは中国・上海で開催されたAIイベントで、完全自動運転車を今年末までにリリースすることをビデオメッセージで表明した。これは「Full Self-Driving」と呼ばれ、レベル5の自動運転機能で、ドライバーの介在無しにクルマが自律的に走行する。また、これを支えるAIについて、基本機能は問題ないが、まだ解決すべき課題があることも明らかにした。

出典: Tesla  

自動運転車の方式

自動運転技術は完成度が上がり、無人走行の試験が進んでいるが、クルマはどこでも走れるわけではない。自動運転車は事前に定められた域内だけで運行できる設計で、域外では自動走行できない。これに対しTeslaは、AIが人間のドライバーのように視覚(カメラ)の映像だけでハンドルを操作し、初めての街でも自律的に走行できる。これを支えているのが高度なAIでその構造と課題が明らかになった。

Waymoのアプローチ

Waymoなど多くの自動運転車はLidar(レーザーセンサー)とカメラを組み合わせて周囲の状況を把握する。更に、走行前にその地域の詳細なマップ(Base Map)を作成しておき、クルマはこれに沿って自動走行する。マップは仮想レールともいわれ、クルマは事前に定められたコースを忠実に走行する。

Teslaのアプローチ

これに対して、Teslaはカメラだけで自動運転機能を実現する極めて先進的なアプローチを取る。また、詳細マップは不要で、AIが人間のドライバーのように、初めての街でも運転できる。つまり、メーカーはクルマを販売するだけで、詳細マップの開発や更新は不要となり、事業規模を制約なしに拡大(Scalability)できる。Teslaは自動運転車事業を成功させるためにはこのアプローチしかないと主張する。

Teslaの自動運転技術

Teslaは「Autopilot」と「Full Self-Driving」の二種類の自動運転機能を提供している。Autopilotは運転支援機能で、ドライバーに代わりソフトウェアがクルマを制御する。クルマは周囲の車両の速度に合わせて走行し、車線を認識しレーンをキープする。Autopilotは限定的な自動運転機能で、ドライバーは両手をステアリングに添えておく必要がある。Autopilotはすべての車両に搭載されている。

Full Self-Driving

Full Self-Drivingは高度な自動運転機能で、高速道路や市街地を自動で走行する。高速道路では、入り口から出口まで自動走行し(Navigate on Autopilot)、車線変更も自動で行う(Auto Lane Change)。また、自動で駐車する機能や、駐車場からドライバーのところに自動で移動する機能もある(Smart Summon)。更に、市街地においては信号を認識し、自動で走行する。これは「Autosteer on City Streets」と呼ばれ、完全自動運転車の中核機能となる(下の写真)。この機能は2020年末までにリリースされる予定で、これでレベル5の完全自動運転車が完成する。

出典: Tesla  

完全自動運転車がデビュー

市販されているクルマはFull Self-Drivingに必要なセンサーやプロセッサ(FSD Computer)を搭載しており、ソフトウェアのアップデートで完全自動運転車となる。クルマを購入する際にFull Self-Drivingを選択するとこの機能を使え、価格は8,000ドルに設定されている。Full Self-Drivingのリリース時期は当初の予定から遅れたが、ついに年内に製品が登場する見込みが濃厚となった。他社が苦戦する中でTeslaが先行して完全自動運転車を市場に投入することになる。

【技術情報:Full Self-Drivingの仕組みと課題】

システム全体の構造

Teslaは自動運転システムについて明らかにしており(下の写真、左側)、AIのアルゴリズム教育から実行までを統合して実行する。市販車両はカメラで路上のオブジェクトを撮影するが、これらはデータベース「Data」に集約される。これを使ってアルゴリズムを教育(「Dojo Cluster」と「PyTorch Distributed Training」)し、その結果を検証「Evaluation」する。教育されたアルゴリズムはオンボードコンピュータ「FSD Computer」に実装されクルマを制御する。これに加えもう一つのAIがこの背後で稼働し、密かに自動運転の訓練を積んでいる(Shadow Mode)。

出典: Tesla  

ニューラルネットワークの構造

ニューラルネットワークは「HydraNet」と呼ばれ、カメラが撮影した映像を解析する。HydraNetは共通機能「Shared Backbone」に特定機能を搭載した構造となる(上の写真、右側)。共通機能はイメージ判定ネットワーク(ResNet 50)で構成され、ここでオブジェクトの種別を判定する。この情報を元に、特定機能がオブジェクト判定(Objects)や信号機の読み取り(Traffic Lights)などを行う。共通機能に複数の特定機能が首のようについており、その形が妖怪ヒドラに似ていることから、HydraNetと呼ばれる。

ニューラルネットワークの機能

HydraNetは道路周辺のオブジェクトを認識し、信号機や車線などを把握する。クルマはこの情報を元にレーンをキープし、赤信号で停止する。HydraNetは単体で使われるだけでなく、複数のネットワークを組み合わせ、複雑なタスクを実行する。例えば、二つのカメラが撮影した映像を二つのHydraNetで処理し、それを重ね合わせてオブジェクトを3Dで把握する(下の写真)。この他に、複数のHydraNetで道路のレイアウトを把握することもできる。

出典: Tesla  

AI専用プロセッサ

TeslaはAI処理専用プロセッサ「FSD Computer」(下の写真、左側)を独自で開発し、これをクルマに搭載し、AIを高速で処理する。このボードは二つのチップ「FSD Chip」を搭載し、チップにはAI処理装置「NPU」を積んでいる。クルマに搭載されているAIの数は多く、これらを処理するためには高性能AIプロセッサーが必要になる。クルマで48のニューラルネットワークが稼働し、1,000種類の判定結果(Tensor)を出力する。高速で走行するクルマはリアルタイムでこれらのAIを実行することが必須要件となる。

出典: Tesla  

クルマがオブジェクトを認識

クルマに搭載されたHydraNetは走行中にカメラが撮影した映像から、そこに映っているオブジェクトを判定する(下の写真、左側)。クルマや歩行者などの他に、道路の車線や道路標識などを把握する。このケースは一時停止標識「Stop」を検知した状況で、HydraNetが正しく道路標識を認識できるかがクルマの安全性に結び付く。

出典: Tesla  

アルゴリズム教育

このため、HydraNetは写真に写っている市街地の様々なオブジェクトを使って教育される。市販のクルマは搭載しているカメラで走行中に車線や道路標識や歩行者など数多くのオブジェクトを撮影し、これらの映像はTeslaのクラウドに送信される。Teslaは、写真に写っているオブジェクトの名称を付加し(上の写真、右側)、これを教育データとして使う。市販車両が撮影した大量の映像が教育データとして使われ、ドライバーはAI教育に寄与していることになる。

Data Engine

アルゴリズム教育では如何に多種類のデータを揃えるかでAIの認識精度が決まる。例えば、一時停止標識の見え方は様々で、街路樹に隠れて見えにくいケースや、夜間の暗がりで判別しにくいものがある(下の写真、左側)。Teslaは収集した映像の中から、異なるケースのオブジェクトを見つけ出すAI「Data Engine」を開発した。Data Engineは路上で起こりえる様々なケースを見つけ出し、アルゴリズムの判定精度を向上させる。

出典: Tesla  

データのロングテール

つまり、HydraNetの教育ではロングテールのデータを如何に大量に収集できるかで判定精度が決まる。クルマは走行中に考えられない事象に出くわす。トラックの荷台から椅子が落ち、クルマで犬を散歩させているシーン(上の写真、右側)に遭遇する。Data Engineはこれら非日常的なシーンを見つけ出し、これらのデータでアルゴリズムを教育すると、めったに起こらない事象にも対応できるAIが完成する。TeslaによるとAI開発の難しさはアルゴリズムではなく、これらロングテールのデータを揃えることにあるとしている。

Software 2.0

クルマのソフトウェアはAIとコーディングの部分で構成される。初期のソフトウェア(Software 1.0)はAIの判定結果を人間がC++でコーディングしてオブジェクトの意味を判断していた。最新のソフトウェア(Software 2.0)では、AIが独自でオブジェクトの意図を把握する。今ではソフトウェアに占めるAIの部分が大きくなり、入力から出力までプログラムの介在なく、AIが処理を担う方向に進んでいる。(下の写真、割り込みを検知する事例:Software 1.0ではルールをコーディングしてこれを検知(左側)、Software 2.0ではAIが事例を学習してこれを検知(右側)。)

出典: Tesla  

Bird’s Eye View Network

クルマが走行中に走行経路を予測するために専用のAI「Bird’s Eye View Network」が開発された。これは複数のカメラの映像(下の写真、上段)を繋ぎ合わせ、車線や道路の端や移動オブジェクトを把握し(下の写真、下段:青色が車線で赤色が道路の端を示す)、安全に走れるルートを算出する。クルマはこの解析データを元に走行する車線を決め、このネットワークが自動走行のブレインとなる。

出典: Tesla  

自動運転技術の最後の壁

Bird’s Eye View Networkの精度が自動走行できる範囲を決める。実社会には上の事例のようにシンプルな交差点だけでなく、複雑な交差点が多数存在する。人間でもうまく運転できない場所は多く、走行経路をニューラルネットワークが如何に正確に予測できるかがカギとなる。こがTeslaの自動運転技術開発の大きな壁となり、これを乗り越えないと完全自動運転車は完成しない。AIがカメラだけで道路の形状を認識、走行経路を算定できるのか、学術研究のテーマとしても大きな意味を持っている。このため、Teslaは大学に呼びかけ、共同研究を通じブレークスルーを目指している。

Lidar対カメラ

自動運転車のアーキテクチャは二つに分かれ、WaymoのようにLidarを使う方式と、Teslaのようにカメラを使う方式になる。前者が主流でクルマはLidarとカメラを併用して自動走行を実現する。一方、Teslaは独自の道を歩み、カメラだけでこれを実現する。ハードウェアの助けを借りないでソフトウェアでこれを実現するもので、AIの開発成果が成否を握る。この方式が成功すると、製造コストは劇的に下がり、自動運転車が幅広く普及することとなる。Teslaはハイリスク・ハイリターンなルートを進んでいる。

全米で顔認識技術の使用が禁止される、AIの判定精度が悪く人種差別や誤認逮捕につながる

米国連邦議会は顔認識技術の使用を全米で禁止する法案を提案した。これは連邦政府関係者が顔認識技術を使うことを禁止するもので、AIの危険性が全米レベルで認識されたことを意味する。既に、サンフランシスコ市などは顔認識技術の使用を禁止しているが、この流れが全米に拡大した。この背景には、アメリカ社会の人種差別に関する構造的な課題がある。

出典: MIT Media Lab

法案の概要

この法案は「Facial Recognition and Biometric Technology Moratorium Act」と呼ばれ、民主党の有力議員により提案された。法案は連邦政府の治安部門が顔認識技術(facial recognition technology)を所有し、これを使うことを禁じている。更に、連邦政府から助成金を受けている地方政府にも同様の規制を求める。

人権問題との関連

米国では警察が顔認識技術を使って犯罪捜査をすることに対し批判的な意見が多く、議論が続いていた。この中で、警察が黒人男性George Floyd氏を死亡させたことで、全米各地で抗議デモが続いている。警察の捜査手法に抗議するもので、顔認識技術もその一つであるとの認識が広がっている。顔認識技術は完全ではなく、判定精度に偏り(Bias)があり、犯罪捜査で黒人に不利になっているという事実がある。

IBMは事業を停止

このような社会情勢の中で、主要IT企業は顔認識技術の使用中止を表明した。6月9日、IBMは顔認識技術の開発と販売を中止し、事業から撤退することを発表した。この理由として、顔認識技術は人種差別を助長する要因となっており、IBMは技術が住民監視や、人種特定に使われることに反対し、国民の人権と自由を守ると表明した。

Amazonはモラトリアムを宣言

Amazonはその翌日、顔認識技術の使用を制限すると発表した。具体的には、顔認識技術「Rekognition」を警察が使用することを1年間中止する。警察による過剰な捜査手法が問題になり、顔認識技術もこの一部として認識され、Amazonは国民世論に押されモラトリアムを宣言した形となった。(下の写真、Rekognition:アマゾンクラウドの機能で使用料が安く、多くの警察で使われている。)

出典: Amazon  

顔認識技術の問題点

多くの企業が顔認識技術を提供しているが、非難の矛先はAmazonに集中している。Amazonの顔認識技術Rekognitionは他社に比べて判定精度が低いとの指摘がある。更に、人種間で判定精度が大きく異なるという問題を抱えている。白人では判定精度のエラー率は3.08%であるが、黒人のエラー率は15.11%と高い。更に、白人男性ではエラー率はゼロであるが、黒人女性のケースでは31.37%と高い。つまり、犯罪捜査でRekognitionが使われるが、黒人の判定精度は低く、これが誤認逮捕につながる。(下のテーブル:主要各社の顔認識技術とその判定精度、Amazonは下から二段目、各社とも黒人の判定精度は低い)

出典: Inioluwa Deborah Raji et al.

警察の利用方法

Rekognitionは全米の多くの警察で利用されている。犯罪捜査で被疑者の写真から身元を割り出すためにRekognitionが使われる。犯罪現場で監視カメラが撮影した被疑者の顔写真と、犯罪者データベースを比較して、その人物の名前を特定する。被疑者の顔写真を入力すると、Rekognitionがその特徴量でデータベースを検索し、よく似ている顔を出力する(下の写真)。犯罪者データベースには収監された犯罪者の顔写真が格納されている。被疑者の身元を簡単に特定できるため、Recognitionは犯罪捜査で大きく役立っている。

出典: Washington Post

顔認識技術が誤認逮捕の原因

顔認識技術を使った犯罪捜査で恐れていた事態が発生した。New York Timesなどがこれを報道し、AIの危険性が再認識された。ミシガン州デトロイト警察は顔認識技術を使い犯罪捜査を進めている。監視カメラに写った顔写真を顔認識システムに入力し、その人物身元を割り出す。このケースでは、AIの判定結果は間違いで、黒人男性を誤認逮捕し長時間にわたり拘留した。警察はAIが判定する結果に基づき被疑者の逮捕に踏み切った。記事は、デトロイト警察は顔認識技術はRecognitionではなく、日本企業など技術を使っていると報じている。

アルゴリズムがバイアスする理由

人種間で判定精度が大きく異なる理由は明白で、教育データが偏っているためである。アルゴリズムは数多くの白人の顔写真で教育され、白人についての判定精度は高くなる。一方、黒人の教育データ数は少なく、そのため、アルゴリズムの判定精度が下がる。このため、教育データを整備するとき、人種間でばらつきをなくすることで問題を解決できる。

根強い不信感と地域の治安

顔認識技術が社会問題となったのは、判定精度だけでなくその利用方法にある。仮に、アルゴリズムのバイアスが修正されても、顔認識技術への抵抗感は根強く存在する。警察の犯罪捜査で、顔認識技術が特定人種の被疑者を逮捕する方便として使われる、と解釈する人は少なくない。また、国家が顔認識技術で国民の行動をモニターしていると感じる人も少なくない。その一方で、顔認識技術が犯罪捜査に役立ち、地域の治安に大きく貢献していることは事実である。特に、テロリスト対策で顔認識技術は国家安全保障に寄与している。

出典: Deepak Babu Sam et al.

政府のガイドライン

つまり、顔認識技術に関するガイドラインの欠如で不信感が増幅され、技術が治安に生かされていない。今は、統一した基準はなく、Amazonなど各社は独自のルールを作り、事業を進めている。一方、ある新興企業は犯罪すれすれの手法で顔認識技術を開発し問題が深刻化している。このため、AmazonやMicrosoftなどIT企業各社は連邦政府に対し規制の制定を呼び掛けている。上述の法令は顔認識技術の使用を全面的に禁止するもので、運用ルールについては触れていない。これが最初のステップとなり、政府のガイドライン制定が進むことが期待されている。