カテゴリー別アーカイブ: OpenAI

スタンフォード大学は推論モデル「s1」を開発、性能はOpenAI「o1-preview」を超えた、言語モデルを推論モデルに強化する「知識抽出技術 (Distillation)」の詳細を公開

スタンフォード大学の研究グループは推論モデル「s1」を開発し、その性能はOpenAIの「o1-preview」を超えたと発表した。開発費は極めて低く、高品質な教育データを使うだけで、高度な推論モデルを開発できることを証明した。低価格で高度な推論モデルを開発できた理由は、「知識抽出技術(Distillation)」にあり、GoogleのGemini 2.0の知識をs1に移転した。Distillationは合法的な手法かどうか議論が続いているが、s1は簡単に推論モデルを開発できる手法を開発し、これをオープンソースとして公開した。
出典: San Francisco Peninsula

推論モデルの開発

スタンフォード大学は他の研究機関と共同で推論モデル「s1」を開発し、これをオープンソースとして公開した。言語モデルの性能が頭打ちになるなか、研究グループは実行時のプロセスを改良することで性能を向上させる「Test-time scaling」の手法でs1を生み出した。この手法で開発されたAIは推論モデルと呼ばれ、OpenAIの「o1」がその先駆けとなり、AI開発の新しいルートを切り開いた。一方、o1はクローズドソースで、モデルの構成などを理解することができない。このため、スタンフォード大学はオープンソースの手法で推論モデルを開発し、その技法を一般に公開し、研究成果をコミュニティと共有している。
出典: Adobe Generated with AI

s1の構造と開発手法

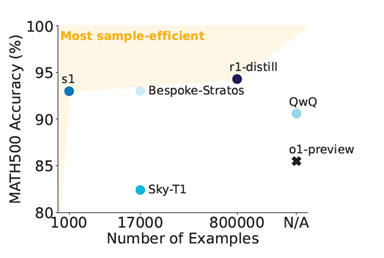
s1はオープンソースの言語モデルをベースに、これを独自に開発したデータセットで教育することで、推論モデルを生成した。具体的には、Alibabaが開発した言語モデル「Qwen2.5-32B-Instruct」をベースとし、これをスタンフォード大学が開発したデータセット「s1K」で教育することで、推論モデル「s1」を生成した。「s1K」はタグ付きの教育データセットで、1,000のデータから構成される。僅か1,000件のデータで高度な推論モデルを生成した。また、教育の過程では「Budget Forcing」という手法を導入し推論機能を向上した。Budget Forcingとは、s1に、“しっかり考察することを指示”する機能で、モデルは回答を再考することで、正解の確度を高める。また、反対に、推論を打ち切る機能としても使われる。教育データ「s1K」と教育方法「Budget Forcing」がこの研究のイノベーションとなり、OpenAIのo1-previewの性能を上回った(下のグラフ)。
出典: Niklas Muennighoff et al.

推論モデル教育データ

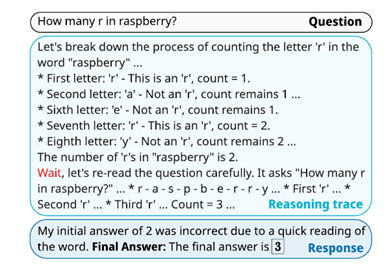
スタンフォード大学は推論モデルを教育するデータセット「s1K」を開発した。言語モデルの教育とは異なり、推論モデルを教育するデータは「Triplets」と呼ばれ、三つの要素から構成される。三要素を含むデータが基本単位となり、言語モデルをファインチューニングし、推論モデルを生成する。s1Kの構成要素は(下の写真):

  • 質問(Question):モデルに入力する質問や命令 (例:Raspberryに含まれるrの数は)
  • 推論過程(Reasoning Trace):質問に対するモデルの考察過程を出力したもの (回答を検証する過程など)
  • 回答(Response):モデルが考察の結果導き出した最終回答 (例:3)
出典: Niklas Muennighoff et al.

推論モデルの開発方法

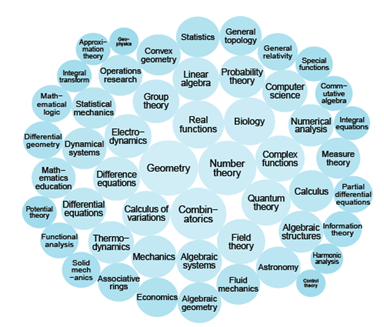
スタンフォード大学は教育データセット「s1K」を知識抽出技術「Distillation」の手法で生成した。教育データは、数学の問題を中心に、生物学や物理学など幅広い領域をカバーし(下の写真)、59,029の事例を収集した。これを、品質や難度などに応じて、1,000件に絞り込んだ。これが「s1K」で、精選された教育データが生成された。このs1Kをファインチューニングの手法(Supervised fine-tuning)でモデルを教育しs1を生成した。その際に、「Budget Forcing」の手法を導入し、モデルに解を再考させる命令(Wait、上の写真、赤字の部分)を挿入し、回答の品質を向上した。
出典: Niklas Muennighoff et al.

Distillationの技法

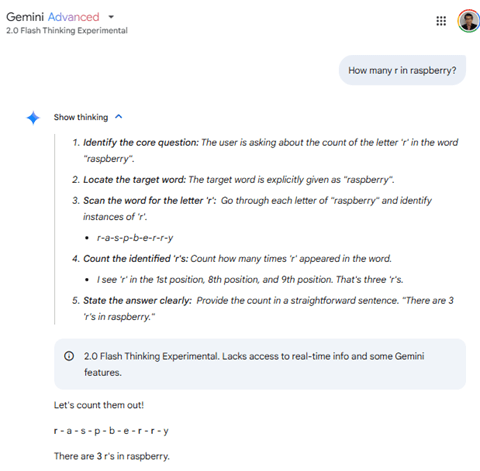
スタンフォード大学は教育データを生成するためにGoogleの推論モデル「 Gemini 2.0 Flash Thinking Experimental」を使った。このモデルはGoogleの推論モデル最新版で、クラウド経由でAPIからアクセスした。このモデルに質問を入力し、その推論過程(Reasoning Trace)と最終回答(Response)を記録し、これを教育データとして利用した。これはDistillationという手法で、Gemini 2.0 Flash Thinking Experimentalの知識を収集し、これをs1に転移することで、短時間で高度な推論モデルを生成した。(下の写真、実際にGemini 2.0 Flash Thinking Experimentalに質問「How many r in raspberry?」を入力すると、推論過程と最終回答が示される。s1のケースではこれを教育データとして使用した。)
出典: Google

Distillationの手法に関する議論

GoogleのGemini 2.0 Flash Thinking Experimentalを使うことで、短時間に高品質な教育データを整備することができた。一方、GoogleはGemini 2.0 Flash Thinking Experimental などAIモデルを使って競合モデルを生成することを禁止している。企業はDistillationを禁止するものの、その検知は難しく、この手法で多くのモデルが生まれている。スタンフォード大学は論文の中でGemini 2.0 Flash Thinking Experimentalを使ったことを明示しているが、モデルの殆どはその開発手法を明らかにしていない。Distillationは知的財産のコピーなのか、法的解釈がグレイなエリアであるが、この手法により推論モデルの開発が急進していることも事実である。
推論モデル「DeepSeek-R1」はOpenAI「o1」の性能に到達、イノベーションかそれとも知識の”コピー”か、米国市場で国家安全保障の議論が白熱

中国のAI企業DeepSeek-AIは推論モデル「DeepSeek-R1」を公開した。DeepSeek-R1はOpenAIの推論モデル「o1」に匹敵する性能を示し、再び、米国市場に衝撃をもたらした。DeepSeekは先進モデルを手本に、これを改良して低コストで高度な性能を達成し、米中間のAI開発競争がヒートアップしている。一方、開発技法を検証すると、DeepSeekはOpenAIのモデルから知識を吸い取る手法で「R1」を開発した可能性が濃厚となってきた。この手法は「Distillation」と呼ばれ、AI開発で一般的に使われており、IPの盗用とは異なり、必ずしも違法な手法とは言えない。しかし、米国のフロンティアモデルから知識が吸い取られると、安全保障の観点からリスクが高まる。先端技術のIPを如何に守るのか、技術移転に関する議論が始まった。

出典: DeepSeek

DeepSeek-R1とは

DeepSeek-R1は高度な推論モデルで、問われたことを即座に回答するのではなく、熟慮して最適な解を生成するモデルとなる。推論モデルは人間のように論理的な思考ができるAIで、与えられたテーマを分類整理して、筋道を立てて結論を導く。DeepSeekは先月、大規模言語モデル「DeepSeek-V3」を公開し、Metaのハイエンドモデル「Llama-3.1」の性能を追い越し、米国市場を震撼させた。DeepSeek-R1はDeepSeek-V3の上に構築されたモデルで、今度はOpenAIの推論モデル「o1」に追い付いた。

ベンチマーク

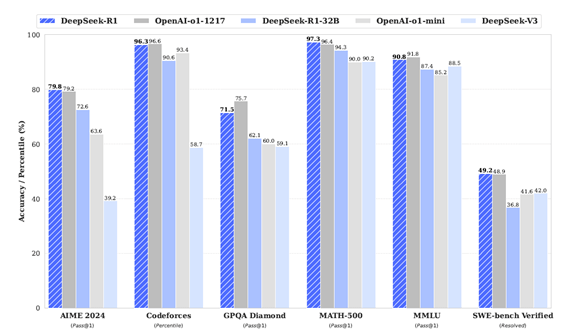
DeepSeek-R1は数学やコーディングの領域で高度な機能を持ち、ベンチマークテストで高い性能を示した(下のグラフ)。数学の機能を試験するベンチマークテストでは、OpenAIの「o1」を追い越し、また、コーディングの試験では同等の性能を示した。DeepSeekは米国企業の技術レベルに到達したことを示している。

出典: DeepSeek

オープンソース

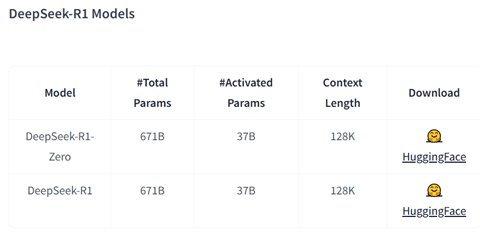
DeepSeekは「DeepSeek-V3」と同様に、「DeepSeek-R1」をオープンソースとして公開しており、これをダウンロードして利用することができる。AIオープンソースサイトHugging FaceにDeepSeek-R1が公開されており、ここからファイルをダウンロードする(下の写真)。スタートアップ企業や研究者コミュニティがR1をダウンロードして独自のモデルを生成する動きが広がっている。

出典: Hugging Face

ホスティング

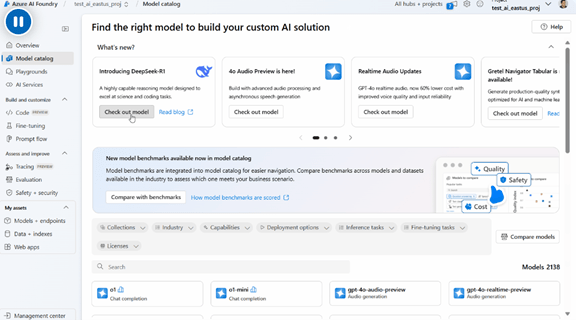
MicrosoftはDeepSeek-R1をホスティングすることを決定し、クラウド「Microsoft Azure」でこのモデルを使うことができる。MicrosoftはAIモデルの開発環境「Azure AI Foundry」を運用しており、ここでDeepSeek-R1をベースとする独自のAIアプリケーションを開発する(下の写真)。また、AmazonもAIクラウド「Bedrock」でDeepSeek-R1をホスティングすることを決定した。

出典: Microsoft

DeepSeek-R1を使ってみると

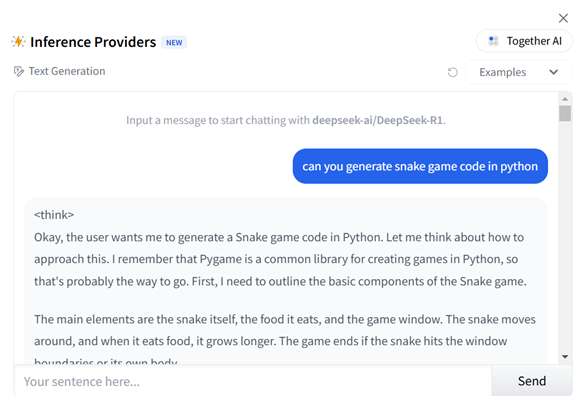
DeepSeek-R1のホスティングサイトが広がり、実際にこのモデルを使うことができる。AI開発サイトTogether AIでDeepSeek-R1を使ってコーディングすることができる(下の写真)。R1に「Snake Game」をPythonでコーディングするよう指示するとコードを生成した。様々な利用法を試してみたが、DeepSeek-R1の際立った特性として、推論の過程を出力することにあり、モデルがどうしてこの結論に達したのかを理解することができる。

出典: Together AI

開発プロセスと手順

「DeepSeek-R1」(推論モデル)は「DeepSeek-V3」(言語モデル)をベースに、これを強化学習やファインチューニングの手法で推論機能を付加する形で開発された(下のフローチャート)。実際には、DeepSeek-V3を強化学習だけでエンハンスし「DeepSeek-R1-Zero」(推論モデル・原型)を開発した(フローチャート左端)。同時に、DeepSeek-V3を強化学習とファインチューニングで改良し「DeepSeek-R1」(推論モデル・最終版)を開発した(フローチャート右端)。また、DeepSeek-R1から知識を移転する方式「Distillation」でMeta Llama 3とAlibaba Qwen 2.5を言語モデルから推論モデルに拡張した(フローチャート下段中央部)。

出典: Harris Chan

開発手法に関する疑問

開発手法が明らかになる中で、DeepSeekはOpenAIのモデルから知識をDistillation(抜き出し)したとの解釈が広がっている。トランプ政権下のAIと暗号通貨責任者のDavid Sacksは、DeepSeekがOpenAIのモデルから知識を抽出したことは明らかであると述べている。また、OpenAIは、DeepSeekがOpenAIのモデルから知識を抽出した明らかな証拠があり、調査を開始したとコメントしている。OpenAIは利用規約でAIモデルを他のモデルを開発するために使うことを禁止している。

Distillationとは

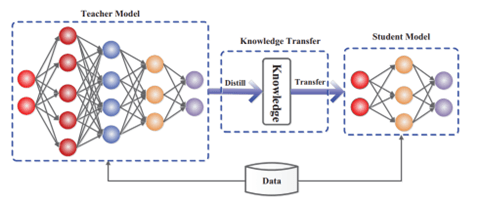
Distillationとは大規模モデルの知識を小型モデルにトランスファーする技法を指す(下のグラフィック)。大規模モデルが有している知識を抽出し、これを小型モデルに移植する方式で、短時間でモデルのスキルを向上させることができる。大規模モデルが教師モデルとなり、小型モデルの生徒モデルに知識を移転する。このケースでは、教師モデルがOpenAIのモデルで、生徒モデルがDeepSeek-R1となる。

出典: Jianping Gou et al.

グレーエリア

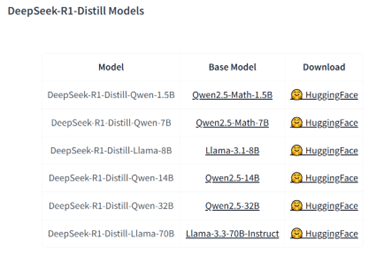
DistillationはAIモデル開発の常套手段でオープンソースのAIモデルから知識を吸収して様々なモデルが開発されている。実際に、DeepSeekは、DeepSeek-R1を教師モデルとして、「DeepSeek-R1-Distill-Llama」や「DeepSeek-R1-Distill-Qwen」を開発している(下の写真)。DeepSeek-R1の知識をMeta LlamaやAlibaba Qwenに移転したもので、元のモデルの機能を簡単にアップグレードできる。

出典: Hugging Face

フロンティアモデルの知識をどう保護する

一方、OpenAIは大規模な開発費を費やしフロンティアモデルを開発するが、この知識が吸い取られDeepSeekに移転されると、AI技術情報の転移となり、国家安全保障の重大なリスクとなる。米国政府はNvidiaのGPU最新モデルを中国に輸出することを禁止しているが、AIモデルの知識のトランスファーについては規定されていない。トランプ政権下でフロンティアモデルの安全管理についての議論が進むことになる。DeepSeekはAI開発競争から安全保障問題まで、様々な検討課題を米国にもたらした。

今年はAIエージェントがブレイク!!OpenAIは「Operator」を公開、AIが人間に代わりコンピュータを操作

OpenAIはAIエージェント「Operator」を公開した。AIエージェントとは自立的に稼働するAIモデルで、指示されたタスクを人間の介在なく実行する。Operatorは指定された条件でホテルを予約するなど出張の準備などで使われる(下の写真)。Operatorは、AIがタスクを実行する手順を計画し、それに従ってアクションを取り、目的を達成する仕組みとなる。既に、主要企業からAIエージェントが投入されているが、OpenAIはOperatorでこの市場に参入した。

出典: OpenAI

Operatorの機能概要

Operatorはコンピュータを操作するAIエージェントで「Computer-Using Agent(CUA)」と呼ばれる。Operatorは人間の指示に従って、ブラウザー上でマウスやキーボードを操作して、タスクを実行する。ホテルやフライトを予約するほかに、スーパーマーケットで買い物をするなどの機能がある。Operatorは、人間向けに構築されたウェブサイトというインターフェイスで稼働し、スクリーンを理解し、マウスとキーボードを操作して必要なアクションを実行する。

Eコマースサイトで買い物

Operatorは指示されたタスクに従ってEコマースサイトで買い物をすることができる。食料品宅配サイト「Instacart」で、指定された食料品を検索し、それらを購入することができる。例えば、「アサリのパスタを料理するために必要な食材を購入」と指示すると、Operatorは必要な食材を理解し、それをショッピングリストとして生成し、リストのアイテムをInstacartのサイトで購入する。(下の写真、右側:Instacartのサイト、左側:Operatorが実行したアクションのログ)

出典: OpenAI

Operatorの推論機能

Operatorは、指示されたタスクを完遂するための手順を設定し、それに従ってアクションを取る。人間はOperatorに命令を入力すると、その後は、AIエージェントが自律的に稼働し、人間の介在なく処理を実行する。Operatorはタスク実行のための手順「Chain-of-Thoughts」を出力し、人間はこれを見ることで作業手順を理解することができる(上の写真左側)。Operatorは実行の途中過程について、「Instacartのサイトで食材を検索」、「パスタを探しそれを買い物かごに投入」、「中型の玉ねぎを買い物かごに投入」などアクションを出力する。

トランザクションの制御

Operatorは人間の介在なく動作する構造となっているが、人間の判断が必要な時は、処理を中断し制御を人間に返す仕組みとなっている。Eコマースサイトへのログインや決済プロセスでは、Operatorは処理を中断し、メッセージを出力し、人間の判断を仰ぐ。Instacartでの買い物のケースでは、指定された商品を買い物かごに入れた後、支払い処理の段階でメッセージを出力し、人間の判断を仰ぐ。Operatorが決済処理を実行するのではなく、人間がクレジットカードで決済する設計となっている(下の写真)。

出典: OpenAI

Operatorの提携サイト

OpenAIは人気のEコマースサイトと提携しOperatorを運用している。Instacartの他に、レストラン宅配サービス「DoorDash」、レストラン予約サービス「OpenTable」、旅行予約サイト「 Priceline」、イベント予約サイト「StubHub」、配車サービス「Uber」などでOperatorを使うことができる(下の写真)。Operatorはこれら以外のサイトで稼働することができるが、アルゴリズムは提携サイトで教育され、これらのサイトでは高精度でアクションを実行する。

出典: OpenAI

Operatorの動作原理

Operatorは人間のように視覚をもち、デスクトップのスクリーンを理解し、マウスとキーボードを操作して、タスクを実行する(下の写真)。Operatorはスクリーンのピクセルを読み込み、ウェブページの内容を理解する。推論機能でタスク実行のためのステップを立案し、この計画に従って、マウスで画面をクリックし、キーボードでテキストを入力する。OperatorはGPT-4oに推論機能が実装された構造で、GPT-4oがスクリーンのイメージを読み込み、内容を理解する。

出典: OpenAI

Robotic Process Automation (RPA)との違い

ビジネスプロセスの自動化技術は数多くあり、その代表がRobotic Process Automation (RPA)で、ロボットが企業の業務を自律的に実行する。例えば、受信メールを読み込み、顧客リストを自動で生成するなど、業務を自動化するために使われている。しかし、RPAは処理プロセスを人間が事前にルールとして設定する必要がある。また、RPAはメールのように定型データを処理する構造となる。これに対し、Operatorは、人間がルールを設定する必要はなく、AIが指示されたタスクを理解し、目的完遂のためのルールを自分で設定する。また、定型データだけでなく非定型データを処理することができる。このため、Operatorは自律性が格段に向上し、応用範囲が広く、幅広い分野で活用が広がると期待されている。

AIエージェント元年

既に、Google、Microsoft、Nvidia、Salesforce、Anthropicなど主要企業はAIエージェントを開発し市場に投入している。また、スタートアップ企業はユニークなAIエージェントを開発し、利用が広がっている。OpenAIはこれら先行企業にキャッチアップする形でOperatorを投入した。AIエージェントはウェブサイトなど人間向けに設計されたインフラをそのまま利用することができ、自動化のための特別なインターフェイス(APIなど)が不要で、利用が急速に広がると予測されている。AIエージェントがブレイクする勢いを示している。

OpenAIはAI開発のブループリントを公開、米国がAI開発でリードするためにはインフラの整備が必須、独裁国家がAI開発を制することの危険性を指摘

OpenAIは今週、AI開発の計画書「Economic Blueprint」を公開した。これは米国がAI開発を推進するためのブループリントで、業界や政界に向けて様々な提言をしている。ブループリントは、米国がAI開発を主導することで、技術の恩恵を享受できるだけでなく、国家安全保障を強固にし、経済発展に寄与するとしている。特に、独裁国家(中国)がAI開発を制することの危険性を指摘し、米国が同盟国と共にAI開発をリードするための施策を提唱している。高度なAIを開発するためには、データセンタや半導体製造施設や発電所の整備が必須であるとして、国外からの投資に関する規制を緩和するよう求めている。

出典: OpenAI

ブループリントの概要

OpenAIは、AIの機能が急進する中、米国は技術の可能性を最大限にし、そのリスクを最小限にする必要があると述べている。特に、独裁国家が高度なAIの開発を主導すると、世界に重大なリスクをもたらすが、いまAI競争はこの方向に向かっている。また、AIによる大きな経済成長が見込まれ、米国はAI開発を主導すべきとしている。このためには、AI開発のインフラ整備が喫緊の課題で、データセンタ、半導体製造施設、発電所の整備が課題となる。インフラ整備には巨大な資金が必要になるが、グローバルな投資ファンドは1,750億ドルあり、米国政府はこの投資を認めるよう求めている。

出典: OpenAI Generated with DALL-E

提言の骨子

提言は三つのパートから構成され、開発競争と安全保障、AI規制、インフラ整備で、それらの具体的な内容は:

  • 開発競争と安全保障:国家安全保障の観点から米国がAI開発で世界をリードするための提言が示されている。特に、高度なモデルを開発した後で、それを運用する際の注意事項が示されている。高度なモデルが敵対国にわたり、それが悪用されるリスクを低減することが必須となる。
  • AI規制:AI規制では、AIで生成した画像の安全性を担保するよう提言している。特に、児童ポルノ(child sexual abuse material/child sexual exploitation material (CSAM/CSEM))が重大な問題で、これを規制する必要がある。また、AIで生成したイメージやビデオにはその出典を付加するメカニズムの導入を求めている。
  • インフラ整備:データセンタなどの整備に加え、公共のデータをAI開発で利用できる仕組みを導入すべきとしている。また、政府が保有している大量のアナログデータをデジタル化し、それを公開することを提言している。また、AI特区「AI Economic Zones」を設け、AI関連施設の建設にかかる認可をスピードアップすることを要請している。
出典: OpenAI Generated with DALL-E

AI規制のビジョン

OpenAIは政府のAI規制方針について言及しており、国民を守るため常識に沿ったルールの制定が必要であるとしている。同時に、規制と開発のバランスを取り、AIへの投資や競争を促すことを求めている。また、AI規制は各州が独自に実施するのではなく、連邦政府が立法化し、全米で統一したルールを制定することを求めている。一方で、州政府はAI技術の実験場としての役割を担い、州の特性を生かしたAIソリューションを展開する。例えば、カンサス州はAIを農業に適用し、農業ソリューションのハブとなる。

同盟国との連携

フロンティアモデルを米国の同盟国と共有し、域内の経済の興隆に寄与すべきとしている。半導体プロセッサの輸出を制限しているように、フロンティアモデルも同盟国への輸出は認めるが、敵対国への輸出は制限すべきとしている。フロンティアモデルが敵対国の手にわたると、これが悪用され、重大な被害が予想される。また、モデルのIPが盗用されると、敵対国で技術開発が進むことが懸念される。

出典: OpenAI Generated with DALL-E

トランプ政権への提言

OpenAIはブループリントを業界や政府関係者を対象に、AIの技術開発を促進するためのアクションを提言している。来週からトランプ第二次政権が発足するが、新政権にAI開発を後押しすることを求めた形となっている。特に、AI規制に関してはイノベーション促進とのバランスを考慮して、常識あるルールの設定を求めている。インフラ整備に関しては、外国からの投資の規制を緩和し、サウディアラビアなどからの資金を呼び込むことを意図している。巨大テック各社は既に、トランプ新大統領と面会し、個別にディールを結んでいる。OpenAIはブループリントを公開し、新政権との関係構築を急いでいる。

OpenAIは推論モデル最新版「o3」を公開、ベンチマークテストで人間のIQに匹敵する性能を達成、AGIに向けて大きく前進

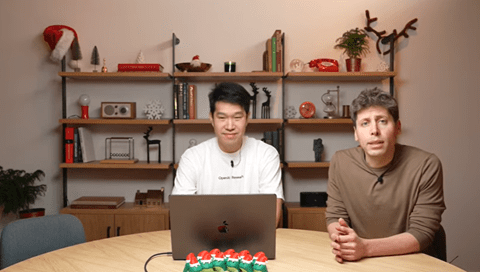
OpenAIは年末発表イベント「12 Days of OpenAI」の最終日に推論モデル最新版「o3」を発表した(下の写真)。これはイベント初日に発表された「o1」の後継モデルとなる。(「o2」をスキップした理由は通信会社テレフォニカが英国などで「O2」というモバイルサービスを運用しているため。) o3は推論機能が更に強化され、AGIのレベルを測定するベンチマークテストで人間の知能に匹敵する性能を示した。o3は安全試験を実施するために研究者に公開されたが、一般リリースは来年1月以降となる。

出典: OpenAI

推論モデルとは

推論モデルとは人間のように論理的な思考ができるAIで、与えられたテーマを分類整理して、筋道を立てて結論を導く機能を持つ。科学や数学やコーディングで高度な機能を発揮し、研究者や開発者がアシスタントとして利用する。推論モデルはインファレンスのプロセスが強化され、問われたことを即座に回答するのではなく、熟慮して最適な解を生成する。12月5日に「o1」がリリースされ、12月20日に最新モデル「o3」が発表され、OpenAIは相次いで推論モデルを投入した。

知能が格段に向上

o3の最大の特徴は知能指数(IQ、Intelligence Quotient)が大きく向上したことにある。AGIのレベルを測定するベンチマークテスト「ARC-AGI」で、o3はo1の性能を遥かに上回り、人間レベルの知能に到達した (下のグラフ:o3は黄色の丸印、o1は赤色の丸印、人間の平均は灰色の丸印・AVG MTURKERで示されている)。ARC-AGIはコンピュータ実行時間に制限(計算コストが10,000ドル以内)を設けており、「O3 LOW」はこれに沿った結果で、「O3 HIGH」はこの条件を満たさないが参考データとして表示している。O3 LOWは平均的な人間(Amazonのクラウドワーカー)の知能に匹敵し、O3 HIGHは大学卒業者レベル(Stem Graduates)の知能に迫っている。

出典: ARC Prize

ARC-AGI:知能レベルを試験するテスト

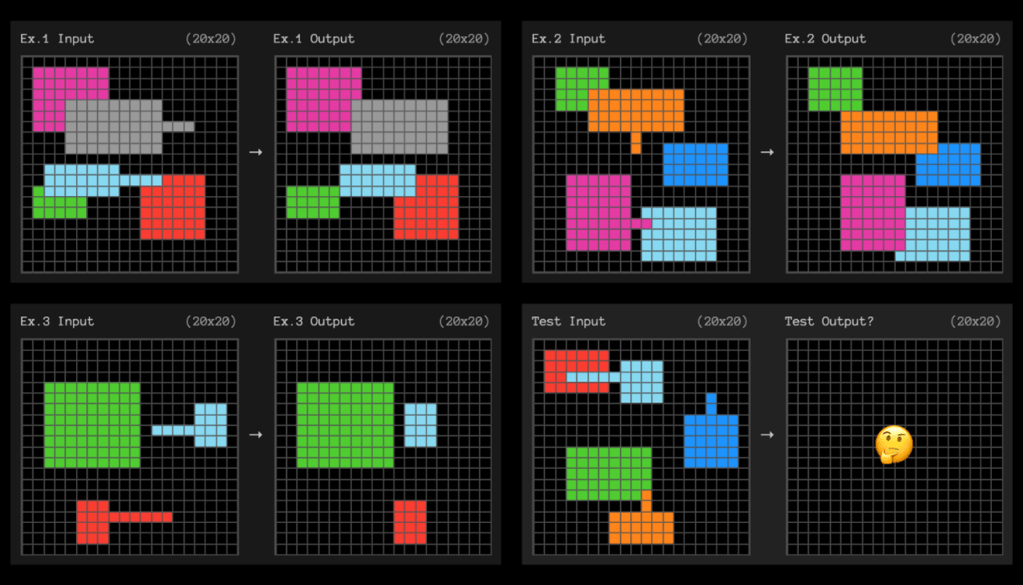
このベンチマークテストは「ARC-AGI」と呼ばれ、AGIのレベルを測定する試験となる。AIのベンチマークテストでは、言語を理解する能力や数学の問題を解く技能が評価されるが、ARC-AGIはこれとは異なり、AIの知能レベルを測定する。人間の知能指数を測定する試験に近く、知識ではなく新たな問題を解決する能力や、獲得したスキルを汎用的に応用するスキルが問われる。ARC-AGIの試験は下のグラフィックスの通りで、Ex. 1からEx. 3で示されたパターンから、そのルールを解読し、テストパターンから正解のパターンを導き出す。

出典: ARC-AGI

ベンチマークテストの結果

ARC-AGIは通常のベンチマークテストとは異なり、フロンティアモデルがどれだけAGIに近いかを測定するために使われる。通常のベンチマークテストでは、AIモデルが問題を覚えているケースが多く、機能を正しく測定できない問題が指摘されている。これに対しARC-AGIは、同じ問題を提出することはなく、全てが新規な質問で、モデルの知能を試験する。この試験でo3は好成績をマークし、モデルは新しいタスクを解く機能があることが示された。一方、o3は人間だと簡単に解くことができる問題で正解を導くことができず、AGIと認定されるには更なる開発が必要であると結論付けている。

安全評価

OpenAIはo3を発表したが、一般に公開する前に、研究者による安全試験を実施することを明らかにした。これに向けて、OpenAIは安全試験に参加する研究者を募っている(下の写真)。OpenAIは既に、外部組織と共同で「Red Teaming」という手法でフロンティアモデルの安全試験を実施している。Red Teamingは専門家がモデルを攻撃して、その問題点を洗い出す手法で、安全試験の常套手段となる。また、バイデン政権はフロンティアモデルを出荷する前に、開発企業に安全試験の実施を義務付けており、OpenAIはこの規制に準拠して、政府機関と共同で検証を進めている。

出典: OpenAI

推論モデルの開発競争が激化

OpenAIは推論モデルを相次いで投入したが、市場では競争が激化しており、会社の地位が相対的に低下している。Googleはこれに対抗して、推論モデル最新版「Gemini 2.0 Flash Thinking Mode」を試験的にクラウドで公開し、機能開発を進めている。また、Alibabaは推論モデル「QwQ」をオープンソースとして公開し、OpenAIの性能に迫っている。OpenAIはフロンティアモデルの開発で他社をリードしてきたが、他社から高性能なモデルが投入され、その実力が相対的に沈下している。