カテゴリー別アーカイブ: OpenAI

OpenAIは推論モデル正式版「o1」をリリース、考察力が格段に向上したが危険性も大きく増大、フロンティアモデルの安全性を評価する技術の開発が始まる

OpenAIはクリスマスまでの12日間に集中して新製品を発表している。初日の12月5日は、推論モデル「o1」の正式版をリリースした。o1は推論機能が格段に向上したことに加え、サイバー攻撃を防御する機能も大きく進化した。一方で、兵器を製造するスキルが大きく向上し、新たなリスクを低減するための技法が求められる。モデルのインテリジェンスが増すと新たな脅威が生まれ、推論モデルを安全に開発運用するセーフティ技術が重要な研究テーマとなる。

出典: OpenAI

システムカード

OpenAIは「o1」正式版のリリースに合わせモデルの仕様書となる「システムカード(System Card)」(下の写真)を公開した。システムカードはモデルの機能や性能を詳しく説明するドキュメントで、これが運用上の使用手引きとなる。同時に、システムカードはモデルの危険性を評価した結果を詳細に報告しており、安全技術を開発するための重要な資料となる。

出典: OpenAI

リスク評価の結果

システムカードはモデルのリスク評価を重点項目とし、その手法や結果を詳細に報告している。これによると、o1は攻撃への耐性が格段に強化され、シリーズの中で最も強固なシステムとなった。具体的には、リスク評価は下記の項目からなり、いずれの項目もo1は現行モデル「GPT-4o」の性能を上回った。

  • コンテンツ制御(Disallowed content):有害コンテンツを出力する危険性
  • ジェイルブレーク(Jailbreak):プロンプトによりシステム制御を奪う攻撃
  • 教育データの出力(Regurgitation):教育データをそのまま出力する危険性
  • ハルシネーション(Hallucination):事実でないデータを出力する危険性
  • 公平性・バイアス(Fairness and Bias):不公平でバイアスしたデータの出力
出典: OpenAI

サイバーセキュリティが向上

o1製品群はGPT-4oに比べてジェイルブレークを防御する安全機能が格段に向上した(下のグラフ)。ジェイルブレーク(Jailbreak)とは、悪意あるプロンプトを入力し、システムの制御を奪う攻撃で、AIモデルを安全に運用するための障害となっている。o1の安全機能が向上した理由は、サイバーセキュリティに推論機能が導入されたことによる。これは「chain-of-thought reasoning」と呼ばれ、問題を複数のステップに分解し、逐次的に推論を行う手法で、安全指針に沿っているかどうかの判断を的確に実行し、ジェイルブレークなどのサイバー攻撃を防御する。

出典: OpenAI

新たな危険性が生まれる

一方で、o1は兵器開発スキルなどが向上し新たな危険性が生まれた。兵器製造スキルは「CBRN」と呼ばれ、化学生物兵器や核兵器などを製造する機能を指す。敵対国がo1を悪用することで高度な兵器を開発するリスクが高まり、OpenAIなど先進企業はこの危険性を査定し、安全対策を導入する作業を進めている。

兵器製造のスキルが向上

o1のケースでは科学者など専門家がモデルを悪用して兵器開発のプロセスを効率化する危険性が高まった。o1製品群の生物兵器開発のスキルに関しては、人間のエキスパートの能力を大きく上回る(下のグラフ、人間のエキスパートのレベルは破線で、AIモデルのレベルは青丸で示されている)。このため、OpenAIはo1最新モデルに安全対策を施しこのリスクを低減した。具体的には、o1の教育データから兵器製造に関する情報を削除するなどの対策が取られた。ただし、安全対策を施したo1のリスクレベルについての情報は開示されていない。

出典: OpenAI

リスク評価フレームワーク

OpenAIはo1を含むフロンティアモデルの危険性を評価するフレームワーク「Preparedness Framework Evaluations」を制定し、安全試験を実施しモデルの危険性を評価し、それに応じた対策を講じている。評価項目は四つの分野から成り、完全試験の結果に従って、リスクレベルが格付けされる。o1は「Cybersecurity(サイバー攻撃のスキル)」と「Autonomy(自律性)」のリスクは低いと評価されたが、「CBRN(兵器製造スキル)」と「Persuasion(説得力)」のリスクが中程度となる。出荷基準は中程度以下のリスクレベルで、OpenAIはo1製品を出荷することができると判定した。

出典: OpenAI

推論モデルは危険性が向上

o1システムカードは推論機能が導入されるとモデルの機能が格段に向上するが、危険性も大きく増大することを示している。兵器開発スキルだけでなく、目的を完遂するために人間を欺くスキルも増大した。これらフロンティアモデルを安全に運用するためにはリスクを査定する試験技術と、リスクを低減する安全技術が求められる。2025年は各社からフロンティアモデルの出荷が始まるが、AIセーフティに関する研究開発が最重要テーマとなる。
OpenAIは推論モデル「o1」をリリース、GPTシリーズとは異なる製品ラインを形成、論理的な思考ができるモデルで知能が大きく向上

OpenAIは推論モデル「o1」をリリースし新たな市場を切り開いている。推論モデルとは人間のように論理的な思考ができるAIで、与えられたテーマを分類整理して、筋道を立てて結論を導く機能を持つ。科学や数学やコーディングで高度な機能を発揮するが、政治や経済など社会生活に関連する分野でも論理的な議論を展開する。GPT-4oなどGPTシリーズは汎用的な機能を提供するが、o1は複雑なタスクを実行でき科学技術分野に強みを発揮する専用モデルとなる。実際に使ってみると両者の違いが際立ち、o1はインテリジェンスが強化されていることを実感する。

出典: OpenAI

製品概要

OpenAIは推論モデル「o1-preview」とその小型版「o1-mini」をリリースした。これらは製品化前のプレビュー版で、未完成のモデルであるが推論機能を体験することができる。「o1」はGPTシリーズとは異なる新たな製品ラインを形成する。o1はインファレンスのプロセスを強化したモデルで、問われたことを即座に回答するのではなく、熟慮して最適な解を生成する。o1は複雑な問題を解決することに強みを発揮し、科学、数学、コーディングで高度な機能を示す。

推論機能を理解する

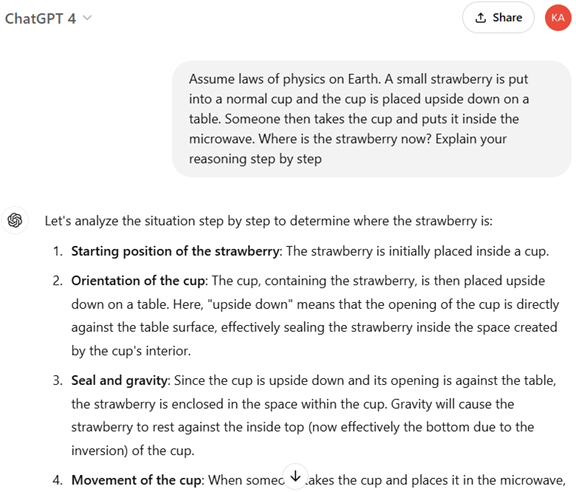
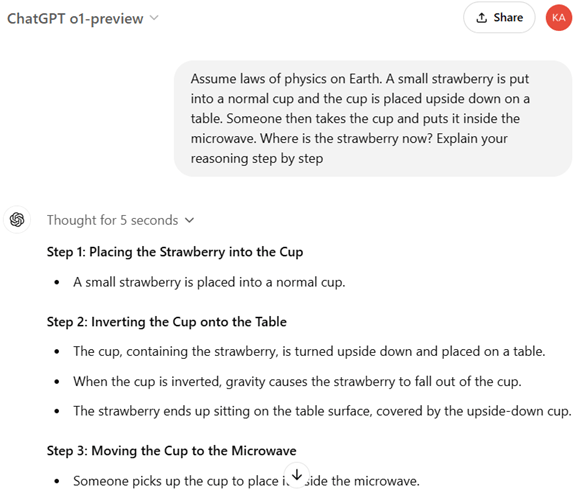
o1の基本機能は推論(Reasoning)で、問われたことを整理して、筋道を立てて解釈を進め、結論を引き出す。実際に、物理に関する問題を問うと、o1はこれを順序立てて考え解を導き出した(下の写真)。「カップにイチゴを入れて、これをひっくり返し、カップを電子レンジに入れると、イチゴはどこにあるか」との質問に、o1はこの質問をステップごとに解析し、回答にたどり着いた:

ステップ1:初期状態、カップにイチゴを入れる

ステップ2:カップをひっくり返す、イチゴはテーブルと接触

ステップ3:カップを取り上げる、イチゴはテーブルに留まる

結論:イチゴはテーブルの上にあり、電子レンジには入らなかった

o1はプロセスを順序立てて考察することで解を引き出すことができた。

出典: OpenAI

他のモデルはこの問題を解けない

この問題は人間にとっては常識であるが、大規模言語モデルはこれを解くことができない。OpenAIを含む主要企業のハイエンドモデルにこの問題を質問したが、どのモデルも正解を導くことができなかった。モデルの回答を纏めると:

  • OpenAI GPT-4:イチゴはひっくり返したカップの中にある (下の写真)
  • Google Gemini 1.5 Pro:カップをひっくり返すとイチゴはカップ内に留まる
  • Anthropic Claude 3 Opus:イチゴは重力で下に落ちるが、カップをひっくり返すとイチゴはカップ内に留まる

これらのモデルの推論の過程を検証すると、どのモデルも物理法則を理解しているが、これを実際のモデルに適用することができない。論旨は事実ではなくハルシネーションで、大規模言語モデルの限界を示している。

出典: OpenAI

言葉でコーディング

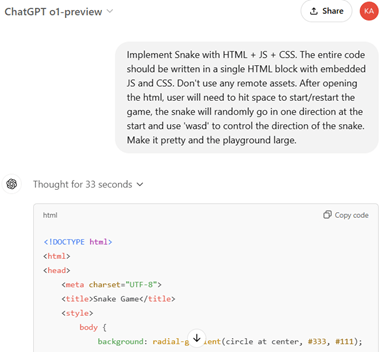
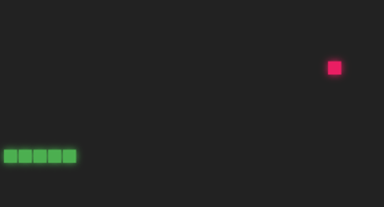
o1はコーディング機能が大きく進化し、言葉だけでプログラムを生成することができる。o1にビデオゲーム「Snake Game(ヘビゲーム)」をコーディングするよう命令すると、これに従ってプログラムを生成する。その際に、プログラム言語やゲームの仕様を指示すると、これらを正確に反映する。「Snake GameをHTMLをベースにJSとCSSでコーディングし、カーソルの操作をWASDキーで行う」と指示すると、ブラウザーで稼働するHTMLベースのゲームを生成した(下の写真上段)。これを実際にブラウザーで稼働させるとSnake Gameが起動した(下段)。

出典: OpenAI

トランプ政権の関税政策についてアドバイスを求めると

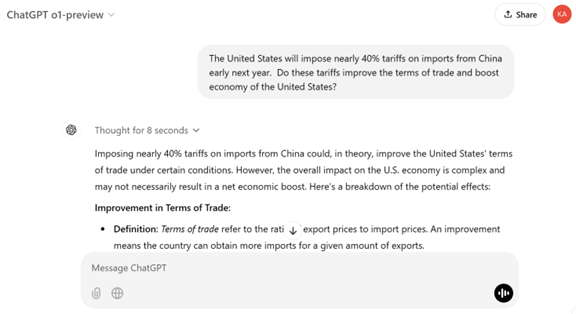
o1は政治経済に関する政策を論理的に解析する機能があり、経済政策を評価するツールとして使うことができる。トランプ次期大統領は中国からの輸入品に40%の関税を上乗せするとしており、この政策についてo1に意見を求めた(下の写真)。o1は関税の仕組みを説明し、この政策のメリットとデメリットについて評価し、結論を導き出した。米国が関税を中国との交渉の手段として使うことで、有利な条件を引き出せるが、国内で輸入品の価格が上がり、また、報復関税などデメリットが大きいと解析。o1は、関税を上乗せすることは実質的にマイナス面が大きいとして、この政策を見直すよう提言している。

出典: OpenAI

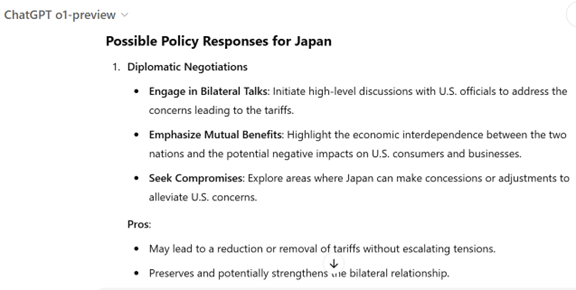
トランプ政権の関税政策に日本はどう備える

トランプ次期大統領は同盟国からの輸入品に10%から20%の関税を上乗せするとしており、o1に日本が取るべき対策について尋ねた(下の写真)。o1はアメリカの関税引き上げに対する日本が取るべき政策を10項目示し、これらのオプションを検討し多角的なアプローチが必要であると提言した。特に、外交による交渉を進めながら、他国と連携して世界貿易機関(WTO)に提訴する準備を推奨。また、(トランプ政権により日米関係は抜本的に変わるので)、新しい市場の開拓や貿易相手国を模索することも必要と助言した。

出典: OpenAI

o1の使い方

o1を使ってみると今までの大規模言語モデルとは特性が大きく異なる。従来モデルであるGPT-4oは、テキストやイメージやオーディオを生成するマルチモダルで、汎用的なプロセッサとなる。これに対し、o1は極めて高度な専門性を持ち、量子力学、遺伝子工学、ヘルスケア、経済学などの分野で複雑なタスクを実行できる。人間に例えると、GPT-4oは大学生のレベルで、o1は大学教授に匹敵し、専門分野の共同研究者として使うことができる。

推論機能を強化する手法

o1はGPT-4oなど他の言語モデルと同様にプレ教育されたモデルであるが、実行時に計算資源がアサインされ、インファレンスのプロセスを強化したモデルとなる。インファレンスの処理で即座に回答を生成するのではなく、与えられたタスクを解決するために熟慮するプロセスが追加された。具体的には、複数の解を生成し、これを検証して最適な解を選ぶ方式となる。実際に、「Snake Game」のコーディングでは、インファレンスに33秒の時間が費やされた。この方式は「Test Time Compute」と呼ばれ、実行時のプロセスが強化され、これにより高度な推論機能を得た。

大規模言語モデルの開発ペースが大幅にスローダウン!!OpenAIの次期モデルの性能が上がらない、開発戦略の見直しを迫られる

OpenAIは次期フラッグシップモデルを開発しているが、性能が上がらないという問題に直面した。次期モデルのコードネームは「Orion」といわれ、GPT-4の後継機種となる。当初は今年末までにリリースされるといわれてきたが、これが来年にスリップした。Orionは巨大なモデルであるが、規模を拡大してもそれに応じて性能が伸びない。生成AIモデルの性能が限界に達したという解釈もあり、この壁を乗り越えるためのイノベーションが求められる。

出典: Adobe Stock

OpenAIの次期フラッグシップモデル

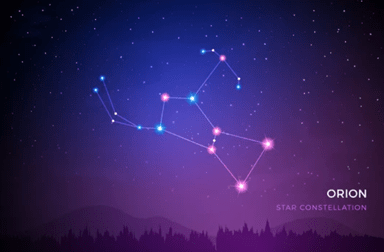
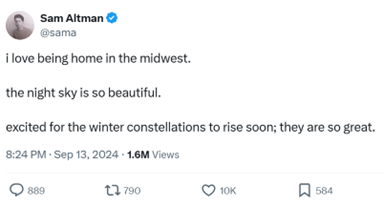
OpenAIは次期モデルについて何も発表していないが、CEOのSam Altmanはこのモデルを近いうちにリリースすると示唆している。Xに「冬の星座が近いうちに上昇する」と書き込んだ(下の写真)。冬の星座は「Orion(オリオン座)」(上の写真)であり、そのリリースが近いことを暗示している。次期モデルのコードネームは「Orion」といわれ、今年中に公開されるとみられてきた。

出典: Sam Altman

性能が上がらない

Altmanは次期モデルは博士号取得者に相当する知能を持ち、現行のGPT-4から機能が大きく飛躍すると述べてきた。しかし、次期モデルの開発は9月に完了したが、目標の性能に到達することはできず、OpenAIはこのモデルの出荷を見合わせた。アメリカのメディアが報道した。GPT-3とGPT-4の間には大きな性能差があるが、GPT-4から次期モデルの間では大きな性能の伸びを達成できなかった。

性能が伸びない原因

次期モデルの性能が上がらない原因はアルゴリズムを教育するデータといわれている。モデルのプレ教育では、ソーシャルメディアや書籍やウェブページなどをインターネットからスクレイピングして使っている。しかし、公開されているデータの量や質には限りがあり、次期モデルの開発では高品質なデータを充分収集することができなかった。特にプログラムのコーディング機能に関しては問題は深刻で、次期モデルの性能はGPT-4と大きな違いはない。インターネット上のデータを使い尽くしたとも解釈される。

研究テーマ1:教育データ

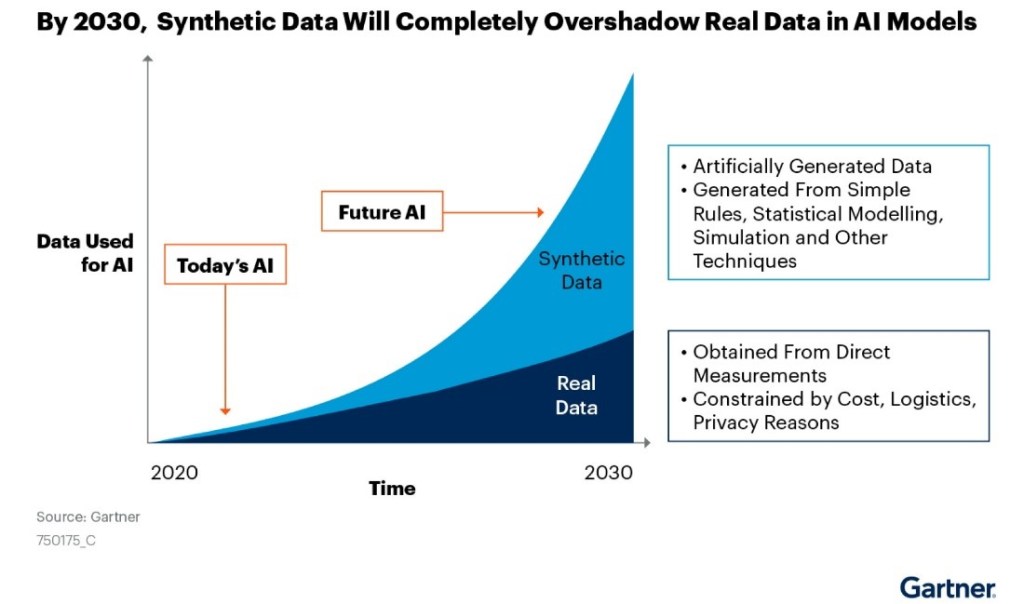
OpenAIはこの問題を解決するためチームを創設し、性能向上のための技法を検討している。最大の原因が教育データの不足で、高品質なデータを取り揃えるための技法を模索している。その一つがデータを人工的に生成する手法で、合成データ(Synthetic Data)と呼ばれる。AIモデルでデータを生成し、これを次期モデルの教育で利用する。これからのAIモデル開発では合成データが主流になるとの予測もある(下のグラフ)。また、OpenAIは主要な出版社とライセンス契約を締結しており、これらの企業から高品質なデータの供給を受ける。

出典: Gartner

研究テーマ2:ポスト教育

OpenAIはプレ教育したモデルをファインチューニング(Fine-Tuning)することで性能を改良するアプローチを研究している。これはポスト教育と呼ばれ、プレ教育されたモデルを高品質なデータで再教育することで性能を上げる。また、人間がインストラクターとなり、モデルに正しい回答を教える。この手法は「Reinforcement learning from human feedback(RLHF)」と呼ばれ、現行モデルに適用されているが、このプロセスを強化する。

ベンチャーキャピタルの評価

OpenAIだけでなく他社モデルも含めて、大規模言語モデルの性能が限界に到達したとの解釈が広がっている。大手ベンチャーキャピタルAndreessen HorowitzのBen Horowitzは大規模言語モデルがスケーリングの限界(point of diminishing returns)に到達したと述べている。プロセッサGPUの性能は定常的に向上しているが、ここで開発されるモデルの性能が伸びないことは、原因はアルゴリズムにあるとの解釈を示している。

Googleのアプローチ

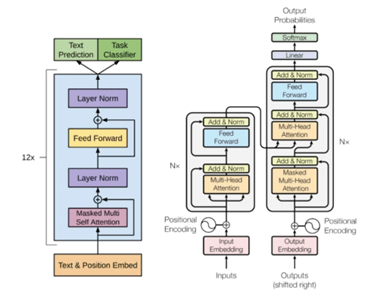
この問題に関し、言語モデル開発企業はAIモデルのボトルネックを考察し、これを改良する研究を進めている。Googleはモデルがデータから学習するメカニズムを解析し、人間のように少ないデータで効率的に学習する手法を研究している。アルゴリズムを最適化する手法は「ファインチューニング(Fine-Tuning)」と呼ばれ、プレ教育したモデルを再教育して、特定のタスクを効率的に実行させるために実施される。これに対し、Googleはプレ教育を効率的に行うため、モデルの構造自体を最適化するアプローチを取る。これは「ハイパーパラメータ・チューニング(Hyperparameter Tuning)」といわれ、トランスフォーマの構造を改良する作業となる。(下の写真、トランスフォーマの基本構造)

出典: AIMultiple

スケーラビリティの壁を乗り越える

大規模言語モデルはスケーラビリティを示してきたが、2024年は規模を拡大しても性能が伸びないポイントに差し掛かっている。この状況を打開するには、規模拡大というアプローチだけでなく、モデルの構造を最適化する手法や、ファインチューニングの新技術を模索するなど、新たな研究開発が求められる。スケーラビリティの壁を乗り越えるため、2025年はAI開発でイノベーションが求められる年となる。

半導体カンファレンス「Hot Chips 2024」:OpenAIは生成AIの機能は伸び続けると主張、次世代大規模モデルを開発するためのGPUクラスタ技術を公開

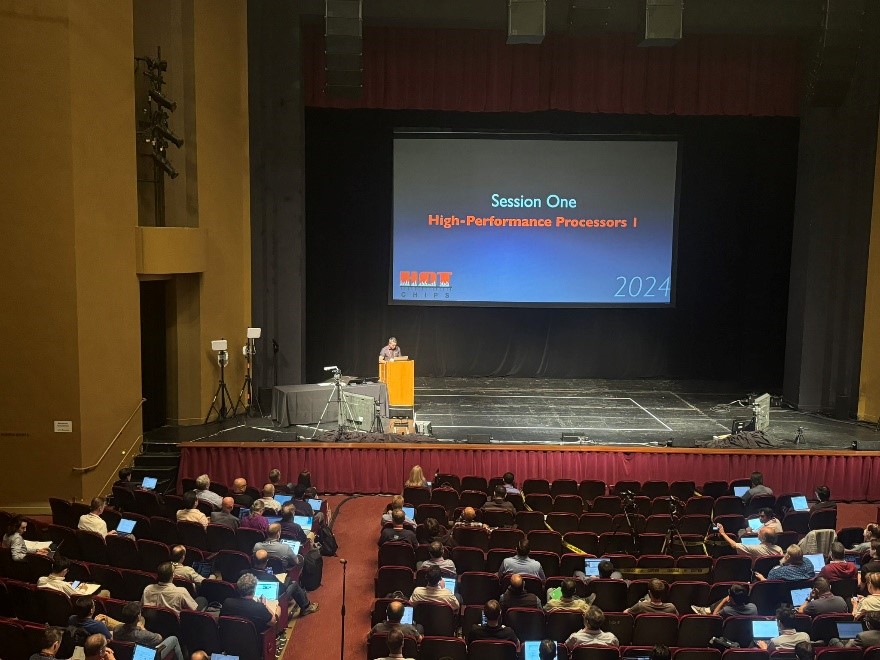
今週、スタンフォード大学で半導体カンファレンス「Hot Chips 2024」が開催され、半導体設計に関する最新技術が開示された。このカンファレンスは高性能プロセッサを議論する場であるが、今年はAI専用プロセッサに関するテーマが中心となった。OpenAIは基調講演で、大規模言語モデルのスケーラビリティ(拡張性)に関する研究を示し、モデルの機能は伸び続けると推定。次世代モデルを開発するためには巨大な計算環境が必要で、そのコアシステムとなるGPUクラスタを解説した。

出典: Hot Chips

カンファレンスの概要

「Hot Chips」は半導体設計に関するカンファレンスで、業界の主要企業が参加し、高性能プロセッサ「High-Performance Processors」を中心に新技術が議論されてきた。今年はその流れが変わり、AI処理専用プロセッサ「AI Processors」を中心に最新技術が公開された。AI処理の中でも大規模言語モデルを中心に、タスクを高速で実行するための様々なアーキテクチャが示された。生成AIのコア技術であるトランスフォーマに特化した半導体回路設計などの研究が開示された。講演の模様はライブでストリーミングされた。

AIプロセッサの市場構造

大規模言語モデル向けのAIプロセッサはGPUが標準技術として使われ、Nvidiaの独走状態が続いている。これに対して、主要各社はASIC(application specific integrated circuit、特定用途向けIC)を基盤とするAIプロセッサを開発し、GPUの代替技術となることを目指している。Googleは「TPU」を、Amazonは「Trainium」と「Inferentia」を、Microsoftは「Maia」を開発し、大規模言語モデルのアクセラレータと位置付けている。スタートアップ企業は斬新なアーキテクチャでAIプロセッサを開発し、政府研究機関などで運用が始まった。

OpenAIの基調講演

基調講演でOpenAIは大規模言語モデルのスケーラビリティと大規模システム「GPUクラスタ」に関する最新技術を公開した。OpenAIはAIプロセッサを利用する観点から、次世代大規模モデルを効率的に開発するための基盤としてGPUクラスタに関する技法を開示した。AI開発ではNvidia GPUが使われるが、これを多数連結してクラスタを構成し、次世代モデルを開発・運用する技法を開示した。

Predictive Scaling:拡張性の予測

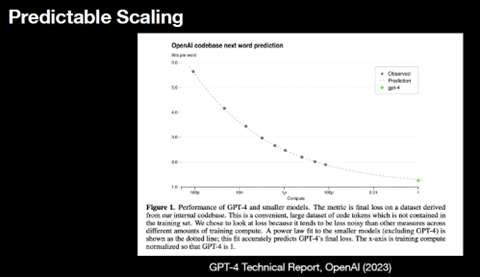
OpenAIはGPT-4など大規模モデルを開発しているが、言語モデルはこれからも機能や性能が伸び続けるとの研究成果を開示した。これは「Predictable Scaling」と呼ばれ、予測したペースで機能が拡張すると予測している。その根拠として「GPT-4」の開発事例を示し、モデルの規模を拡張すると(実行時間を長くすると)、機能が向上することを示した(下のグラフ)。小型モデル(灰色の円、実測値)を多数検証し、モデルの規模と機能をプロットすると、その延長線上にGPT-4(緑色の円、予想値)が位置し、機能はこの曲線に沿って拡大している事実を示した。

出典: OpenAI

AIモデルのスケーリング

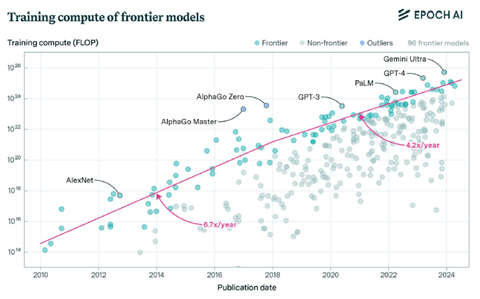
GPT-4だけでなく、他社の大規模言語モデルを検証すると、このスケーラビリティは言語モデル全般に適用できる。主要モデルの規模(教育に要した計算量)とリリースされた時期をプロットすると、フロンティアモデルを教育するためのコンピュータ規模は毎年4-5倍となっている(下のグラフ)。市場ではフロンティアモデルの性能は限界に達するとの見解もあるが、OpenAIは大規模言語モデルはこれからもこのペースで機能が伸びると予測している。

出典: OpenAI

Mass Deployment:モデルを大規模に運用

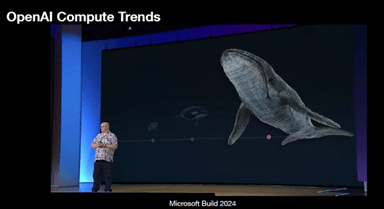
OpenAIはこの仮定に基づき、フロンティアモデルの開発では計算環境の規模を継続的に拡大する必要があり、この需要に応えるためGPUクラスタを運用している。OpenAIはGPT-4など大規模モデルの開発ではGPUサーバを大規模に結合したGPUクラスタを利用している。実際には、GPT-5の開発ではMicrosoftのアリゾナ・データセンタの計算施設を使っており、GPUクラスタのサイズは巨大で、海洋生物に例えるとクジラの大きさになる(下の写真)。

出典: OpenAI

GPUクラスタを運用する技術

GPUクラスタは巨大なシステムで、運用では様々な障害が発生し、安定的に稼働させるには高度なスキルが求められる。GPUクラスタはマクロな観点から様々な弱点があり、システム全体の信頼性(RAS:Reliability, availability and serviceability)を高めるためのスキルが必要となる。GPUクラスタで障害が発生しやすいポイントは:

  • オプティカルネットワーク:GPUクラスタのモジュールは光ケーブルで結合されるが、このオプティカルネットワークの信頼性が低い
  • 高速メモリ:高速メモリ「High Bandwidth Memory (HBM)」の信頼性が低い。HBMとは3D構造のメモリ(DRAM)で、GPUプロセッサと高速でデータ転送を行う。
  • データに内在するエラー:「Silent Data Corruptions(SDC)」という問題。SDCとはデータに内在するエラーであるが、これが検知されないままでモデルの教育が進み、完成したモデルが誤作動するという問題。データに内在する問題は出現しないケースが多く、問題の切り分けが難しく、開発者を悩ませる。

GPUクラスタの障害からの復旧

GPUクラスタでこのような問題が発生するが、システムを障害から復旧させるためのテクニックが必要となる。言語モデル開発への影響範囲を最小限に抑えることが必須要件で、そのためには復旧のシークエンスが重要となる:

  1. ソフトウェア:ソフトウェアで例外処理が発生したケースはソフトウェアを再起動する
  2. プロセス:上記の処理で問題が解決しない場合は、プロセス全体を再起動する
  3. GPU:ハードウェアレベルの障害ではGPUプロセッサを再起動する
  4. ノード:GPUクラスタを構成するノードを再起動する
  5. ハードウェア交換:GPUプロセッサなどハードウェアを交換する。影響範囲は多岐にわたりこれは最後の手段。

電力供給管理の技法

GPT-5など大規模モデルの教育では、GPUクラスタは大量の電力を消費し、これを効率的に制御する必要がある。データセンタへの電力供給量は限られており、これを各プロセスで効率的に使用する。大規模モデルの教育では、GPUクラスタの各モジュールを同期して稼働させるため、電力消費量が急上昇したり急降下することになる。このため、電力消費量を遠隔で監視する仕組み「Power Telemetry」などが必要になる。これに応じて、データセンタ内の電力配分を動的に変更する技術「Dynamic Power Sloshing」が必要となる。

生成AIモデルの成長は続く

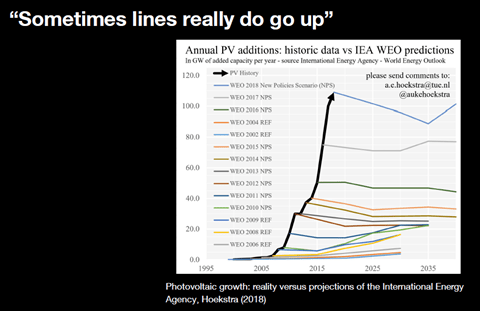
市場では、トランスフォーマの規模を拡張しても、モデルの機能や性能がこれに応じて伸びなくなる、との見解が広がっている。生成AIの成長のスピードが鈍化し、モデルは限界に達するという解釈である。これに対しOpenAIは、太陽光パネルの事例をあげ、モデルの機能や性能は恒常的に拡大するとの予測を示した。太陽光パネルの生産量は、その成長率がフラットになると予測され続けてきたが、実際には成長のスピードは加速している(下のグラフ、カラーのグラフ;予測値、黒色のグラフ;実際のトレンド)。フロンティアモデルも市場の予測に反し、成長を維持するとの予測を示した。

出典: OpenAI

次世代モデル向け計算環境

生成AIはモデルの規模が恒常的に拡大し、次世代モデルの開発では巨大な計算インフラが必要になる。また、開発した巨大モデルを稼働させるプロセス(インファレンス)においても、大規模な計算施設が必要になる。このため、プロセッサの性能を向上させるだけでなく、システム全体で障害発生率を低下させ、稼働率を向上させる技法が極めて重要となる。OpenAIは巨大モデルを開発した経験から、システム運用にかかる問題点とその改良技術を示した。

OpenAIはGPT-4oの安全試験結果を公表、人間を説得するリスクが高いが許容範囲であると判定、大統領選挙を控えフェイクボイス対策を重点的に進める

OpenAIは8月8日、マルチモダル生成AI「GPT-4o」の安全試験結果を公表した。それによると、GPT-4oは人間を説得するリスクが高いが、許容範囲内であり、安全に運用できるとの判定を下した。この安全試験は「Red Teaming」という手法で実施され、モデルが内包する重大なリスクを検証した。大統領選挙を目前に控え、GPT-4oのボイス生成機能が重点的に検証され、モデルをリリースすることに問題はないと結論付けた。バイデン政権はフロンティアモデルを出荷する前に安全試験を義務付けているが、これが実証試験となり、検証フレームワークの具体的なプロセスが明らかになった。

出典: OpenAI

GPT-4oのシステムカード

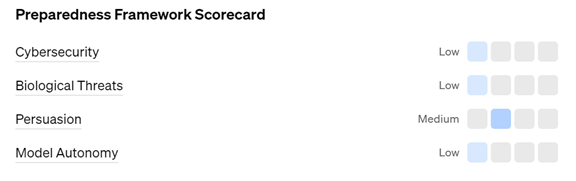
OpenAIは会話機能を持つGPT-4oの安全試験を実施し、その結果を報告書「システムカード(System Card)」として公開した。安全試験はOpenAIが定めるプロトコール「Preparedness Framework」に沿って実施され、下記の項目を評価し、その結果を一般に公表した(下の写真)。検証項目とリスクの度合いは次の通り:

  • サイバーセキュリティ:サイバー攻撃へ耐性リスク  【低い(Low)】
  • バイオサイエンス:生物兵器を開発するリスク  【低い(Low)】
  • 説得力:人間を説得するリスク  【中程度(Medium)】
  • 自律性:モデルが人間の制御を掻い潜るリスク  【低い(Low)】
出典: OpenAI

リスクの評価

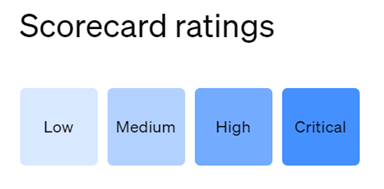
評価結果は四段階に区分され(下の写真)、それに応じた運用と開発が実施される。

  • Low:リスクは低い、運用可能
  • Medium:リスクは中程度、運用可能
  • High:リスクは高い、運用不可であるが開発を継続できる
  • Critical:リスクは極めて高い、運用も開発も停止

GPT-4oの安全試験では、評価結果は「Low」と「Medium」で、製品を運用することができると判定した。

出典: OpenAI

安全試験のプロトコール

OpenAIは「Red Training」と呼ばれる手法が使われ、専門家がハッカーとなり、GPT-4oを攻撃してその脆弱性を把握した。これらの攻撃者は「Red Teamers」と呼ばれ、100人を超える専門家で構成された。専門家は第三者組織からの人材で、45の言語と29の国をカバーする。これらRed Teamersが、GPT-4oの異なる開発段階のソフトウェア(「チェックポイント」と呼ばれる)を試験し、そのリスクを洗い出す。更に、判明されたリスクに応じてGPT-4oはファインチューニングを実施し危険性を低減する。更に、Red Teamersは最終モデルを攻撃し、出荷前の製品の安全性を確認する。

安全試験のフェイズ

具体的には、安全試験は四つのステップで構成され、GPT-4oの開発段階に沿って、その危険性を導き出す。最終段階では、iOSアプリを使い、利用者と同じ環境でリスクを洗い出す。試験ではオーディオとテキストを入力とし、GPT-4oが出力するオーディオとテキストが検証された。それぞれのステップは:

  • Phase 1:初期モデルの試験
  • Phase 2:初期モデルに安全対策を施したモデルの試験
  • Phase 3:安全対策を施した複数モデルを試験しベストのモデルを選択
  • Phase 4:iOSアプリを使い利用者と同じ環境で試験、最終モデルを特定

ボイス生成機能を重点的に検証

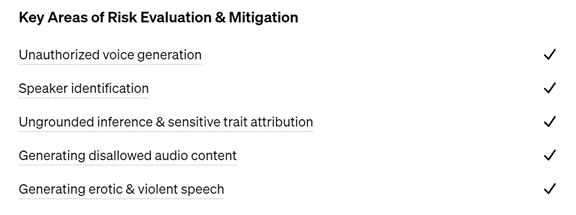
GPT-4oの試験ではオーディオに関連するリスクをが重点的に試験された(下の写真)。GPT-4oは多彩な表現でリアルタイムに会話する機能を持つが、この機能はリスクが大きくまだリリースされていない。モデルの公開に先立ち、OpenAIはRed Teamingの方式で会話機能が内包するリスクを特定し、その安全対策を実施した。具体的には、GPT-4oはシステムが提供するボイスだけを許容し、著名人の音声などフェイクボイスの生成を抑止する。

出典: OpenAI

フェイクボイスの生成

GPT-4oはマルチモダルの生成AIで、入力されたオーディオとテキストの指示に従って、人間の声を生成することができる。これは「Synthetic Voice」と呼ばれ、モデルが人間が喋る音声をハイパーリアルに生成する。しかし、この技法が悪用されると、GPT-4oが著名人のフェイクボイスを生成し、これが拡散すると社会に重大な危険性をもたらす。GPT-4oは高度なマルチモダル機能を持ち、様々なサウンドを創り出すが、この一つが人間のボイスとなる。実際に、Red Teamingでこの危険性が確認され、OpenAIはGPT-4oが生成するボイスの種類を制限し、更に、生成されたボイスをフィルタリングする機能導入し、フェイクボイスの生成を抑止している。

大統領選挙を目前に控え

大統領選挙を目前に控え、OpenAIはGPT-4oの機能の中でフェイクボイスを生成する機能を重点的に検証した。実際に、他社のモデル「ElevenLabs」が悪用され、バイデン大統領のフェイクボイスが生成され、有権者に虚偽の情報が配信された。OpenAIはこれらを教訓にオーディオ技術を中心に安全対策を実施している。

出典: Adobe Stock

出荷前の安全試験

バイデン政権の大統領令は開発企業に対し、フロンティアモデルを出荷する前に安全試験を実施することを求めている。GPT-5からこの規制が適用され、GPT-4oはこの対象外であるが、OpenAIはこの安全試験を事前に実施し、本番前のトライアルとなった。安全試験の結果、GPT-4oのリスクの度合いは「Medium」以下であり、安全に利用できると判定した。今年後半には各社からフロンティアモデルがリリースされると噂されており、大統領令の規定に従い安全試験が実施されることになる。