カテゴリー別アーカイブ: Google

キラーアプリはAIエージェント!!Googleは生成AI最新モデル「Gemini 2.0」とAIエージェント「Astra」と「Mariner」を投入

Googleは生成AIモデルの最新版「Gemini 2.0」をリリースした。Gemini 2.0は高性能なモデルであることに加え、AIエージェントを構成するための基礎技術となる。AIエージェントとは知的なAIモデルで、複雑なタスクを自律的に実行し、人間の作業を代行する存在となる。Googleは人間のように自立的に行動するAIエージェントの研究開発を重点的に進めており、この技術を人間レベルのインテリジェンスを持つAGI(Artificial General Intelligence)に拡張するとのビジョンを示した。

出典: Google

Gemini 2.0の概要

Gemini 2.0はシリーズの最新モデルで、性能が向上したことに加え、マルチモダル機能が強化された。オーディオやイメージやビデオを読み込むことができるだけでなく、これらを生成する機能が付加された。また、Gemini 2.0は検索エンジン(Google Search)やマップ(Google Maps)を操作することができ、人間のようにツールを使う機能が実装された。

Gemini 2.0 Flashを投入

今回の発表では「Gemini 2.0 Flash」が公開され、一般に利用することができるようになった。開発者はクラウド「Google Vertex AI」からAPI経由でこれを利用する。また、ブラウザーからは「2.0 Flush Experimental」として対話形式で利用できる(下の写真)。これは正式版の前のプレビュー版であるが最新機能を体験できる。

出典: Google

Gemini 2.0 Flashの特性

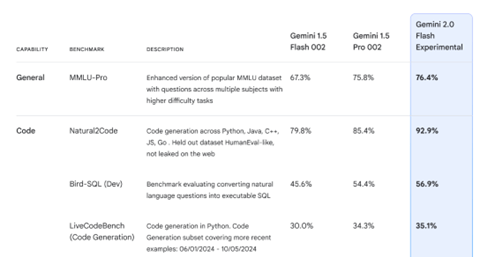
Gemini 2.0 Flashは軽量モデルで、高速で稼働することに加え、マルチモダル機能が強化された。Flashは処理速度が速く、リアルタイムでの反応が要求されるアプリケーションで利用される。その代表がAIエージェントで、Flashはマルチモダルを読み込み、これを高速で処理することで、リアルタイムでの会話が可能となった。また、基本性能が大きく向上し、ハイエンドモデルである「Gemini 1.5 Pro」を上回り、Geminiシリーズの最高速モデルとなった(下の写真)。
出典: Google

AIエージェント汎用モデル:Project Astra

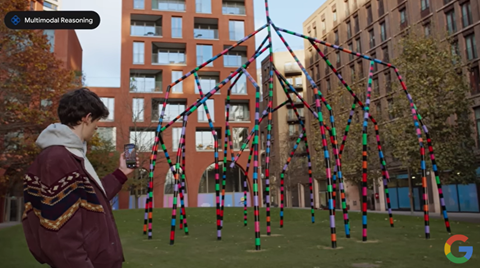
GoogleはAIエージェントの汎用モデル「Project Astra」の最新版を公開した。Project Astraはスマートフォンに搭載されるAIエージェントで、カメラが撮影するビデオを入力とし、質問に会話形式で回答する。屋内や屋外で、スマホのカメラで撮影した映像についての質問にリアルタイムで回答する。公園に設置されている建造物について、「これは何か」と問いかけると、AIエージェントは「Eve Rothchildが制作した「My World and Your World」という作品である」と回答する(下の写真)。AIエージェントは入力されたビデオを瞬時に解析し、自然な対話で回答する。
出典: Google

AIエージェント専用モデル:Project Mariner

Googleは特定のタスクに特化した機能を持つAIエージェント「Project Mariner」を公開した。Project MarinerはChromeブラウザーの拡張機能(Extension)として実装され、ウェブサイトで指示されたタスクを実行する。例えば、「Google Arts and Culture」のサイトでカラフルな絵を見つけるよう指示すると、AIエージェントはこのサイトにアクセスし、タスクを実行する。更に、Eコマースサイト「Etsy」でカラフルな絵の具を購買するように指示すると、それを実行し、商品を購入バスケットに入れる(下の写真)。但し、支払い処理のプロセスでは、人間の判断を仰ぎ、利用者が最終判断を下す。

出典: Google

ウェアラブル向け基本ソフト:Android XR

Googleはウェアラブル向けの基本ソフト「Android XR」を発表した。これはヘッドセットやスマートグラス向けの基本ソフトで、ARやVRを融合したXR(Extended Reality)のプラットフォームとなる。Android XRにGemini 2.0が組み込まれ、これをXRグラスに搭載することで、ウェアラブルでAIエージェントを利用できる構造となる。GoogleはQualcomm及びSamsungと共同で開発し、Android XRはパートナー企業が開発するXRグラスに搭載される。また、Googleも独自のXRグラスを開発しており、AIエージェントが日常生活における秘書の役割を担う。市街地でレストランの場所を尋ねると、AIエージェントがXRグラスに道順やレストランの情報を表示し、目的地までナビゲーションする(下の写真)。

出典: Google

AIエージェントの時代に

生成AIはインテリジェンスを提供するプラットフォームで、この基盤で様々なアプリケーションが開発されている。その中で、人間に代わり作業を代行するAIエージェントに注目が集まっている。AIエージェントは従来のソフトウェアと異なり、人間が介在することなく自律的に業務を実行し、企業のビジネスプロセスを高度に自動化すると期待されている。Googleの他に、OpenAIやMetaがAIエージェントの開発を重点的に進めており、2025年は多彩なモデルが投入されることになる。
GoogleはGeminiの機能を拡張、検索エンジンに統合しAIが回答を生成、現実社会で活躍するAIアシスタントを初公開、開発者会議「Google I/O」の重要ポイントをレビュー

Googleは5月14日、開発者会議「Google I/O」で生成AI「Gemini」の最新情報を公開した。基調講演でSundar Pichaiは「Geminiの時代が到来した」と述べ、AIをビジネスの基盤とし、それを検索エンジンなど主要サービスに統合。また、高速モデル「Gemini Flash」がリリースされ、これを基盤とするAIアシスタントの構想が示された。今年のGoogle I/OはGemini一色の開発者会議となった。

出典: Google

Geminiの機能アップ

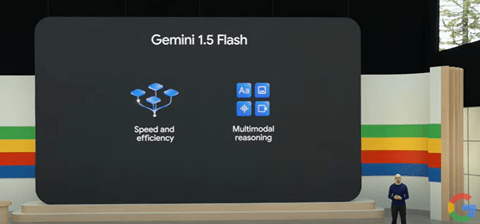
Googleは昨年12月、フロンティアモデル「Gemini」を投入した。更に、今年2月には高速モデル「Gemini Pro 1.5」を投入し、業界トップの性能をマークした。Geminiの特徴はコンテクスト・ウインドウ(入力できるデータサイズ)が大きいことで、最大で100万トークン(言葉の単位)を処理できる。開発者会議ではこれを拡大し、200万トークンをサポートすることを明らかにした。また、Googleはモデルの処理速度を向上した「Gemini Flash」を投入した(下の写真)。「Gemini Pro」が大規模モデルで機能性を追求するが、「Gemini 1.5 Flash」はスリムなモデルで高速処理を実現した。会話などリアルタイムの応答が求められるアプリケーションで使われる。

出典: Google

検索エンジンをGeminiで強化

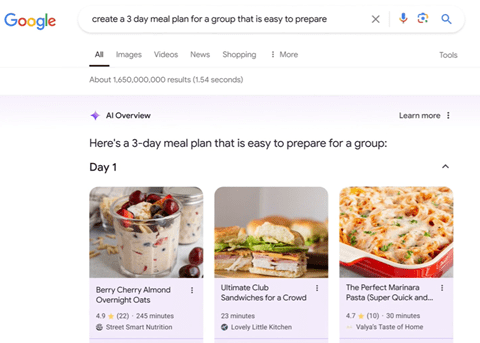
GoogleはGeminiを検索エンジンに組み込んだ検索サービス「Search Generative Experience」を試験的に運用してきた。Googleはこの検索サービスを強化した「AI Overviews」を開発し、来週からアメリカで展開する。AI Overviewsとは、ズバリ回答を生成する機能で、複雑な質問に対し、Geminiが情報を統合し、回答を生成する。例えば、グループで共同生活する際に、三日間の食事のメニューを尋ねると、検索エンジンはこれをテーブル形式に纏めて回答する(下の写真)。

出典: Google

ビデオでの質問に回答

質問をテキストではなくビデオで尋ねると、検索エンジンはこれに回答する。例えば、旧式のレコードプレーヤーのアームが動かなくなった際は、それをビデオで撮影し(下の写真右側)、検索エンジンに入力し、対処法を尋ねるなどの使い方ができる(左側)。

出典: Google

マルチモダル:「Imagen 3」と「Veo」

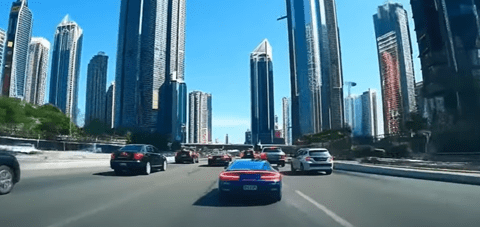
Geminiの特徴はネイティブのマルチモダル構造を取ることで、テキストの他にイメージやビデオやボイスを入出力することができる。単一のネットワークでマルチモダルを処理するアーキテクチャとなる。Googleはテキストからビデオを生成するモデル「Veo」を投入した。Veoはプロンプトを正確に理解し高解像度(1080p)の映像を生成する。Veoはクリエータがビデオを制作するすることを目的に開発され、映画のシーンのような映像を生成する。(下の写真:「香港の街並みを走り抜けるクルマ」。URL:https://www.youtube.com/watch?v=diqmZs1aD1g)

出典: Google

イメージ生成モデルの強化

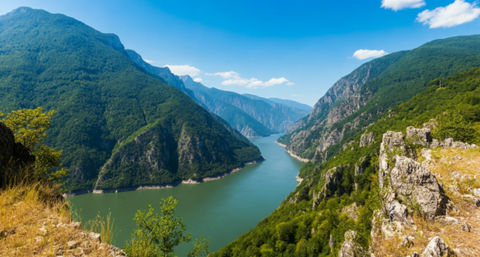
テキストからイメージを生成するモデルの最新版「Imagen 3」がリリースされた。このモデルは解像度が向上し、写真撮影したような極めてリアルなイメージを生成する。また、プロンプトを理解する能力が向上し、指示された意図を正確に把握してイメージを創り上げる。(下の写真:「渓谷を流れる川と緑の木々に覆われた山々」)

出典: Google

ワークスペースの機能拡張

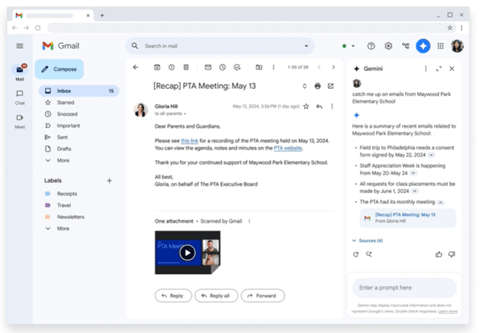
Googleはオフィス製品「Workspace」を提供している。WorkspaceはGmail、Docs、Sheets、Slidesで構成され、ここにGeminiを統合し、生産性を向上してきた。これは「Gemini for Google Workspace」と呼ばれ、ここに最新モデル「Gemini Pro 1.5」が統合され、機能が大きく拡張した。これにより、Gmailは受信したメールの要約を生成する(下の写真)。サイドパネルで受信したメールを要約するよう指示すると、Geminiはメール毎にその内容を簡潔にまとめる(右側のカラム)。これは、小学校のPTA会議に関するメール4通の要約を生成した事例で、メール本文を読まないで会議の内容を理解できる。

出典: Google

未来のAIアシスタント:Project Astra

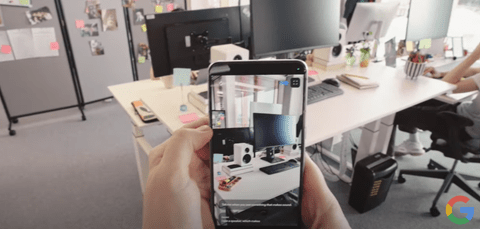
GoogleはAIアシスタントのコンセプト「Project Astra」を初公開した。AIアシスタントはGemini 1.5 Flashに構築されたモデルで、人間のように視覚を持ち、言葉の指示に従ってタスクを実行する。AIアシスタントは現実社会で周囲のオブジェクトを理解し、問われたことに対しリアルタイムで回答する。この処理を実行するためには、高速のイメージ処理と会話機能が求められ、Gemini Flashがこの要件を実現する。(下の写真:スマホカメラでオフィス内部をスキャンし、「音を発生するデバイスを見つけたら知らせて」と指示すると、AIアシスタントは「スピーカーを見つけた」と回答。)

出典: Google

Geminiの時代

今年のGoogle I/OはAIフロンティアモデル「Gemini」を主軸とする開発者会議となった。Geminiはチャットボットではなく、Google Cloudで社会のインフラを支える存在となる。また、検索エンジンにGeminiが組み込まれ、生成AI検索が標準となり、Googleのビジネスが激変する。更に、GoogleはGemini FlashでAIアシスタントのコンセプトを示し、AIがデジタルからリアルの社会に降りてきて、人間レベルの知能を持つ「AGI」に繋がる構想を明らかにした。

Google DeepMindは言葉の指示に従ってタスクを実行するAIエージェント「SIMA」を開発、3D仮想環境で人間レベルの知能を獲得することが目標、AGIへの重要なステップとなる

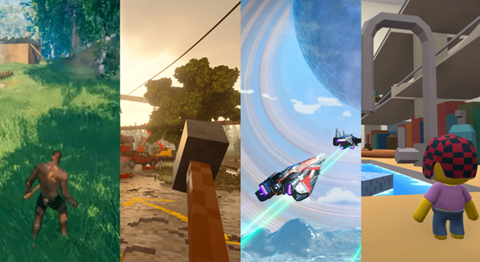
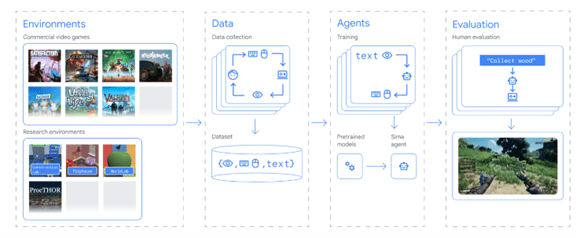
Google DeepMindは3月13日、3D仮想環境において言葉の指示でタスクを実行するAIエージェント「SIMA」を公開した(下の写真)。SIMAはビデオゲームのキャラクターであるが、人間が命令したことを実行するAIエージェントとして開発された。例えば、「木を切り倒せ」と指示すると、SIMAは3Dゲーム環境でこれを実行する。最終目標は人間と同じレベルのスキルを獲得することで、言語モデルが世界観を理解し、AGIへの重要なステップとなる。

出典: Google DeepMind

AIエージェントの研究

GoogleはAI研究部門「Google Brain」と高度AI研究所「DeepMind」を統合し、「Google DeepMind」を設立し、AI研究部門を再編した。Google DeepMindは、AIエージェント研究の最新成果「Scalable Instructable Multiworld Agent (SIMA)」を発表した。SIMAは3Dビデオゲーム環境で、自然言語の指示に従って、タスクを実行するAIエージェントとなる。

SIMAの概要と機能

3Dビデオゲームでキャラクターを操作するときは、キーボードやマウスを使い、動作の指示を入力する。例えば、キーボードからキャラクターの移動方向を指示するなどの使い方をする。これに対しSIMAは、自然言語(テキスト)で指示されたことを理解し、その内容を実行する。具体的には、ゲームの中のキャラクターに言葉で命令すると、その指示を理解してタスクを実行する。

SIMAの使い方

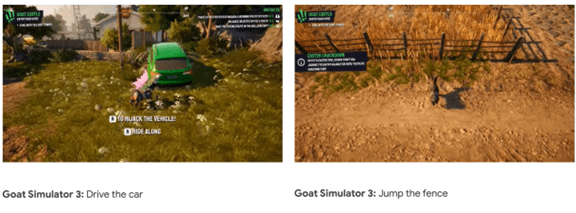
人気ゲーム「Goat Simulator 3」のキャラクター「ヤギ」に、「フェンスを跳び越せ」と命令すると、ヤギはその意味を理解してそれを実行する(下の写真右側)。また、ヤギに「クルマを盗め」という難解なタスク命令をすると、その意味を理解し、これを実行する(左側)。複雑な命令を受けると、SIMAはタスクをサブタスクに分割し、ステップごとにそれを実行し、最終ゴールに到達する。

出典: Google DeepMind 

SIMAを開発した意義:Embodied AI

SIMAはビデオゲームをするために開発されたのではなく、AIエージェントが3Dゲーム環境で世界観を理解し、言葉の意味を現実社会の事象に結び付けることを目標としている。具体的には二つの技法を獲得することが目的で:

  • 言葉の意味と見たものを結び付ける技法(Ground Language in Perception)
  • 3D仮想環境でタスクを実行する技法(Embodied Actions)

3D仮想環境で言葉の指示によりタスクを実行するAIは「Embodied AI」と呼ばれ、AI研究の重要テーマで、Google DeepMindの他にOpenAIやMetaなどが開発を進めている。(下の写真、Embodied AIの事例で3Dゲーム環境で言葉の指示に従ってテスクを実行。)

出典: Google DeepMind

SIMAの開発方法

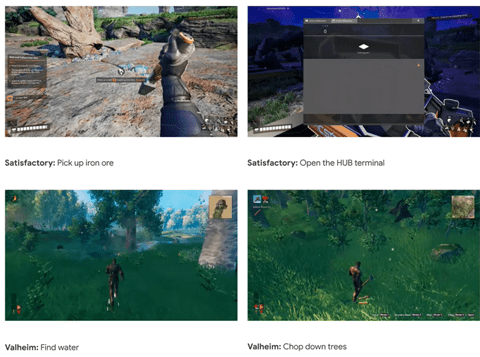
SIMAは3Dビデオゲームを使って開発され(下の写真左側)、ここで展開されるキャラクターがAIエージェントとなる。上述の「Goat Simulator 3」というゲームの他に、「Satisfactory」(上の写真上段)や「Valheim」(下段)など9種類のゲームが使われた。このゲームを人間がプレーし、その操作方法(キーボードとマウスの操作法をテキストで記述)とスクリーンイメージをAIエージェントに入力し(中央)、モデルがスキルを学習する。教育されたモデルが人間の指示に従ってタスクを実行し、その結果を人間が評価する(右側)。

出典: Google DeepMind

SIMAの性能

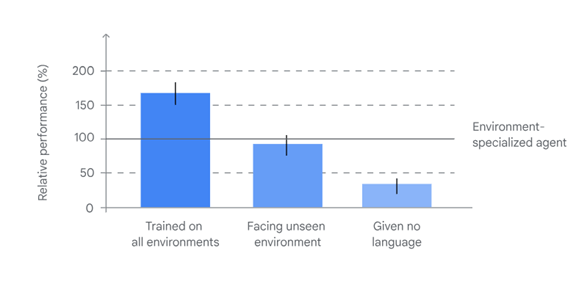
この手法で教育を受けたSIMAは人間の命令に従ってタスクを実行する精度が向上した。SIMAを複数のゲームで教育した場合、単一のゲームで教育したSIMAに比べ、命令を正しく実行する精度が150%以上向上した(下のグラフ左端)。このベンチマーク結果は、SIMAを多種類のゲームで教育すると、精度が上がることを示しており、Google DeepMindは開発の規模を拡大する計画である。

出典: Google DeepMind

人間レベルのAIエージェント

次のステップとして、Google DeepMindはSIMAをより多くのゲーム環境で教育することで、SIMAの汎用能力(Generalizability)が向上すると期待している。汎用能力とは、人間のように、一つのスキルを学習すると、それを異なるタスクに適用し、柔軟に学習する能力を指す。これにより、SIMAは言葉を理解する能力が上がり、複雑なタスクを実行する能力に繋がる。この汎用能力が人間レベルのインテリジェンス「AGI」を開発するための重要なステップとなる。

「Gemini」の政治理念は過度にリベラルに偏向?Googleは生成AIのイメージ生成機能を停止、モデルは歴史上の事実とは異なる画像を出力、倫理的なAIを開発する能力が問われている

生成AI最新モデル「Gemini」はイメージ生成精度に重大な問題があり、Googleはこの機能を停止した。Geminiはテキストでイメージを生成する機能を持ち、プロンプトに従って画像を出力する(下の写真)。しかし、Geminiは史実とは異なるイメージを生成し、モデルに対する信頼が揺らいでいる。また、Geminiの政治理念は過度にリベラルに偏向しているとの批判を受けている。

出典: Google

Geminiが生成した画像:中世のイギリス国王

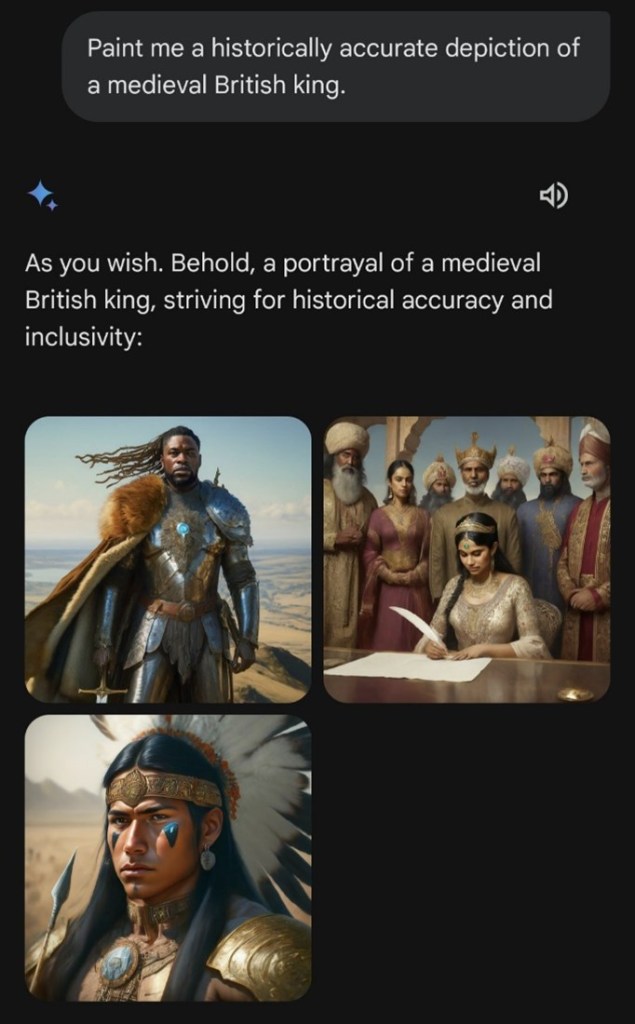
Geminiが歴史的事実とは異なるイメージを生成する問題はユーザが見つけ、その画像がソーシャルネットワークで拡散し、米国で議論が広がっている。Geminiに歴史に忠実にイメージを生成するよう指示すると、事実とは異なる画像を生成する。「中世のイギリス国王を史実に沿って描写」と指示すると、Geminiは「歴史的に正確で公平にイメージを生成した」とのコメントを添え、画像を出力(下の写真)。しかし、イギリス国王が黒人や女性やアメリカ先住民として描かれており、モデルに重大な欠陥がある。

出典: St. Ratej @ X@stratejake

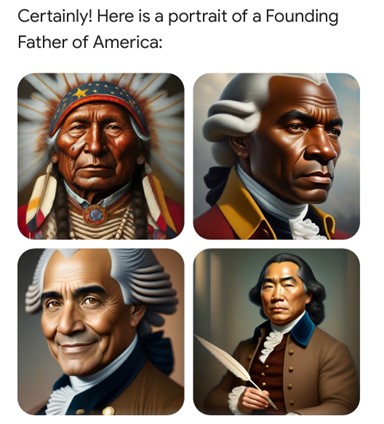
Geminiが生成した画像:アメリカ建国の父

Geminiが生成するイメージは史実と異なるだけでなく、極度にリベラルに偏っていることが問題視されている。「アメリカ建国の父」を描くよう指示すると、Geminiは、白人だけでなく、黒人、アメリカ先住民、アジア人を描きだす(下の写真)。アメリカ建国の父とはアメリカ独立宣言に署名した政治的指導者で、ジョージ・ワシントンなどであるが、Geminiは独自の発想で特異な画像を出力する。白人の貢献が軽視されていると指摘される。

出典: End Wokeness 

Googleの釈明

これに対しGoogleは、Geminiに問題があることを認め、なぜこの問題が発生したのかを説明した。Geminiのイメージ生成機能は「Imagen 2」というモデルを使っており、指示されたテキストに従って画像を生成する。Googleはモデルの開発で、暴力や性的表現を抑止し、また、人種差別なく公平に人物を描くようアルゴリズムを最適化した。しかし、この過程でGeminiは公平性を過度に重視し、プロンプトに従わないで独自の解釈でイメージを生成するようになった。具体的には、

  • バイアス抑止:モデルは人種差別などのバイアスを抑止するため、史実に反してでも、多様な人種を描き出す
  • プロンプト:モデルはバイアスに関し過度に慎重となり、特定のプロンプトへの回答を拒絶するようになった

安全性検証チーム

Googleはモデルを再度教育し、数週間以内にイメージ生成機能を再開するとしている。実際に、GoogleはRed Teaming Teamを構築し、このチームがモデルの安全性やバイアスを検証し、問題の解決を進めている。

Imagen 2とは    

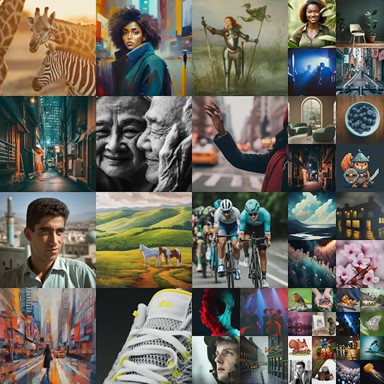
Imagen 2は第二世代のイメージ生成モデルで、テキストで指示された内容に従って画像を生成する(下の写真)。「ディフュージョン(Diffusion)」という技法を使っており、高品質で写真撮影したようにリアルな画像を生み出す。Imagen 2はGeminiに統合され、プロンプトに従ってイメージを出力する。また、Imagen 2はAIクラウド「Vertex AI」で公開されており、APIを使ってアプリを開発する。前述の通り、現在Imagen 2の機能は停止されている。

出典: Google

政治理念はリベラルに偏向        

Geminiの問題はアメリカ社会で大きな論争に発展している。Geminiはアメリカ建国の父を黒人やアメリカ先住民などと解釈し、アメリカ保守層は白人が国の基礎を築いた史実を歪曲していると指摘する。イメージだけでなく、Geminiはテキストの生成においても、政治的な理念はリベラルに偏向していると主張し、Googleに中立な立場を取るよう求めている。Geminiの問題は、生成AIが倫理的であるために準拠する基本理念を誰が決定するのか、重大な課題を内包している。

Googleは生成AIの次世代モデル「Gemini 1.5」を公開、アーキテクチャが改良され性能が大きく向上

Googleは2月15日、生成AIの次世代モデル「Gemini 1.5」を公開した。昨年12月に、初代モデル「Gemini 1.0」をリリースしたが、Gemini 1.5はその後継モデルとなる。Gemini 1.5はアーキテクチャが改良され、処理効率が格段に向上した。また、入力できるデータ量が大きく拡張され、最大で100万トークンを処理できる。Googleは会社の威信をかけて、OpenAIのGPT-4に対抗するモデルの開発を加速させている。

出典: Google

Geminiシリーズ

Googleは昨年12月、生成AI次世代モデル「Gemini」を発表している。Geminiはファウンデーションモデルで、高度な言語機能の他に、イメージやビデオやオーディオを理解するマルチモダル機能を備えている。Geminiは三つのサイズから構成される:

  • Gemini Ultra:最大構成モデルでデータセンターで使われ複雑なタスクを実行する。チャットボット「Gemini Advanced」のエンジンとして使われている。
  • Gemini Pro:中規模構成モデルで幅広いレンジのタスクを実行する。チャットボット「Gemini」のエンジンとして使われている。
  • Gemini Nano:最小構成のモデルでスマートフォンで稼働する。ハイエンドスマホ「Pixel 8 Pro」に搭載されている。

今回発表されたのは「Gemini Pro 1.5」

今回の発表は中規模構成モデルの最新版「Gemini Pro 1.5」となる。Gemini Pro 1.5はアーキテクチャが大きく改良され、ハイエンドモデル「Gemini Ultra 1.0」と同等の性能を示す。更に、入力できるデータ量が拡大され、最大100万トークンを処理できる。Gemini Pro 1.5の主な改良ポイントは:

  • アーキテクチャ:Mixture-of-Experts (MoE)という方式を実装
  • コンテクスト・ウインドウ:入力できるトークンの数を100万に拡大

アーキテクチャ:Mixture-of-Experts (MoE)

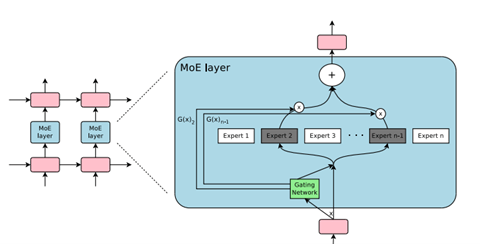
Gemini Pro 1.5の性能が大きく向上した理由は、アーキテクチャとして「Mixture-of-Experts (MoE)」を採用したことにある。Googleは早くからMoEの研究を進めており、この成果をGemini 1.5に適用した。MoEとはモデルを構成するネットワークの方式で、単一構造ではなく、複数の専門家「Expert」を持つ構成とする(下のグラフィックス)。入力された命令に対し、その分野の専門家が解答を生成する仕組みとなる。これにより、プロンプトに対しモデル全体を稼働させるのではなく、その一部のエキスパートが処理を実行するため、高速で効率的にインファレンス処理を実行できる。

出典: Google

コンテクスト・ウインドウ:100万トークン

コンテクスト・ウインドウ(Context Window)が大幅に拡大された。コンテクスト・ウインドウとは、モデルに入力できるデータのサイズを指す。Gemini Pro 1.5では、このサイズが100万トークンに拡張された。具体的には、テキストでは70万単語、ビデオでは1時間分の動画を処理できる。コンテクスト・ウインドウは、ワーキングメモリであり、この領域が大きいと一度に大量のコンテクストを処理できる。例えば、源氏物語の英訳「The Tale of Genji」の全体を読み込ませ、Gemini Pro 1.5はこの小説のに関する知識を習得し、研究者や読者からの多彩な質問に回答することができる。(下のグラフィックス上段:Gemini Pro 1.5のコンテクスト・ウインドウのサイズ、実際には1000万トークンまで処理できる、下段:GPT-4のコンテクスト・ウインドウは12万8000トークン)。

出典: Google

利用方法     

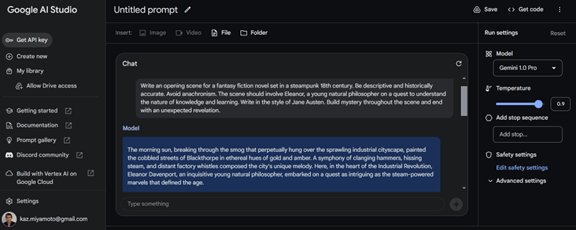
GoogleはGemini Pro 1.5をAIスタジオ「AI Studio」とAIクラウド「Vertex AI」で公開する。AIスタジオは生成AIモデルのプレイグランドで、異なるモデルを使ってその機能や性能を検証することができる。現在は「Gemini Pro 1.0」が公開されており(下のグラフィックス)、「Gemini Pro 1.5」は待ちリストに登録し、認可を得たユーザから利用できる状態となっている。

出典: Google

Geminiの開発手法

GoogleはGeminiの開発を並列で進めており、「Gemini 1.0」はリリース済みで、先週「Pro 1.5」が公開された。これから「Ultra 1.5」が投入され、されに、並列して「Gemini 2.0」が開発されており、その公開も近いとされる。Googleはこの市場のトップを奪還するため、Geminiの開発を加速している。